建立: 2026-09-05 | 补图与扩写: 2026-09-07 | 定位: 长期参考,面试 / 训练调参双用途
适用: 已经会用 torch.optim.AdamW 但说不清"为什么是它"的阶段
配图说明:本文 12 张图全部由 images/optimizers/make_figures.py 真实计算生成——每条曲线、每个数字都是跑出来的,不是示意。图里出现的所有数值都可以用那个脚本复现。
这份文档怎么用
不要顺序读完就算了。骨架是一条推导链 + 两个统一视角 + 五条分支:
- 先读 第 1–3 章(根问题、统一模板、最速下降视角)。这三章是根因体系,读完之后所有优化器都变成"同一个模板填不同的空"。时间只够读一部分就读这三章。
- 第 4 章是主干推导链(GD → Adam),每一步都写明"上一个方法的哪个具体失效被修掉了"。
- 第 5–6 章是 Adam / AdamW 的细节纠错区,专治"会用但说不清"。里面有三处是我自己原先记错、被数值实验推翻的。
- 第 7 章是五条分支,是当代论文所在的位置。
- 第 8 章是系统视角(显存账、通信、kernel、schedule),跟推理 / 训练系统方向直接相关。
- 第 10 章是自检 26 问,第 11 章是动手练习(代码自己写,这里只给验收标准)。
文中标 [争议] 的是学界尚无定论的解释,别当结论背。标 ⚠️ 的是我实际踩过或数值验证过的反直觉点。
0. 先看全局:一张谱系图
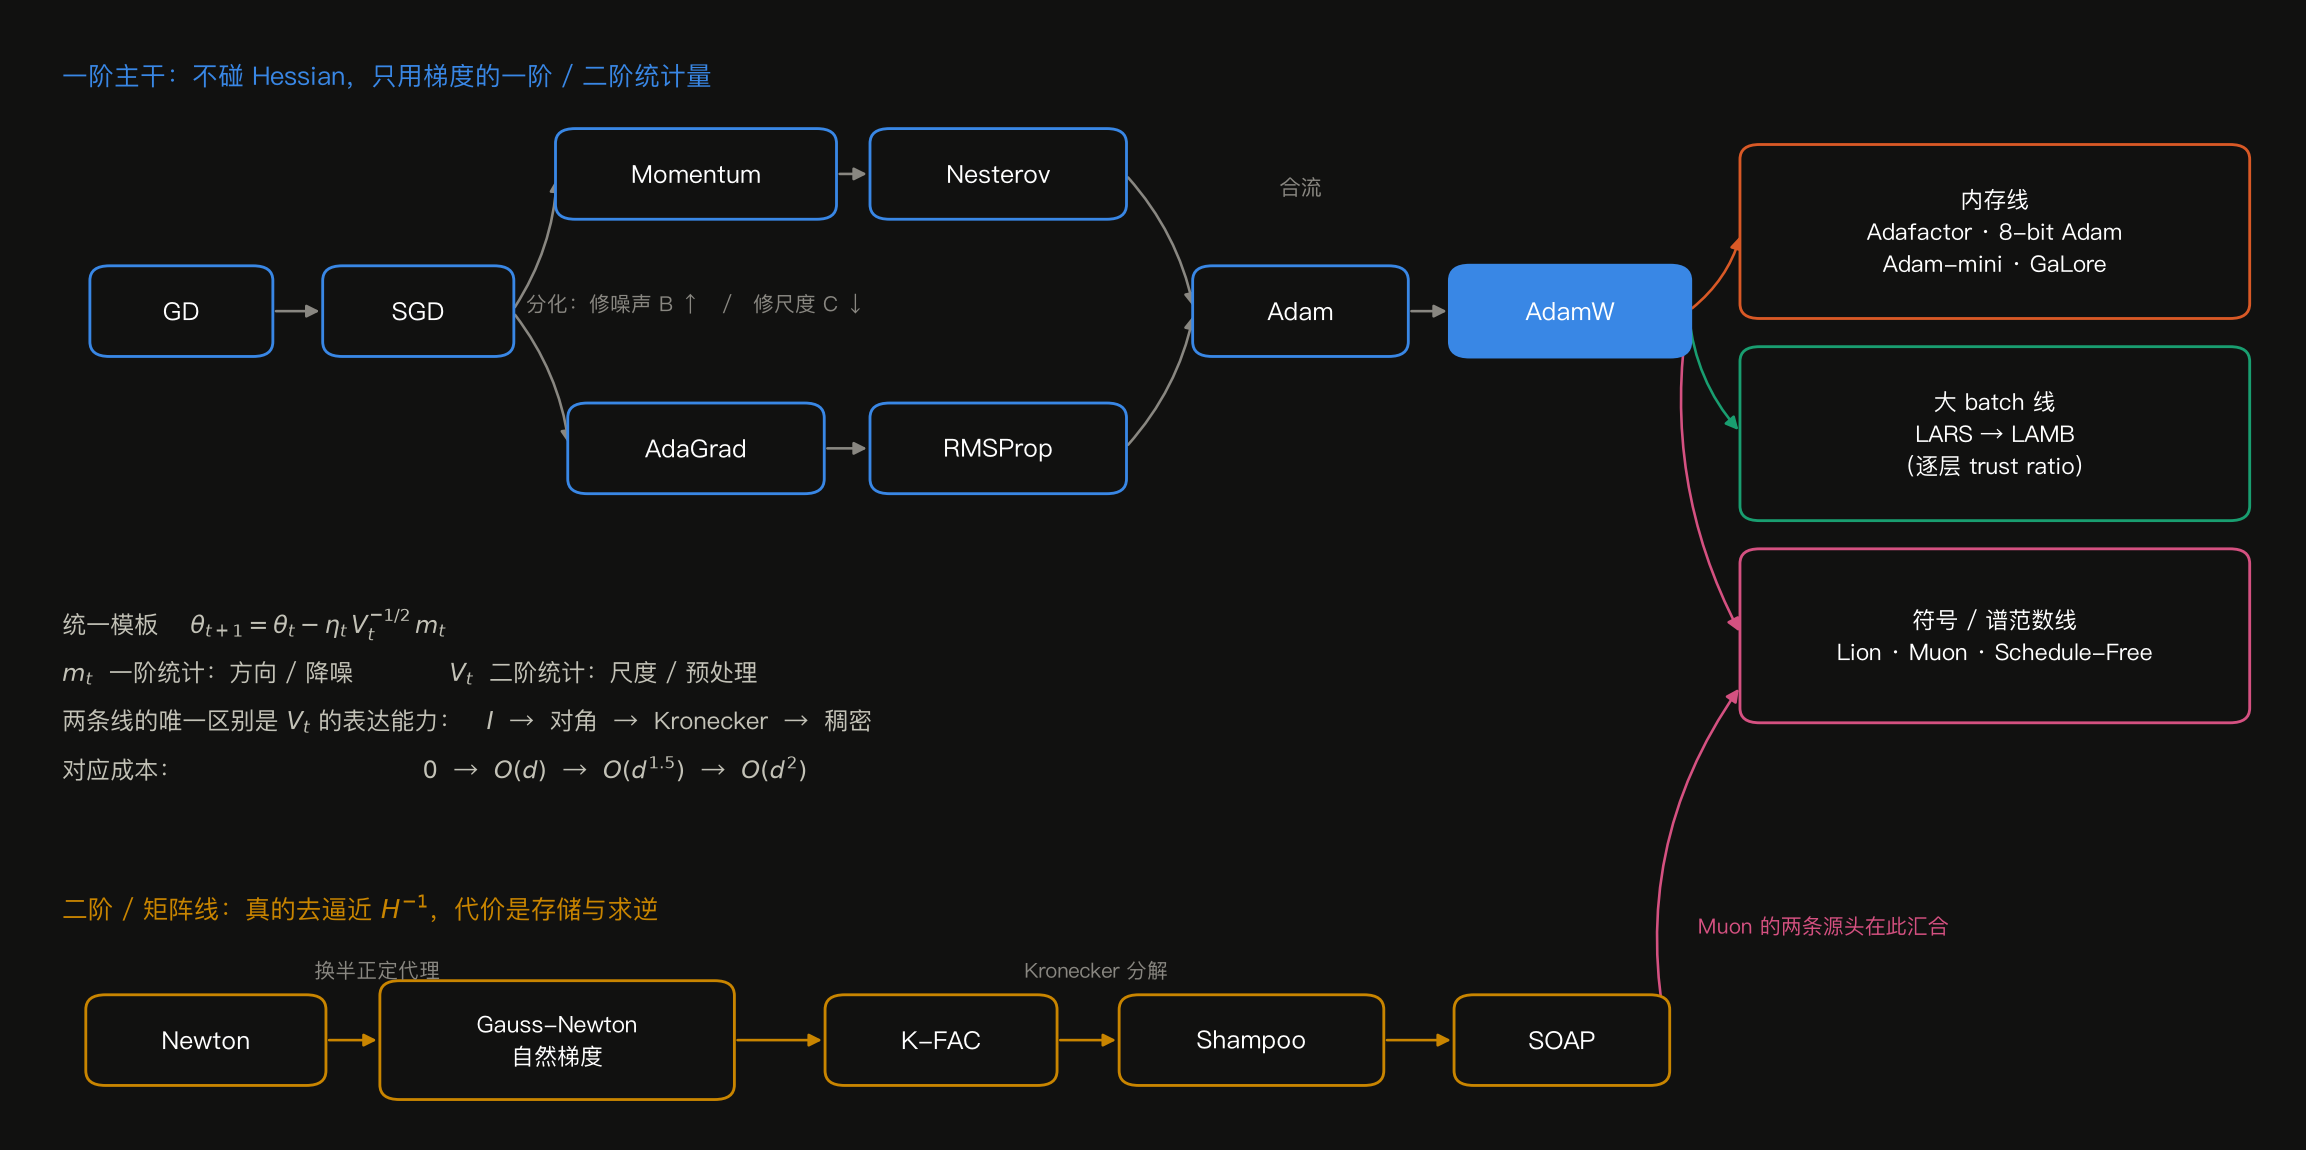
这张图有三个信息值得先记住:
- Adam 是两条独立支线的合流产物,不是某个人一拍脑袋的组合:动量支线在修噪声,AdaGrad 支线在修尺度,Adam 把两者叠起来。
- 二阶线不是一阶线的延伸,是平行的另一条源头。Shampoo 的祖先是 Newton,不是 Adam。搞混这一点就理解不了 Muon 为什么"看起来像 Adam 但推导完全不同"。
- 五条分支的动机彼此正交:省内存 / 撑大 batch / 逼近曲率 / 换范数 / 去掉 schedule。看一篇新优化器论文,第一件事就是判断它落在哪条分支上。
1. 根问题:优化器到底在解决什么
1.1 表面问题与真实问题
表面问题:“最小化 $L(\theta)$"。这句话没有信息量——它不能解释为什么会有几十种优化器。
真实问题是:朴素梯度下降在深度学习的实际条件下有三个相互独立的失效模式,每个优化器都是针对其中一个或几个的修补。
| 失效模式 | 具体表现 | 主要修补手段 |
|---|---|---|
| A. 病态曲率 (ill-conditioning) | 损失面在不同方向的曲率差几个数量级,步长被最陡方向卡死,最平方向几乎不动 | 预处理(AdaGrad / Adam / Shampoo)、动量 |
| B. 随机噪声 (stochasticity) | mini-batch 梯度是带方差的估计,方差 $\propto \sigma^2/B$,直接用会来回震荡 | 动量(时间平均)、大 batch、学习率衰减、权重 EMA |
| C. 尺度异质性 (scale heterogeneity) | 不同参数块的梯度量级差几个数量级(embedding vs LayerNorm gain vs attention 投影),单一全局学习率无法同时适配 | 逐坐标 / 逐层自适应(Adam、LARS / LAMB) |
记住这个三分法。 后面每讲一个优化器,都先问"它修的是 A、B 还是 C”。绝大多数混乱来自把这三件事搅在一起讲。
1.2 失效模式 A 的定量刻画(这段值得手推一遍)
取最简单的二次损失 $L(\theta)=\tfrac{1}{2}\theta^\top H\theta$,$H$ 对称正定,特征值 $\lambda_1 \ge \cdots \ge \lambda_d > 0$。定义条件数 $\kappa = \lambda_1/\lambda_d$。
在 $H$ 的特征基下,梯度下降 $\theta \leftarrow \theta - \eta H\theta$ 在每个坐标上完全解耦:
$$\theta_i^{(t+1)} = (1-\eta\lambda_i)\,\theta_i^{(t)}$$于是三个结论一步就出来:
- 稳定性约束:要求所有 $|1-\eta\lambda_i| < 1$,即 $\eta < 2/\lambda_1$。最大曲率方向单独决定了步长上界,跟其他方向想不想要大步长毫无关系。
- 收敛速度:最慢的是 $\lambda_d$ 方向,收缩因子 $1-\eta\lambda_d$。代入 $\eta$ 的上界,这个因子 $> 1 - 2/\kappa$。
- 最优步长 $\eta^\star = \frac{2}{\lambda_1+\lambda_d}$ 时,收敛率是 $\frac{\kappa-1}{\kappa+1}$,需要 $O(\kappa\log\frac{1}{\epsilon})$ 步。
把三种方法放在同一个 $\kappa=100$ 的二次型上真跑一遍:
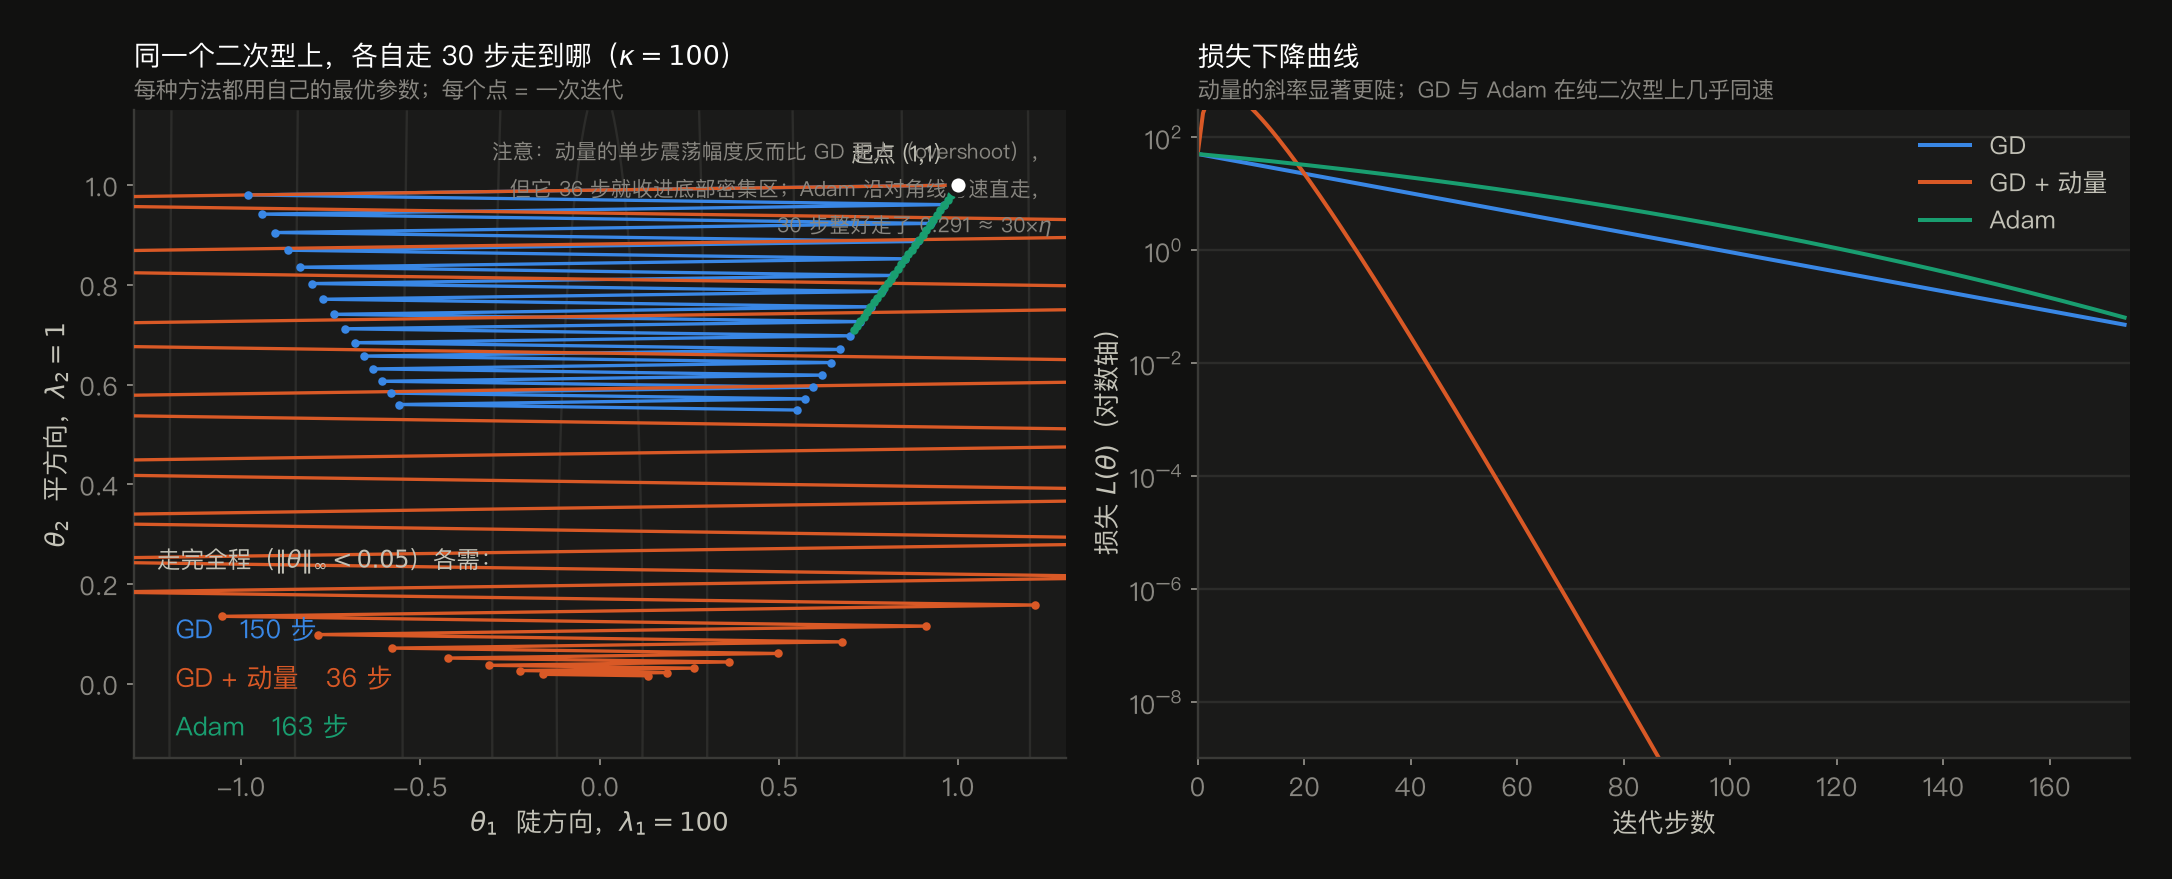
⚠️ 这张图有两处反直觉,都是我原先预估错、被实际模拟纠正的:
- 动量的单步震荡幅度比 GD 更大,不是更小。 常见的教科书插图给人的印象是"动量把锯齿抹平了",实际在最优参数下 heavy ball 会 overshoot,扫出比 GD 更宽的范围。它赢在收敛快(36 步 vs 150 步),不是赢在"不震荡"。
- Adam 在纯二次型上并不比 GD 快(163 步 vs 150 步)。这不是 bug,见下一张图。
把条件数扫一遍,三条曲线的斜率就是三个复杂度:
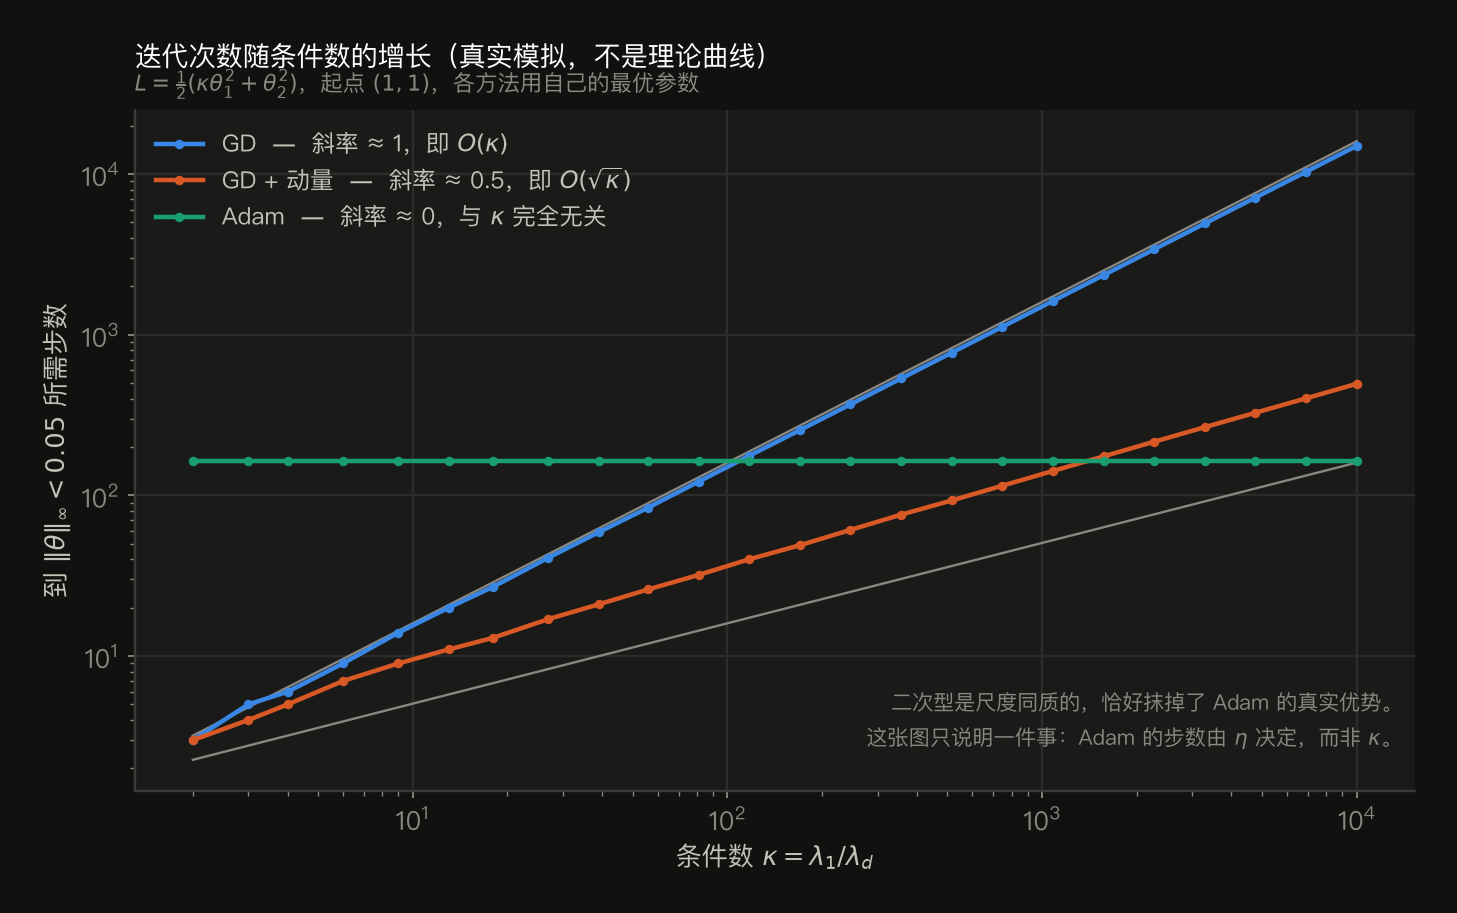
| 方法 | 迭代复杂度 | 每步成本 | 图上的斜率 |
|---|---|---|---|
| GD | $O(\kappa\log\frac{1}{\epsilon})$ | $O(d)$ | 1 |
| GD + 动量 | $O(\sqrt{\kappa}\log\frac{1}{\epsilon})$ | $O(d)$ | 0.5 |
| Adam | 与 $\kappa$ 无关,由 $\|\theta_0\|_\infty/\eta$ 决定 | $O(d)$ | 0 |
| 牛顿法 ($P=H^{-1}$) | 二次型上一步到位 | $O(d^3)$ | — |
动量把条件数开了个方,牛顿法把条件数变成 1,而 Adam 干的是另一件事:它把"迭代次数"从曲率问题变成了距离问题。 那条水平线是第 3 章 $\ell_\infty$ 最速下降视角的直接实验证据——Adam 每步每个坐标恰好走 $\eta$,所以步数只取决于要走多远。
必须同时说清这张图的局限:二次型是尺度同质的(所有坐标共享同一个 Hessian 特征基和量级),恰好抹掉了 Adam 的真实优势。 Adam 在 transformer 上碾压 SGD 的原因是失效模式 C,而二次型里没有 C。用这张图论证"Adam 不如动量"是错的。
1.3 但真实网络的 Hessian 不是常数:progressive sharpening 与 edge of stability
1.2 把 $H$ 当成固定矩阵,这是所有经典分析的前提,也是它跟真实训练脱节的地方。真实深度网络里:
- Hessian 的谱是极端重尾的:绝大多数特征值挤在 0 附近,少数几个(数量级与类别数 / 输出维度相关)远远突出,此外还有负特征值(非凸)。所以"条件数"这个词严格说不适用——$\lambda_d$ 可能是 0 或负数。实践中说的 $\kappa$ 都是指有效谱段。
- $\lambda_1$ 会随训练自己变。Cohen et al.(ICLR 2021)的观察分两段:训练早期 $\lambda_1$ 持续上升(progressive sharpening),一直升到 $2/\eta$——也就是 1.2 推出的那个稳定边界——然后就卡在那里不动了(edge of stability),损失在小尺度上非单调震荡但整体继续下降。
这个观察的含义很重:不是你根据 Hessian 去选 $\eta$,而是你选了 $\eta$,网络自己把 Hessian 调整到与之匹配的锐度。 于是"学习率"的真实身份不是"步长",而是"允许网络进入多锐的区域"——这也是学习率影响泛化的一条通路。
Cohen et al.(2022)把这个现象扩展到了自适应方法(“Adaptive Gradient Methods at the Edge of Stability”):对 Adam,卡住的量不是 $\lambda_1(H)$ 而是预处理后的锐度 $\lambda_1(P^{-1}H)$,平衡点大约在 $38/\eta$(论文给出的经验常数,不是定理)。
这一节的实践价值:看到 loss 在小尺度上持续锯齿但整体下降,不要急着调小学习率——那可能就是 edge of stability 的正常形态,而非"不稳定"。真正需要干预的是 spike(见 9.4)。
1.4 失效模式 B 的定量刻画:梯度噪声尺度与临界 batch size
失效模式 B 通常被讲成一句定性的"batch 太小噪声大",其实它有很干净的定量模型(McCandlish et al. 2018,“An Empirical Model of Large-Batch Training”)。
定义梯度噪声尺度 $B_{\text{noise}}$:它衡量"梯度里噪声与信号的比例",量纲是 batch size。核心结论是一条 Pareto 前沿:
$$\left(\frac{S}{S_{\min}}-1\right)\left(\frac{E}{E_{\min}}-1\right)=1$$其中 $S$ 是达到目标损失所需的优化步数,$E$ 是所需的样本总量(= $S \times B$)。等价形式:
$$\frac{S}{S_{\min}} = 1 + \frac{B_{crit}}{B}, \qquad \frac{E}{E_{\min}} = 1 + \frac{B}{B_{crit}}$$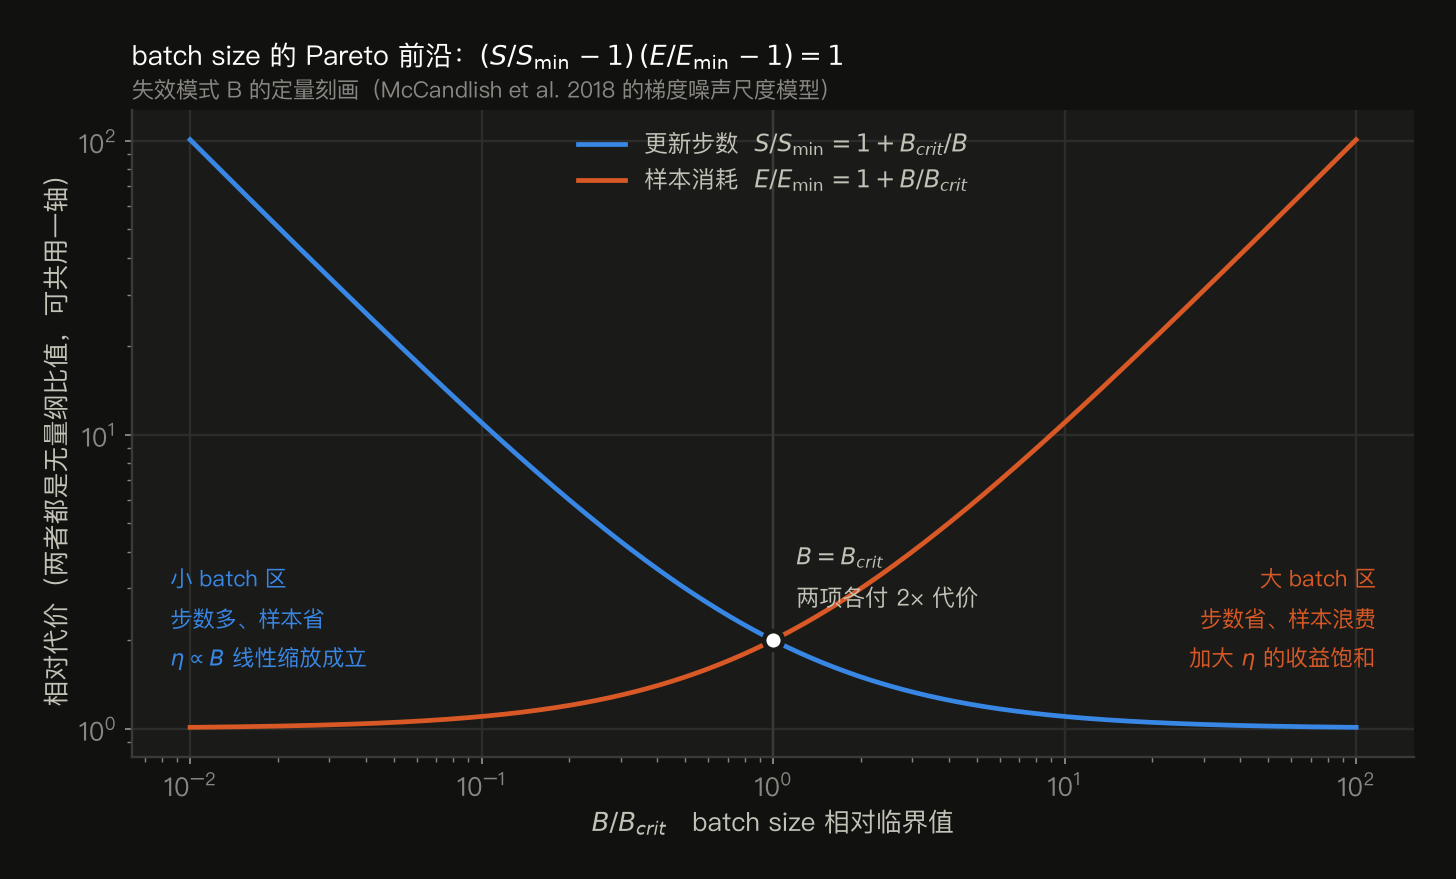
这张图一次说清了三件平时靠口传的事:
- 为什么线性缩放规则 $\eta \propto B$ 只在小 batch 区成立:$B \ll B_{crit}$ 时噪声主导,加倍 batch 就把噪声减半,可以放心加倍学习率;$B \gg B_{crit}$ 时梯度已经接近真梯度,再加 batch 不减噪声,学习率也就涨不上去了(此时经验规律更接近 $\eta \propto \sqrt{B}$ 甚至完全饱和)。
- “临界 batch size"不是硬墙而是拐点:$B = B_{crit}$ 时步数和样本各多付一倍,这是效率上的甜点区,不是能力上限。
- $B_{crit}$ 随训练进行而增大:训练后期梯度信号变小,噪声占比升高,所以 $B_{crit}$ 上升——这是大模型训练里"batch size ramp-up”(前期小 batch、后期加大)这个做法的理论依据。
1.5 失效模式 C:尺度异质性到底有多大
C 是 Adam 在 transformer 上不可替代的真正原因,但它最难被讲清楚,因为它是个经验事实而非定理。要点:
- 同一个 transformer 里,
wte(词嵌入)、ln_f.weight(最后的 LayerNorm gain)、attn.c_proj.weight、lm_head这几类参数的梯度范数常常差几个数量级,而且这个差距在训练全程持续存在。 - 更麻烦的是这个差距不是各参数块内部均匀的:embedding 矩阵里高频 token 对应的行梯度密集,低频 token 的行几乎收不到梯度(回到了 AdaGrad 2011 年的原始动机)。
- SGD 只有一个全局 $\eta$:迁就大梯度块就学不动小梯度块,迁就小梯度块就把大梯度块炸掉。逐坐标归一化不是优化技巧,是这个架构下的必需品。
这一节我故意不给具体数字——因为我没有在自己的模型上量过,而抄别人论文里的数字对建立直觉没用。这是练习 5,量完再回来填。
1.6 一句话总结整个领域
所有优化器设计,都在回答同一个问题:如何在不付出 $O(d^2)$ 存储 / $O(d^3)$ 计算的前提下,尽可能逼近 $H^{-1}$(或 Fisher 矩阵 $F^{-1}$)的作用。
这句话是整张地图的中轴线。把优化器按"预处理器的表达能力 vs 成本"排成一维谱:
表达能力弱 ────────────────────────────────────────────────► 表达能力强
成本低   ────────────────────────────────────────────────►   成本高

  P = I          P = diag(d)        P = A⊗B (Kronecker)      P = H⁻¹
  SGD            AdaGrad            Shampoo / SOAP           Newton
  Momentum       RMSProp            K-FAC                    自然梯度(精确)
  Lion           Adam / AdamW       Muon(谱范数正交化)
                 Adafactor

  O(0) 状态      O(d) 状态          O(d^1.5) 状态            O(d²) 状态
2. 统一模板:所有一阶优化器的同一个骨架
任何一个主流优化器都可以写成下面四步。背这个模板,不要背单个算法。
第 1 步  取梯度:        g_t = ∇L(θ_t)                      [+ 可选:裁剪]
第 2 步  一阶统计(方向):m_t = φ(g_1, ..., g_t)             [降噪,对付失效模式 B]
第 3 步  二阶统计(尺度):V_t = ψ(g_1, ..., g_t)             [预处理,对付失效模式 A/C]
第 4 步  更新:          θ_{t+1} = θ_t - η_t · V_t^{-1/2} m_t  [+ 可选:解耦正则]
把主流方法填进这个模板:
| 优化器 | $m_t$(一阶) | $V_t$(二阶) | 正则位置 | 状态开销 |
|---|---|---|---|---|
| SGD | $g_t$ | $I$ | 混入梯度 | 0 |
| SGD+Momentum | $\beta m_{t-1} + g_t$ | $I$ | 混入梯度 | $1\times$ |
| Nesterov | 同上,但在前瞻点取梯度 | $I$ | 混入梯度 | $1\times$ |
| AdaGrad | $g_t$ | $\sum_{i\le t} g_i^2$(对角,累加) | 混入梯度 | $1\times$ |
| RMSProp | $g_t$ | $\beta_2 V_{t-1} + (1-\beta_2)g_t^2$(对角,EMA) | 混入梯度 | $1\times$ |
| Adam | EMA + 偏差校正 | EMA + 偏差校正 | 混入梯度(L2) | $2\times$ |
| AdamW | 同 Adam | 同 Adam | 解耦,直接作用于 θ | $2\times$ |
| AMSGrad | 同 Adam | $\max(V_{t-1}, v_t)$,强制单调 | 混入梯度 | $3\times$ |
| Adafactor | 可选(常关) | 行列因子分解 $RC^\top$ | 解耦 | $\approx 0\text{–}1\times$ |
| Lion | 单一动量,取 sign | 隐含在 sign 里 | 解耦 | $1\times$ |
| LAMB | 同 Adam | 同 Adam,再乘逐层 trust ratio | 解耦 | $2\times$ |
| Shampoo | EMA | $L^{-1/4} \otimes R^{-1/4}$(Kronecker) | 解耦 | $\ge 2\times$ + 预处理矩阵 |
| Muon | EMA,再做正交化 | 用正交化替代 $V^{-1/2}$ | 解耦 | $1\times$ |
2.1 二维类型地图
一维谱不够用,因为"降噪"和"预处理"是两条正交的轴:
                  ┌── 预处理器的表达能力(对付 A/C)──────────────────────────►
                  │
                  │   P = I          P = 对角          P = 结构化矩阵     P = 稠密
  ────────────────┼────────────────────────────────────────────────────────────
  不做时间平均     │   GD             AdaGrad           —                Newton
  (对付 B:无)     │   SGD            RMSProp                            (纯二阶)
  ────────────────┼────────────────────────────────────────────────────────────
  EMA 动量        │   Momentum       Adam              Shampoo          K-FAC
  (对付 B)        │   Nesterov       AdamW             SOAP             自然梯度
                  │   Lion           Adafactor         Muon
  ────────────────┼────────────────────────────────────────────────────────────
  额外的层级归一   │   LARS           LAMB              —                —
  (对付 C:逐层)   │
  ────────────────┼────────────────────────────────────────────────────────────
  额外的迭代平均   │   Polyak/Ruppert  Schedule-Free    —                —
  (对付 B:末端)   │   权重 EMA         AdamW
────────────────┴────────────────────────────────────────────────────────────后两行是叠加层:它们在已有优化器之上再加一层,正交于前两行。
还有两条不在这张图里、但同样重要的正交维度:
- 内存维度:Adafactor / 8-bit Adam / Adam-mini / GaLore / ZeRO-1 —— 不改变数学行为(或只轻微改变),只压缩状态。
- 正则耦合维度:L2 混入梯度 vs 解耦 weight decay —— 见第 6 章。
3. 最速下降视角:一个范数选择就决定了一个优化器
这是整份文档里最值得掌握的一节。它把"为什么 Adam 长这样"从"经验拼凑"变成"从第一性原理导出"。
3.1 框架
所有更新都可以写成"在某个信任域里做线性化最速下降":
$$\Delta\theta^\star = \arg\min_{\|\delta\| \le \eta} \; \langle g, \delta\rangle$$(等价的无约束正则形式:$\arg\min_\delta \langle g,\delta\rangle + \frac{1}{2\eta}\|\delta\|^2$。)
关键在于:$\|\cdot\|$ 选什么范数。 换一个范数,就得到一个不同的优化器。而且最优值总是对偶范数:$\min_{\|\delta\|\le\eta}\langle g,\delta\rangle = -\eta\|g\|_*$。
3.2 三个具体的解
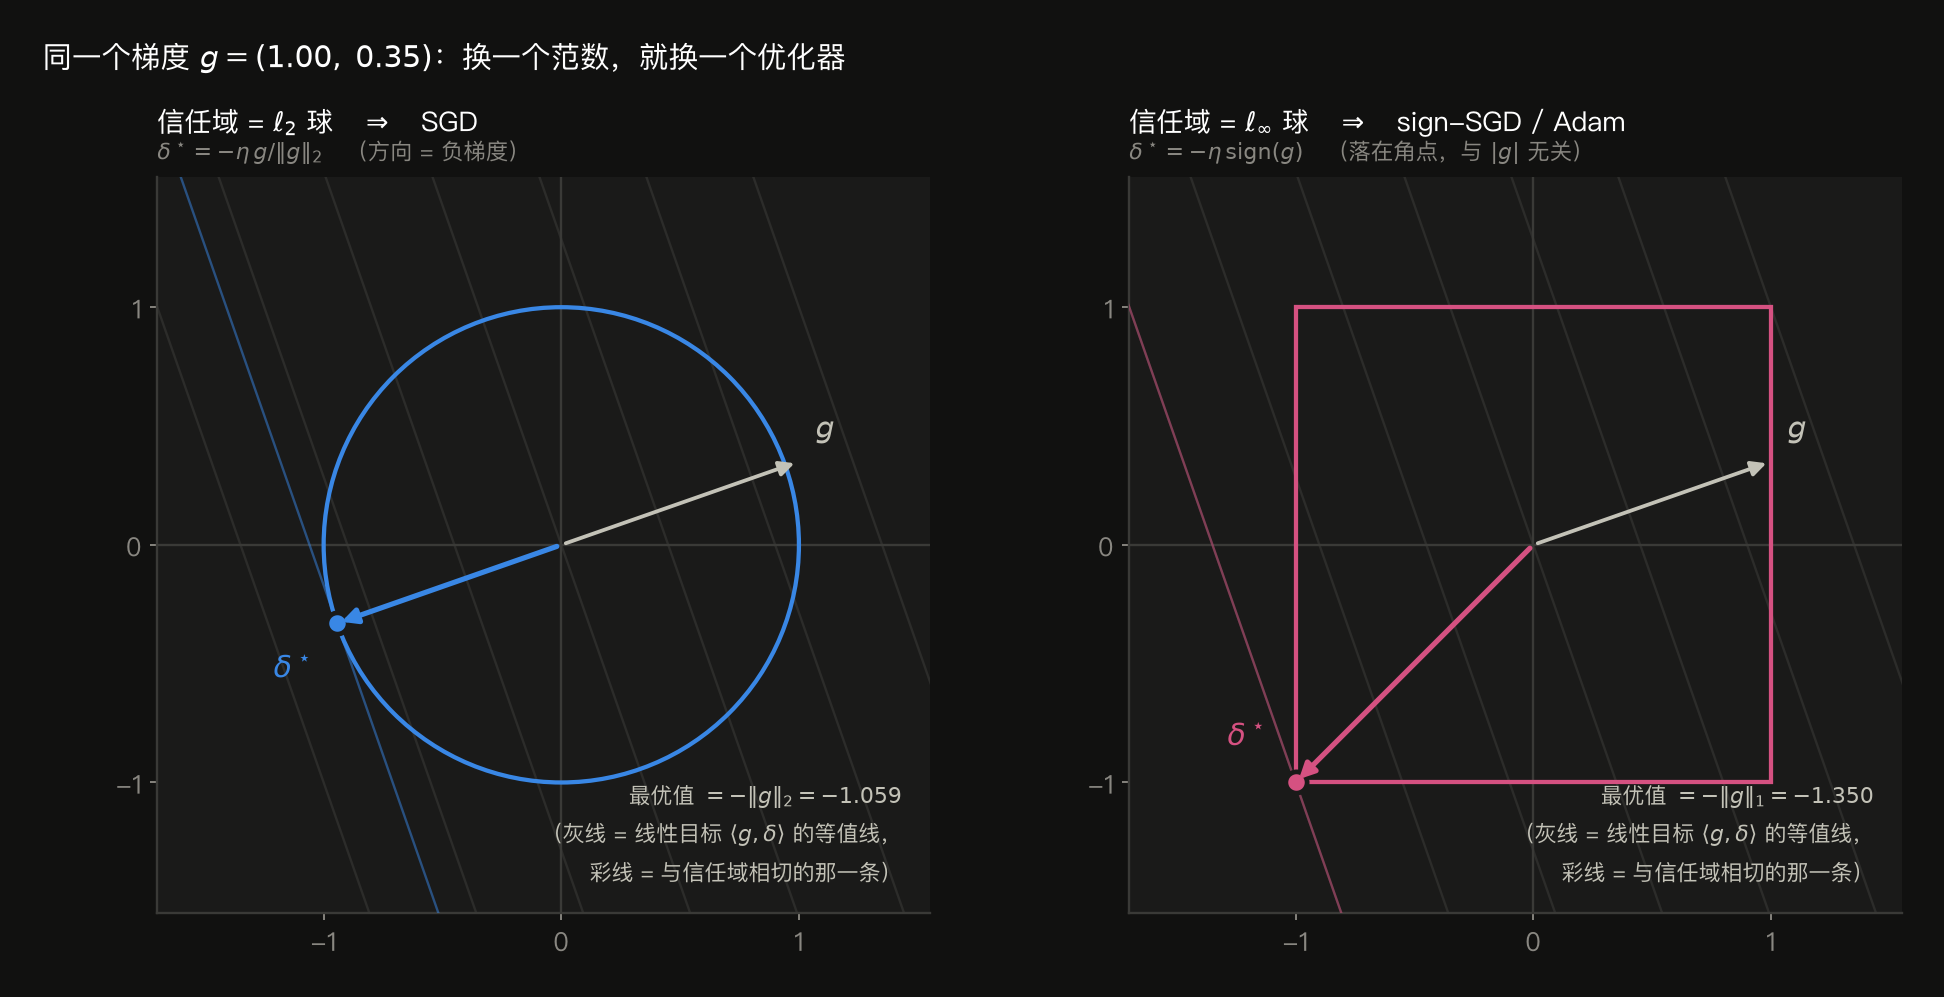
(a) 欧氏范数 $\|\delta\|_2 \le \eta$
$$\delta^\star = -\eta\,\frac{g}{\|g\|_2}, \qquad \text{最优值} = -\eta\|g\|_2$$这就是(归一化的)梯度下降。对偶范数是 $\ell_2$ 自身。
(b) 无穷范数 $\|\delta\|_\infty \le \eta$(约束每个坐标的最大步长)
$$\delta^\star = -\eta\,\mathrm{sign}(g), \qquad \text{最优值} = -\eta\|g\|_1$$推导很直接:目标 $\sum_i g_i\delta_i$ 在每个 $\delta_i \in [-\eta,\eta]$ 上独立最小化,显然取 $\delta_i = -\eta\,\mathrm{sign}(g_i)$。注意解落在角点,且完全不依赖 $|g_i|$ 的大小——这是 Adam 尺度不变性的几何根源。
这就是 sign-SGD,也就是 Adam 的极限形式。 见 5.3。
(c) 谱范数 $\|\Delta W\|_{2\to2} \le \eta$(对矩阵参数 $W$,约束更新的最大奇异值)
设梯度矩阵的紧凑 SVD 为 $G = U\Sigma V^\top$,则
$$\Delta W^\star = -\eta\,U V^\top, \qquad \text{最优值} = -\eta\|G\|_*\ (\text{核范数})$$这就是 Muon。 $UV^\top$ 是把 $G$ 的所有奇异值都替换成 1——扔掉幅度、只保留方向结构,是矩阵版的 sign 函数。
(d) Hessian 范数 $\|\delta\|_H^2 = \delta^\top H\delta$
$$\delta^\star \propto -H^{-1}g$$牛顿法。
3.3 这个视角解释了什么
一旦接受"优化器 = 范数选择",下面这些原本零散的事实就统一了:
- 为什么 Adam 对梯度整体缩放不敏感:$\ell_\infty$ 最速下降的方向只依赖 $\mathrm{sign}(g)$,与 $\|g\|$ 无关。
- 为什么 Adam 在 transformer 上远好于 SGD:$\ell_2$ 范数把所有坐标放在同一个尺度上比较,而 transformer 各参数块的梯度量级差几个数量级(失效模式 C)。$\ell_\infty$ 天然是逐坐标的。
- 为什么 Muon 只作用于 2D 参数:谱范数是矩阵(线性算子)的概念。embedding / LayerNorm gain / bias 不是线性算子,套谱范数没有意义,所以 Muon 的实现里它们仍走 AdamW。Muon 和 AdamW 是并存关系,不是替换关系。
- 为什么"更新的 RMS 大小"是个核心量:在 $\ell_\infty$ 视角下,每个坐标的更新幅度恰好是 $\eta$,所以 Adam 的学习率直接就是"每个参数每步走多远"。这是 SGD 不具备的性质。LAMB 的 trust ratio、Muon 的 RMS 对齐、μP 的宽度缩放,全建立在这个量上。
- 为什么 1.2 里 Adam 的步数与 $\kappa$ 无关:$\ell_\infty$ 最速下降是"匀速走",走完需要的步数是距离除以速度,跟曲率没关系。
相关工作:Bernstein & Newhouse 的 “Old Optimizer, New Norm” / “Modular Duality in Deep Learning”(2024)把这个视角系统化了。想深入就读这两篇。
4. 主干推导链:每一步修掉了上一步的哪个具体毛病
4.1 GD → SGD
$$\theta_{t+1} = \theta_t - \eta\,\nabla L(\theta_t) \quad\longrightarrow\quad \theta_{t+1} = \theta_t - \eta\,\nabla L_{\mathcal B_t}(\theta_t)$$动机不是优化,是计算预算。 全量梯度在百万级样本上不可行。mini-batch 梯度是无偏估计,方差 $\propto \sigma^2/B$。
代价:引入失效模式 B。收敛不再单调,最终在一个"噪声球"里徘徊,半径 $\propto \eta\sigma/\sqrt B$。所以要么衰减 $\eta$,要么增大 $B$,要么做时间平均。三条路后面都会出现。
附带的好处 [争议]:SGD 的噪声被广泛认为带来了隐式正则(倾向于收敛到"平坦"的极小值),这是视觉任务上 SGD 泛化常优于 Adam 的一个主流解释。但"平坦 = 泛化好"本身也有反例,别当定论。
4.2 SGD → Momentum(Polyak heavy ball, 1964)
$$m_t = \beta m_{t-1} + g_t, \qquad \theta_{t+1} = \theta_t - \eta m_t$$同时修 A 和 B:
- 修 A:在震荡方向上正负梯度相消,在一致方向上累加。二次型上把 $O(\kappa)$ 改善到 $O(\sqrt\kappa)$(1.2 的图已实测确认)。
- 修 B:$m_t$ 是最近约 $1/(1-\beta)$ 步梯度的加权和,等效于把 batch 放大了。
⚠️ 陷阱(几乎所有人第一次都踩):PyTorch 的 SGD(momentum=β) 用的是上面这个不带 $(1-\beta)$ 归一化的形式。稳态下 $m \to g/(1-\beta)$,所以:
把 $\beta$ 从 0.9 改成 0.99,等效学习率放大了 10 倍。 改动量必须同步改学习率,否则直接发散。
而 Adam 用的是归一化 EMA 形式 $m_t = \beta m_{t-1} + (1-\beta)g_t$,稳态 $m \to g$,没有这个放大效应。这两种写法的差异是初学者最大的混淆源之一,务必分清。
动量的有效窗口对照表($1/(1-\beta)$):
| $\beta$ | 0.5 | 0.9 | 0.95 | 0.99 | 0.999 |
|---|---|---|---|---|---|
| 有效窗口(步) | 2 | 10 | 20 | 100 | 1000 |
| PyTorch SGD 的有效 lr 放大 | 2× | 10× | 20× | 100× | 1000× |
| Adam EMA 形式的放大 | 1× | 1× | 1× | 1× | 1× |
4.3 Momentum → Nesterov (NAG)
朴素动量的问题:$m$ 已经"预定"要走 $\beta m_{t-1}$ 这一步,但梯度还是在出发点算的。Nesterov 的想法是在前瞻点算梯度:
$$\tilde\theta = \theta_t - \eta\beta m_{t-1}, \qquad g_t = \nabla L(\tilde\theta), \qquad m_t = \beta m_{t-1} + g_t$$PyTorch 用的是 Sutskever 等人(ICML 2013)的重参数化版本,实际更新方向是 $g_t + \beta m_t$,即在动量方向上多加了一个校正项 $\beta(m_t - m_{t-1})$。
直觉:前瞻等价于对曲率做了一阶修正——如果冲过头了,前瞻点的梯度会提前把你拉回来。凸问题上有更好的常数,深度学习上收益通常很小(ResNet 时代常用,LLM 时代基本不用)。
4.4 → AdaGrad(Duchi et al., JMLR 2011):第一个自适应方法
$$V_t = \sum_{i=1}^t g_i^2 \ (\text{逐坐标}), \qquad \theta_{t+1} = \theta_t - \frac{\eta}{\sqrt{V_t}+\epsilon}\odot g_t$$修的是 C:原始动机是稀疏特征。NLP 的词袋特征里,罕见词对应的参数很少收到梯度,$V$ 累加得慢,因此保持较大的学习率;高频特征的学习率快速下降。凸问题上有 $O(\sqrt T)$ 的 regret 界,且在稀疏情形下常数远优于 SGD。
致命缺陷:$V_t$ 单调递增,因此有效学习率 $\eta/\sqrt{V_t}$ 单调递减。凸问题上这正是收敛所需,非凸深度网络上则表现为"训到一半就不动了"。
4.5 AdaGrad → RMSProp(Hinton, Coursera Lecture 6e,从未正式发表)
一行修改:把累加换成指数移动平均。
$$V_t = \beta_2 V_{t-1} + (1-\beta_2)g_t^2$$$V_t$ 现在估计的是最近梯度的均方,不再单调增。这一步之后,自适应方法才真正能用在深度网络上。
在同一条梯度序列上把两者的有效学习率跑出来:
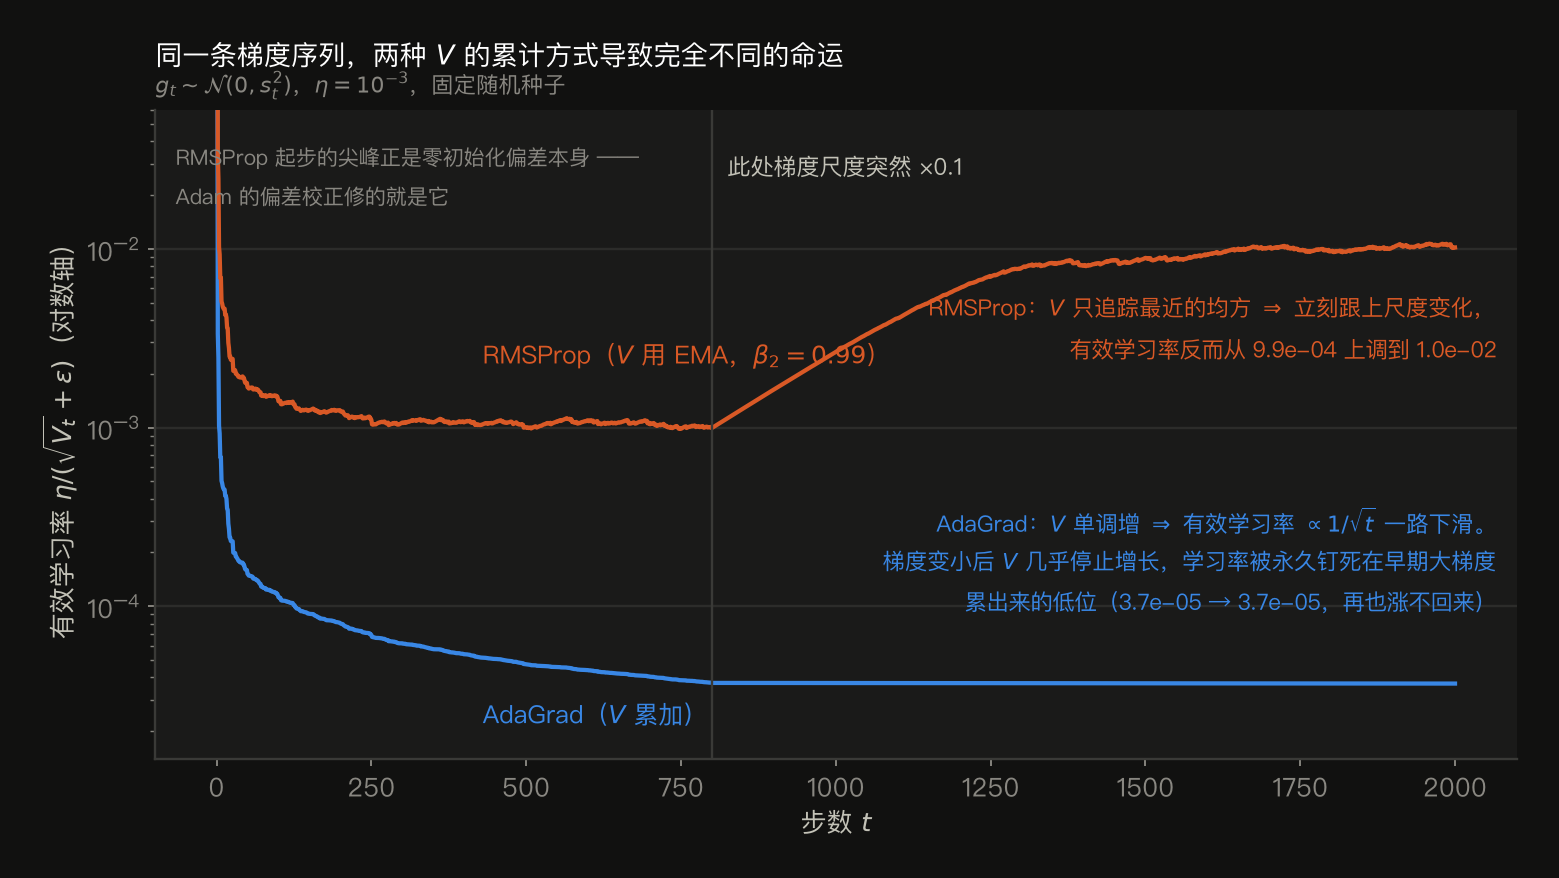
⚠️ 这张图纠了我原先的一个错误说法。我原本以为"梯度变小后 AdaGrad 衰减得更快",实际恰好相反:梯度变小后 $V$ 几乎停止增长,AdaGrad 的有效学习率不是继续跌,而是被永久钉死在早期大梯度累出来的低位(3.7e-5 → 3.7e-5)。这个失效更难受——不是"越来越慢",而是"被早期的历史判了终身刑,再也涨不回来"。
图里还顺手暴露了 RMSProp 的另一个毛病:起步的那个尖峰。 $V_1 = (1-\beta_2)g_1^2$ 极小,分母极小,第一步的有效学习率能冲到稳态的 10 倍以上。这正是 Adam 的偏差校正要修的东西——见 5.1。
顺带一提 Adadelta(Zeiler 2012):它进一步用 $\Delta\theta$ 的 RMS 做分子,试图去掉学习率超参。实践中已被淘汰,但它引入的量纲分析视角很有价值:
$g/\sqrt{\mathbb E[g^2]}$ 是无量纲的,所以自适应方法里 $\eta$ 的量纲就是 $\theta$ 的量纲——学习率直接是"走多远"。而 SGD 里 $\eta$ 的量纲是 $\theta^2/L$,强烈依赖损失函数的尺度。
这解释了一个实践事实:把 loss 乘以常数 10,对 Adam 几乎无影响,对 SGD 等价于把学习率改了 10 倍。(fp16 训练的 loss scaling 之所以对 Adam 安全,根源在此。)
4.6 RMSProp + Momentum → Adam(Kingma & Ba, ICLR 2015)
$$ \begin{aligned} m_t &= \beta_1 m_{t-1} + (1-\beta_1) g_t &&\text{一阶矩 EMA(方向 / 降噪)}\\ v_t &= \beta_2 v_{t-1} + (1-\beta_2) g_t^2 &&\text{二阶矩 EMA(尺度 / 预处理)}\\ \hat m_t &= m_t/(1-\beta_1^t), \quad \hat v_t = v_t/(1-\beta_2^t) &&\text{偏差校正}\\ \theta_{t+1} &= \theta_t - \eta\,\frac{\hat m_t}{\sqrt{\hat v_t}+\epsilon} \end{aligned} $$默认 $\beta_1 = 0.9,\ \beta_2 = 0.999,\ \epsilon = 10^{-8}$。
Adam = RMSProp 的分母 + 动量的分子 + 偏差校正。 一句话就能说清它的构成。真正需要理解的是第 5 章那九个细节。
4.7 AMSGrad 与 Adam 的收敛性问题
Reddi et al.(ICLR 2018,“On the Convergence of Adam and Beyond”)做了两件事:
- 指出 Adam 原论文的收敛性证明有漏洞,并构造了一个在线凸优化的反例:存在一个凸问题,Adam 会收敛到最差点。直觉上的原因是 $\eta/\sqrt{\hat v_t}$ 可以上升(因为 $v$ 是 EMA,会遗忘),破坏了收敛证明所需的"有效步长非增"条件。
- 提出 AMSGrad:强制 $\hat v_t \leftarrow \max(\hat v_{t-1}, v_t)$,把有效学习率变回单调非增。
实践结论:AMSGrad 基本没人用。 它多存一份状态($3\times$),且在真实任务上通常不比 Adam 好——因为那个反例是精心构造的,而"$v$ 会遗忘"在非稳态的深度学习里恰恰是优点(见 4.5 的图:AdaGrad 的单调性是灾难而非保障)。
后续工作(Défossez et al. 2020;Zhang et al. 2022 等)证明了在更贴近实际的条件下($\beta_2$ 足够接近 1、或允许依赖问题的常数)Adam 确实收敛。
为什么还要知道这段:它是"理论保证 ≠ 实践表现"的经典案例,也是面试里问"Adam 有什么理论问题"的标准答案。
5. Adam 的九个细节(“会用但说不清"的分界线)
5.1 偏差校正到底在修什么(大多数解释是错的)
推导:展开 $m_t = (1-\beta_1)\sum_{i=1}^t \beta_1^{t-i} g_i$。若 $g_i$ 同分布且 $\mathbb E[g]=\mu$,则
$$\mathbb E[m_t] = \mu(1-\beta_1)\sum_{i=1}^{t}\beta_1^{t-i} = \mu\,(1-\beta_1^t)$$因为 $m_0 = 0$ 这个零初始化,估计被系统性地拉向 0,偏差因子恰是 $(1-\beta_1^t)$。除掉它就无偏。$v_t$ 同理,偏差因子 $(1-\beta_2^t)$。
常见的错误解释:“不做偏差校正的话早期步子太小。” —— 对 $m$ 单独看是对的,但对最终的比值是反的。算一下 $t=1$:
$$m_1 = (1-\beta_1)g_1 = 0.1\,g_1, \qquad \sqrt{v_1} = \sqrt{1-\beta_2}\,|g_1| = 0.0316\,|g_1|$$$$\frac{m_1}{\sqrt{v_1}} = \frac{0.1}{0.0316}\,\mathrm{sign}(g_1) = 3.16\,\mathrm{sign}(g_1)$$分子分母都偏小,但分母偏得更狠($\beta_2$ 更大,且开了根号),所以不校正的第一步比理想值大了 3.16 倍。 偏差校正实际上是在抑制早期的过大步长。
把这个比值随 $t$ 画出来,还有个更强的结论:
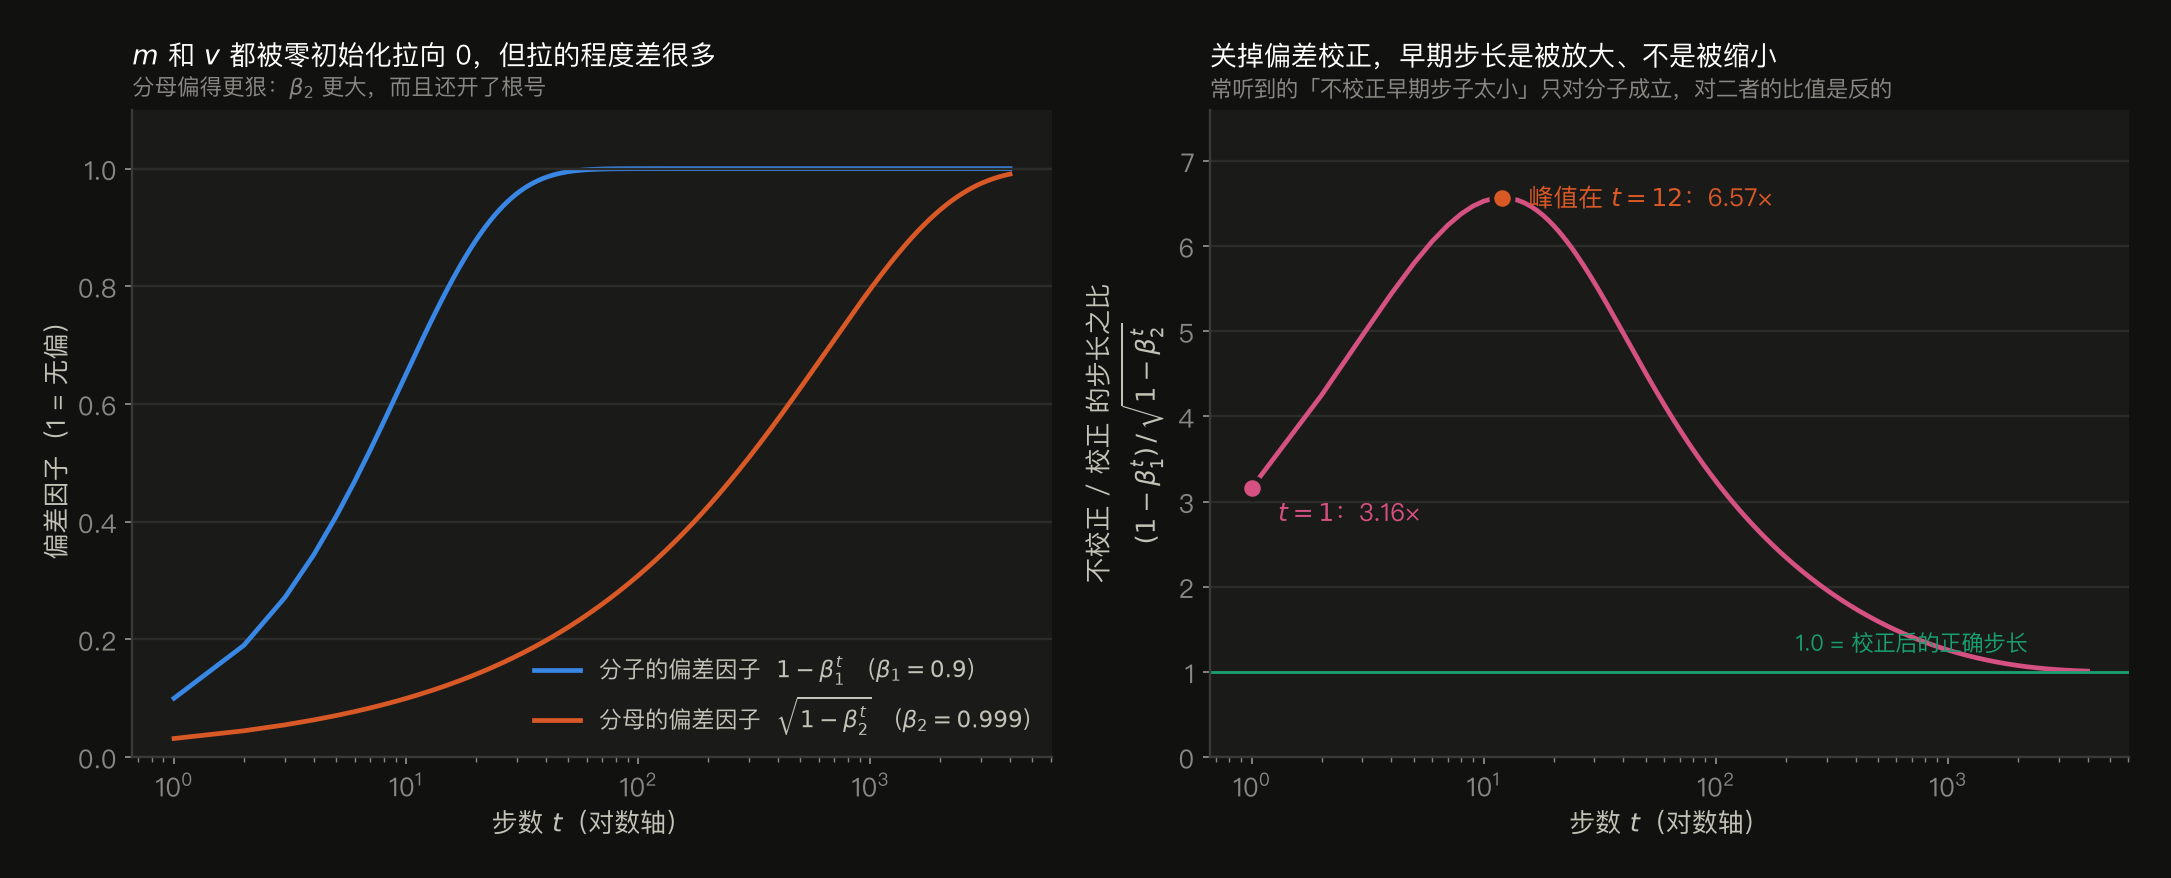
⚠️ 峰值不在 $t=1$,而在 $t=12$,放大 6.57 倍。 不做偏差校正的最坏情况不是第一步,而是前十几步——那时分子已经补上来了($1-0.9^{12}=0.72$),分母还差得远($\sqrt{1-0.999^{12}}=0.109$)。这个数我原本估错了(以为 3.16 就是最大),是画图时算出来的。
校正之后:$\hat m_1 = g_1,\ \hat v_1 = g_1^2$,更新量 $= \eta\,\frac{g_1}{|g_1|+\epsilon} \approx \eta\,\mathrm{sign}(g_1)$。
Adam 的第一步,每个参数恰好移动 $\eta$。 这个事实要记住,它是理解 warmup、理解 Adam 学习率量级($10^{-4}\sim10^{-3}$,而 SGD 是 $10^{-1}$)的锚点。
5.2 那为什么还需要 warmup?
偏差校正只修了期望,没修方差。早期 $\hat v_t$ 是基于极少数样本的估计,方差极大;$1/\sqrt{\hat v}$ 是凸函数,小的 $\hat v$ 会被放大成巨大的有效学习率,偶发的极端步长足以把随机初始化的模型直接打坏。
RAdam(Liu et al., ICLR 2020)显式估计了这个方差并加了整流项,结论是:前若干步应该退化成不带自适应的 SGD-with-momentum。 但工业界发现线性 warmup 几乎同样有效且简单得多,所以 RAdam 没有普及,warmup 成了标配。
另一个独立的 warmup 理由来自 1.3:训练初期模型处于高曲率区域且 $\lambda_1$ 正在快速上升(progressive sharpening),任何优化器都需要小步长。
实践默认:线性 warmup,长度取总步数的 1%–2%,或固定 2000–5000 步。不稳定就加长。
5.3 Adam ≈ 带平滑的 sign-SGD
若忽略噪声、取 $\beta_1 = \beta_2$,则 $\hat v \approx \hat m^2$,于是
$$\frac{\hat m}{\sqrt{\hat v}} \approx \frac{\hat m}{|\hat m|} = \mathrm{sign}(\hat m)$$Adam 本质上是"对动量取符号",即第 3 章的 $\ell_\infty$ 最速下降。 分母的真正作用不是"精确估计曲率",而是把所有坐标的更新幅度归一化到 $\approx \eta$。
这一条推论极多:
- 尺度不变性:$g \to cg$ 时更新不变($\epsilon$ 除外)。loss scaling 安全。
- 对梯度量级异质性免疫:这是它在 transformer 上碾压 SGD 的直接原因(失效模式 C)。
- Lion 为什么能工作:既然分母只是在做 sign,那干脆直接 sign,省掉 $v$ 这一整份状态。
- Adam 不是真正的二阶方法:$\mathbb E[g^2]$ 估计的是梯度的二阶矩(含噪声),不是 Hessian。在噪声主导时 $\sqrt{\mathbb E[g^2]} \approx \sigma$,此时 Adam 更像在做噪声归一化而非曲率校正。
[争议]学界对"Adam 到底在近似什么"仍无共识。
5.4 $\epsilon$ 的位置和它的双重角色
PyTorch 实现(与 Adam 论文 Algorithm 1 一致):
$$\theta \mathrel{-}= \eta\,\frac{\hat m}{\sqrt{\hat v} + \epsilon}$$注意 $\epsilon$ 在根号外面。另一种常见变体是 $\sqrt{\hat v + \epsilon}$(部分早期 TF 实现),两者数值行为不同,迁移代码时要核对。
$\epsilon$ 有两个角色,别只记住第一个:
- 数值保护:防止 $\hat v \to 0$ 时除零。
- 隐式的自适应下界:当某坐标的 $\sqrt{\hat v} \ll \epsilon$ 时,更新退化为 $\eta\hat m/\epsilon$,也就是退化成普通的 momentum SGD。所以 $\epsilon$ 是一个"从 Adam 滑向 SGD"的旋钮——调大 $\epsilon$ 让小梯度坐标不再被放大。
实践中:默认 $10^{-8}$;训练不稳定时有人调到 $10^{-6}$ 增强稳定性;梯度本身极小的场景(某些 bf16 训练)有人调到 $10^{-15}$。没有普适答案,但要知道它是个可调旋钮而不是魔法常数。
5.5 $\beta_2$ 为什么在 LLM 里从 0.999 降到 0.95
$1/(1-\beta_2)$ 是二阶矩的有效记忆窗口:$\beta_2 = 0.999$ → 1000 步,$\beta_2 = 0.95$ → 20 步。$v$ 的半衰期 $\ln 2/\ln(1/\beta_2)$ 分别是 693 步和 13.5 步。
注入一次梯度尖峰,看两者的反应:
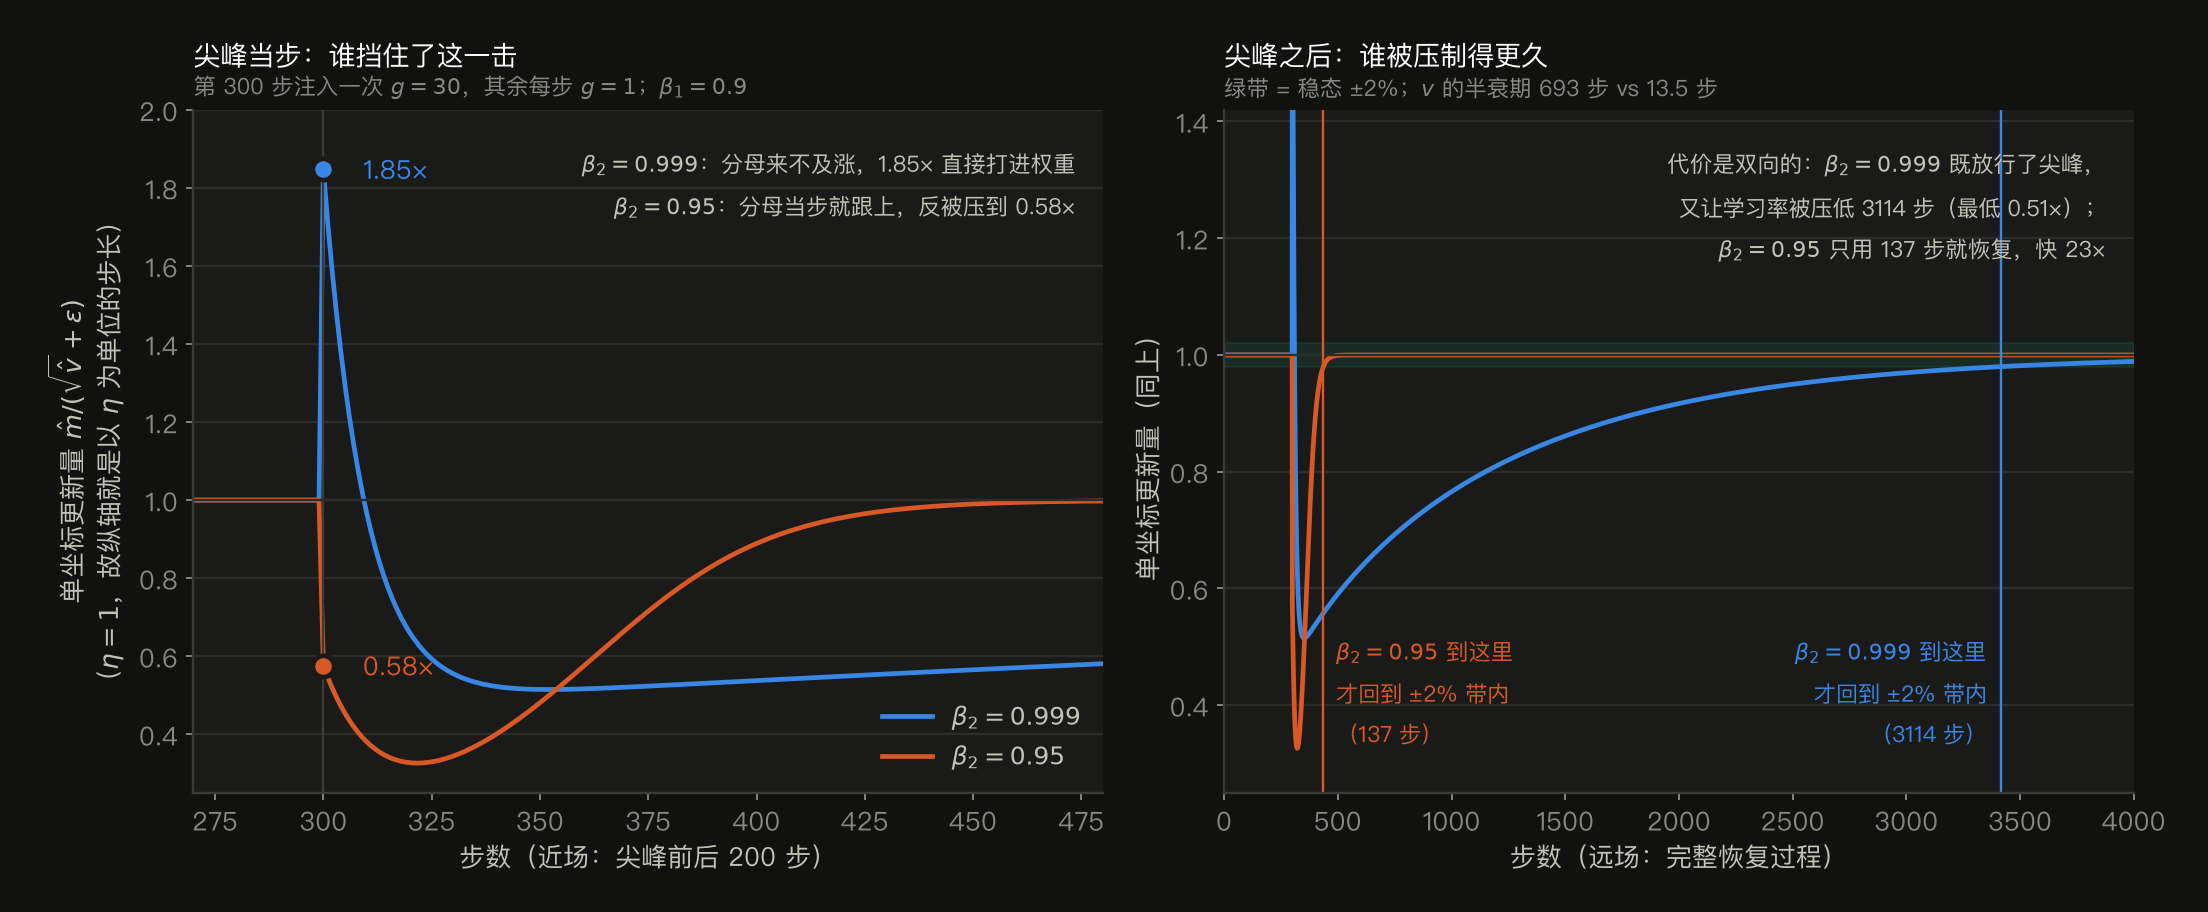
⚠️ 这张图纠正了我的第三个错误。我原先以为这是个"两头堵"的权衡(0.95 抗尖峰更好但恢复慢),实测两个方向都是 0.95 赢:
| $\beta_2=0.999$ | $\beta_2=0.95$ | |
|---|---|---|
| 尖峰当步打进权重的倍数 | 1.85×(放行) | 0.58×(挡住) |
| 之后学习率被压制的时长 | 3114 步 | 137 步 |
| 最低被压到 | 0.51× | 0.33×(但只持续几十步) |
机制:小 $\beta_2$ 让分母当步就吸收尖峰($v$ 从 1 直接跳到 45.95),于是这一步的更新被自动压小;同时短半衰期让 $v$ 快速回落。大 $\beta_2$ 两头都吃亏——分母涨得太慢挡不住当步,$v$ 的长记忆又让后续几千步的学习率都被拖低。
代价是 $\hat v$ 的估计更噪(只用最近 20 步的梯度平方去估均方)。GPT-3、Llama 系列均用 $\beta_1=0.9,\ \beta_2=0.95$。PaLM 用了 $\beta_2 = 1 - t^{-0.8}$ 的调度(早期小、后期大)兼顾两端。
这是"稳定性 vs 估计质量"的显式 tradeoff,不是玄学。 而且训练不稳时把 $\beta_2$ 从 0.999 降到 0.95 是 LLM 训练里最常用的止血手段之一,上面这张图就是它为什么有效的机制说明。
5.6 Adam 的"每步 RMS ≈ η"性质
由 5.3,每个坐标的更新量约为 $\pm\eta$,所以整个参数张量的更新 RMS $\approx \eta$。1.2 的模拟给了直接验证:Adam 在 30 步里走了 0.291,而 $30\times\eta = 30\times0.01 = 0.30$。 推论:
- Adam 的学习率是一个绝对的、与模型无关的物理量(“每个权重每步移动多少”),所以 $3\times10^{-4}$ 这种量级能跨模型、跨任务地大致复用。SGD 的学习率没有这个性质。
- 它给了一个诊断量:监控 $\|\Delta\theta\| / \|\theta\|$(相对更新幅度)。健康训练中这个比值通常在 $10^{-3}$ 附近且平稳。突然飙升 = 该层要出事。
- LAMB、Muon 的设计都是显式操控这个量。μP(最大更新参数化)的核心也是让它在模型宽度变化时保持不变,从而使最优学习率可迁移。
5.7 Adam 与梯度裁剪 / 梯度累积 / 权重 EMA 的交互
- 梯度裁剪(LLM 标配:global norm clip 到 1.0)作用在 $g_t$ 上,因此也改变了 $v_t$ 的估计。这是好事:裁剪防止一个异常 batch 污染二阶矩估计(否则按 5.5 的图,$\beta_2=0.999$ 下后续三千步的学习率都要受累)。
- 两种裁剪别搞混:
clip_grad_norm_按全局范数等比缩放所有梯度(保方向),clip_grad_value_按逐元素截断(改方向)。LLM 用前者。 - DDP 下必须在 all-reduce 之后裁剪,否则每个 rank 裁的是自己的局部范数,结果与单卡不等价。
- 两种裁剪别搞混:
- 梯度累积:状态更新必须发生在真正
optimizer.step()时。若误在每个 micro-batch 上 step,等价于把 batch size 缩小了 N 倍且学习率没变——一个非常隐蔽的 bug。另外累积时 loss 要除以累积步数,否则梯度尺度偏大 N 倍(对 Adam 影响小、对 SGD 是直接改学习率)。 - 权重 EMA ≠ 动量。动量是对梯度做平均(优化器内部状态),权重 EMA 是对参数做平均(另开一份参数副本,仅用于评估 / 推理)。扩散模型几乎必用权重 EMA(衰减率 0.999–0.9999)——这条与 3D / 视觉生成方向直接相关。它对付的也是失效模式 B,但作用在"末端"而非"每步"。
5.8 为什么 LLM 非 Adam 不可(五个假说,无一是定论)[争议]
这是个未解决的研究问题,但候选解释很值得知道,因为它们各自指向不同的改进方向:
- 梯度尺度跨参数块异质(失效模式 C)。最直接的解释,也是本文采用的主线。Adam 的逐坐标归一化直接对症。
- 重尾梯度噪声(Zhang et al. 2020,“Why are Adaptive Methods Good for Attention Models?")。attention 模型的梯度噪声分布是重尾的,SGD 偶发的极大步长破坏训练;Adam 的分母起到了自适应裁剪的作用。
- 反驳 2(Kunstner et al. 2023,“Noise Is Not the Main Factor…"):full-batch 下 Adam 依然大幅优于 GD。既然去掉噪声差距还在,噪声就不是主因。这篇很重要——它排除了一个流行解释。
- 重尾类别不平衡(Kunstner et al. 2024)。语言建模的 token 频率是重尾的:低频 token 对应的 logit / embedding 行很少收到梯度,SGD 学不动它们。这个解释绕回了 AdaGrad 2011 年的原始动机(稀疏特征),把十三年的历史接上了,非常优雅。
- Hessian 的块间异质性(Zhang et al. 2024,“Why Transformers Need Adam: A Hessian Perspective”)。transformer 的 Hessian 谱在不同参数块之间差异极大,单一学习率无法适配;Adam 相当于给每个块配了自适应学习率。
反向的问题同样重要:为什么视觉分类上 SGD 常反过来赢? 主流解释是 SGD 噪声的隐式正则带来更好的泛化,而 Adam 收敛得"太好”(训练损失更低但泛化更差)。注意 LLM 预训练通常只过一遍数据、几乎不过拟合,所以这条对 LLM 不适用——这也提醒你别把 CV 的经验直接搬到 LLM。
5.9 优化器状态的数值精度与 fp32 master weights
这一节解释了 8.1 显存账里那个"为什么要多存一份 fp32 参数”。
bf16 的相对精度约 $2^{-8} = 3.9\times10^{-3}$(7 位显式尾数 + 1 位隐含)。而由 5.6,Adam 单步的相对更新量约为
$$\frac{\eta}{|\theta|_{\text{RMS}}} \approx \frac{3\times10^{-4}}{0.04} \approx 7.5\times10^{-3}$$刚刚超过 bf16 的精度门槛——训练早期勉强能存住,但 cosine 衰减到 $3\times10^{-5}$ 之后,相对更新量掉到 $7.5\times10^{-4}$,远低于 $3.9\times10^{-3}$,更新会被舍入直接吃掉,训练悄无声息地停止前进。
这就是 fp32 master weights 的存在理由。(fp16 有 10 位尾数,相对精度 $2^{-11}=4.9\times10^{-4}$,这一项上其实比 bf16 好;bf16 的优势在指数范围,不需要 loss scaling。)
两个状态的精度敏感度不同:
- $m$ 与梯度同量纲,动态范围温和,bf16 存 $m$ 通常可接受。
- $v$ 是梯度的平方,动态范围翻倍(跨十几个数量级),低精度直接存很容易下溢成 0,然后分母变成 $\epsilon$、步长爆炸。这就是 8-bit Adam 必须用分块动态量化(每 2048 个元素一组独立的量化常数)而不能简单截断的原因。
5.10 小结:Adam 的默认超参各自在管什么
| 超参 | 默认 | 它控制什么 | 什么时候需要动 |
|---|---|---|---|
| $\eta$ | $3\times10^{-4}$ | 每个参数每步走多远(绝对量) | 总是要调,最重要 |
| $\beta_1$ | 0.9 | 方向的平滑窗口(10 步) | 几乎不动 |
| $\beta_2$ | 0.95(LLM)/ 0.999 | 尺度估计的窗口 + 抗尖峰能力 | 不稳定时降到 0.95 |
| $\epsilon$ | $10^{-8}$ | 除零保护 + “退化成 SGD"的下界 | 数值问题时调大 |
| warmup | 总步数 1–2% | 躲开 $\hat v$ 方差最大的区间 | 不稳定时加长 |
| clip | 1.0 | 防止单个坏 batch 污染 $v$ | 基本固定 |
6. AdamW:为什么 L2 正则在 Adam 里是坏掉的
6.1 问题
经典 L2 正则的做法是把 $\frac{\lambda}{2}\|\theta\|^2$ 加进损失,等价于把 $\lambda\theta$ 加进梯度:$g'_t = g_t + \lambda\theta_t$。
在 SGD 里,这确实等价于 weight decay:$\theta \leftarrow \theta - \eta g - \eta\lambda\theta = (1-\eta\lambda)\theta - \eta g$。两者完全等价。
在 Adam 里就不等价了。因为 $\lambda\theta$ 会同时进入 $m$ 和 $v$,然后被 $\sqrt{\hat v}$ 除掉:
$$\Delta\theta \propto \frac{\widehat{m(g+\lambda\theta)}}{\sqrt{\widehat{v(g+\lambda\theta)}}+\epsilon}$$把"实际衰减强度 vs 该参数的 $\sqrt{\hat v}$“画出来,扭曲有多大一目了然:
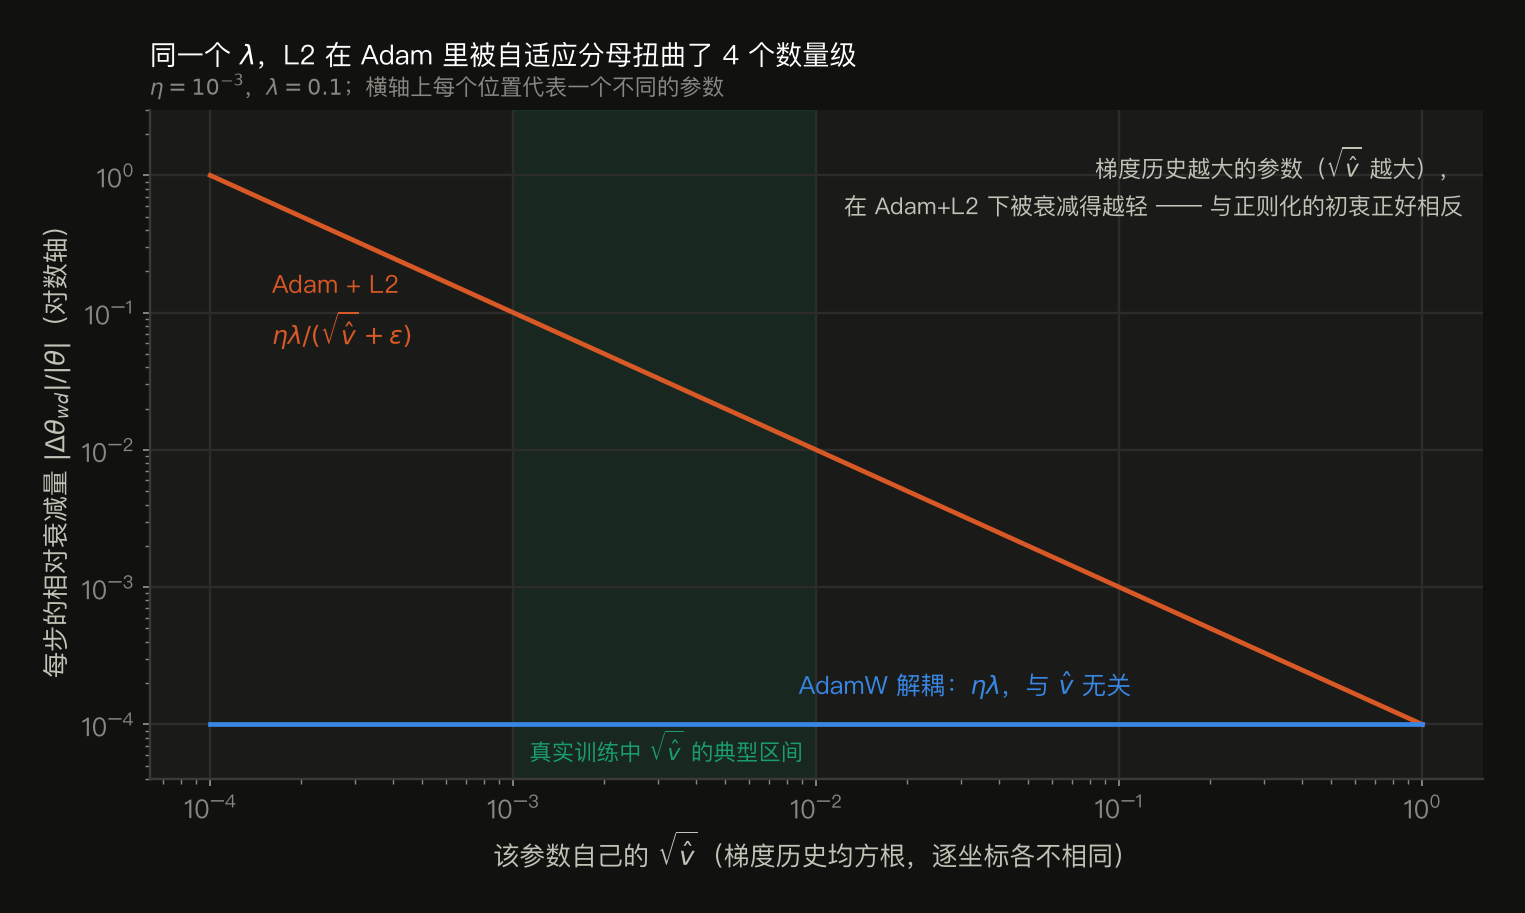
后果:某个参数的历史梯度越大 → $\sqrt{\hat v}$ 越大 → 分母越大 → 它受到的实际衰减越弱。
也就是说,L2 在 Adam 里被自适应分母扭曲成了"梯度大的参数正则弱、梯度小的参数正则强”——这与正则化的初衷(对所有参数施加一致的容量约束)完全相反,而且这个耦合是无意的副作用,不是设计。
6.2 解法:解耦(Loshchilov & Hutter, ICLR 2019)
把衰减项从梯度里拿出来,直接作用在参数上:
$$\theta_{t+1} = \theta_t - \eta_t\left(\frac{\hat m_t}{\sqrt{\hat v_t}+\epsilon} + \lambda\,\theta_t\right)$$现在每个参数的衰减是干净的 $\eta\lambda\theta$,与它的梯度历史无关。
⚠️ 三个必须记住的实践点:
torch.optim.Adam(weight_decay=λ)实现的是 L2,不是 AdamW。 想要解耦必须用torch.optim.AdamW。这是最常见的静默 bug 之一——不报错,只是效果不对。- 两者的 $\lambda$ 数值完全不可比。 由上图,$\sqrt{\hat v}$ 在 $10^{-3}$ 量级时 Adam+L2 的实际衰减被放大约 1000 倍。换实现必须重调 $\lambda$。典型值:AdamW 用 0.1(LLM)或 0.01–0.05(视觉)。
- PyTorch 的 AdamW 把 $\lambda$ 乘上了当前 lr,所以 weight decay 会跟着 learning rate schedule 一起衰减。这与原论文的 schedule multiplier 设计一致,但意味着"cosine 衰减到 0 时 weight decay 也归零”。知道这一点,否则你会对后期权重范数的行为感到困惑。
6.3 哪些参数不应该 decay
约定俗成的排除列表:bias、LayerNorm / RMSNorm 的 gain 和 bias。理由:这些参数控制的是函数的尺度 / 平移而非容量,把它们往 0 拉是在直接损害表达能力(把 LayerNorm 的 gain 拉向 0 等于关掉这一层)。
embedding 是否 decay 有分歧,两派做法都存在。
实现上就是给 optimizer 传两个 param group,一组 weight_decay=0.1,一组 weight_decay=0.0。这是每个 LLM 训练脚本里都有的十几行代码。分组写错了不会报错,只会让 norm 层的 gain 缓慢漂向 0——见练习 3。
6.4 weight decay 在现代 LLM 里的真实作用 [争议]
经典解释是"防止过拟合"。但 LLM 预训练常常只过一遍数据,几乎不存在过拟合。那 weight decay 在干什么?
当前较主流的理解:它通过控制权重范数来控制"有效学习率"。
对于后接归一化层的权重(scale-invariant,即 $W \to cW$ 不改变该层输出),函数只依赖 $W$ 的方向而非模长。此时权重的角度更新速度 $\approx \|\Delta W\|/\|W\|$ 才是真正的学习率。weight decay 压低 $\|W\|$,从而抬高有效学习率,最终稳定在一个由 $\eta$ 和 $\lambda$ 共同决定的平衡点。
(源头是 Van Laarhoven 2017 关于 L2 与归一化交互的分析,后续有一系列"旋转平衡"的工作。这条解释在归一化层普遍存在的现代架构里比"防过拟合"更有说服力,但仍不是定论。)
6.5 平衡范数的闭式估计(可以背,也可以自己验)
上一节的"平衡点"可以直接算出来,而且结果很干净。
设 AdamW 的更新为 $\theta_{t+1} = (1-\eta\lambda)\theta_t - \eta u_t$,其中由 5.6,$u_t$ 每个坐标约为 $\pm 1$,故 $\|u\|^2 \approx d$。假设 $u$ 与 $\theta$ 大致不相关(交叉项 $\approx 0$):
$$\|\theta_{t+1}\|^2 \approx (1-2\eta\lambda)\|\theta_t\|^2 + \eta^2 d$$平衡时 $2\eta\lambda\|\theta\|^2 = \eta^2 d$,于是
$$\|\theta\|^2 = \frac{\eta d}{2\lambda} \qquad\Longrightarrow\qquad \boxed{\ \theta_{\text{每坐标 RMS}} = \sqrt{\frac{\eta}{2\lambda}}\ }$$注意维度 $d$ 消掉了——平衡尺度只由 $\eta/\lambda$ 这一个比值决定,与张量大小无关。
我跑了 30 万步数值验证(d ∈ {256, 4096},三组 $(\eta,\lambda)$):
| $\eta$ | $\lambda$ | 闭式 $\sqrt{\eta/2\lambda}$ | 实测 RMS ($d$=256) | 实测 RMS ($d$=4096) |
|---|---|---|---|---|
| $3\times10^{-4}$ | 0.1 | 0.0387 | 0.0394 | 0.0382 |
| $1\times10^{-3}$ | 0.1 | 0.0707 | 0.0718 | 0.0704 |
| $3\times10^{-4}$ | 0.01 | 0.1225 | 0.1238 | 0.1127 |
误差 1–8%,且确实与 $d$ 无关。而 $\eta=3\times10^{-4},\lambda=0.1$ 给出的 0.039 正好落在真实 LLM 权重 RMS 的常见区间(0.02–0.05)。
这个公式的三个用途:
- 判断超参是否自洽:如果你把 $\eta$ 降了 10 倍却没动 $\lambda$,权重范数的平衡点会降到 $1/\sqrt{10}$,模型的"工作点"整体变了。这解释了为什么调 lr 常常要连带调 wd。
- 理解 6.4 的有效学习率:scale-invariant 层的有效学习率 $\propto \eta/\|\theta\| = \eta/\sqrt{\eta/2\lambda} = \sqrt{2\eta\lambda}$。有效学习率由 $\eta\lambda$ 的乘积决定——这是个很实用的结论。
- 诊断:实测权重 RMS 与 $\sqrt{\eta/2\lambda}$ 差很远,说明某个假设被破坏了(比如该层根本没被 decay、或者 $u$ 与 $\theta$ 强相关)。
局限:交叉项 $\langle \theta, u\rangle \approx 0$ 这个假设在真实训练里不严格成立(更新方向与权重是有相关性的),所以这是一阶估计而不是精确结果。
7. 五条分支:当代论文都在这些线上
主干(AdamW)之后,研究分裂成几条相对独立的线。面试时能说清这几条线的动机差异,就说明地图建起来了。
7.1 内存线:优化器状态占了训练显存的一大块
动机见 8.1 的显存账:AdamW 的 $m,v$ 是每参数 8 字节 fp32。
| 方法 | 核心思路 | 节省 | 代价 |
|---|---|---|---|
| Adafactor (Shazeer & Stern, ICML 2018) | 对 $m\times n$ 矩阵,用行和 $R$、列和 $C$ 的秩 1 近似重构 $\hat V \approx RC^\top/(\mathbf 1^\top R)$,$O(m{+}n)$ 而非 $O(mn)$;默认 $\beta_1{=}0$ 连动量都不存 | $v$ 从 $O(mn)$ → $O(m{+}n)$;关动量再省一半 | 近似有损;需配套 update clipping 和相对步长才稳。T5 用它训出来的 |
| 8-bit Adam (Dettmers et al., ICLR 2022) | 对 $m,v$ 做分块动态量化到 int8(块大小 2048,每块独立量化常数,避免异常值污染全局)——见 5.9 为什么必须分块 | 状态 $8\to2$ B/param | 论文报告匹配 fp32,但需要 stable embedding layer 配合 |
| Adam-mini (2024) | 按 Hessian 的块结构把参数分组,每组共享一个标量 $v$ | 状态减少约 45–50% | 分组策略依赖架构先验 |
| GaLore (Zhao et al., 2024) | 把梯度投影到低秩子空间,在子空间里跑 Adam,再投影回来;周期性重算投影矩阵 | 状态降到秩 $r$ 的量级 | 引入投影周期等超参;与 LoRA 的区别是全参数被更新,只是优化器状态低秩 |
| ZeRO-1 (Rajbhandari et al., SC 2020) | 不改数学,把状态跨数据并行 rank 分片 | 状态 $/N$ | 增加一次 all-gather;这是系统方案,与上面几个正交、可叠加 |
⚠️ 别把两类混为一谈:ZeRO 改变的是状态的存储位置(数学等价),Adafactor / 8-bit Adam 改变的是数学本身(有损近似)。调试收敛问题时这个区分很关键。
7.2 大 batch 线:当 batch 大到几万,学习率该怎么给
问题:由 1.4,batch 增大到 $B_{crit}$ 附近后,线性缩放规则失效,而且某些层会先崩。
根因:不同层能承受的相对更新幅度 $\|\Delta\theta_l\|/\|\theta_l\|$ 不同,全局学习率无法同时满足。(这是失效模式 C 在层粒度上的版本。)
- LARS (You et al., 2017):SGD + 逐层 trust ratio $r_l = \|\theta_l\|/\|g_l\|$,更新 $=\eta\, r_l\, g_l$。把 ResNet-50 的 batch 推到 32K。
- LAMB (You et al., ICLR 2020):把同样的 trust ratio 套在 Adam 更新量上,$r_l = \|\theta_l\|/\|u_l\|$($u_l$ 是 Adam 更新 + weight decay)。BERT 训练从 3 天压到 76 分钟,batch 64K。
要带走的概念不是这两个算法本身(现在用得不多),而是 trust ratio 这个量:它显式地把"每层每步走原地长度的百分之几"作为可控量。μP 和 Muon 的 RMS 对齐是同一个思想的不同实现,6.5 的平衡范数分析也是在算同一件事。
7.3 二阶 / 矩阵线:真的去逼近 $H^{-1}$
回到 1.6 的中轴线。Adam 的对角预处理只能修正坐标轴对齐的病态;如果 Hessian 的主轴与坐标轴不对齐(深度网络里普遍如此),对角预处理帮助有限。这条线试图捕捉跨坐标的相关性。
Newton (H⁻¹)  ──非凸下 H 不正定、O(d³)──►  用半正定代理
        │
        ├─ Gauss-Newton / Fisher:  用 JᵀJ 或 Fisher F 代替 H(天然半正定)
        │
        ├─ 自然梯度 (Amari):  在分布空间用 KL 度量,更新 = F⁻¹g
        │       │
        │       └─ K-FAC (Martens & Grosse 2015): 每层 F ≈ A ⊗ G
        │            (A = 输入激活协方差,G = 输出梯度协方差)
        │            求逆变成两个小矩阵求逆:(A⊗G)⁻¹ = A⁻¹⊗G⁻¹
        │
        └─ Shampoo (Gupta et al., ICML 2018): 对每个矩阵参数 W (m×n)
               L = Σ GGᵀ (m×m),  R = Σ GᵀG (n×n)
               更新 = L^{-1/4} G R^{-1/4}
                 │
                 ├─ Distributed Shampoo (Anil et al. 2020): 工程化,MLPerf 上胜过 Adam
                 └─ SOAP (Vyas et al. 2024): 在 Shampoo 的特征基里跑 Adam,
                      等价视角 + 更低的预处理器更新频率,实践更稳
Kronecker 分解是这条线的灵魂:一个 $mn \times mn$ 的矩阵被近似成 $m\times m$ 和 $n\times n$ 两个小矩阵的张量积——
| 存储 | 求逆 | |
|---|---|---|
| 完整 Fisher / Hessian | $O(m^2n^2)$ | $O(m^3n^3)$ |
| Kronecker 近似 | $O(m^2+n^2)$ | $O(m^3+n^3)$ |
对 $m=n=4096$,这是从 $2.8\times10^{14}$ 个数降到 $3.4\times10^{7}$ 个数——七个数量级。这就是为什么这条线能落地。
为什么工业界用得不多:预处理矩阵的求根 / 求逆很贵(即使摊销到每 N 步一次),实现复杂,且在超大规模上的收益是否稳定存在分歧。但它是 Muon 的直接前身。
7.4 符号 / 谱范数线(2023–2025 最活跃)
Lion (Chen et al., NeurIPS 2023,“Symbolic Discovery of Optimization Algorithms”):用程序搜索搜出来的优化器。
$$u_t = \mathrm{sign}\big(\beta_1 m_{t-1} + (1-\beta_1)g_t\big), \qquad \theta \mathrel{-}= \eta(u_t + \lambda\theta), \qquad m_t = \beta_2 m_{t-1} + (1-\beta_2)g_t$$注意有两个不同的 $\beta$:更新用的插值系数(默认 0.9)和动量本身的衰减(默认 0.99)。只需 1 份状态,省一半优化器内存。
⚠️ 实践要点:学习率要比 AdamW 小 3–10 倍,weight decay 相应放大同样倍数(因为 sign 的更新幅度恒为 $\eta$,比 Adam 略大且无分母缓冲)。不重调超参直接换 Lion 一定发散。
Muon (Keller Jordan et al., 2024):就是 3.2(c) 的谱范数最速下降。
$$M_t = \beta M_{t-1} + g_t, \qquad O_t = \mathrm{NewtonSchulz}(M_t) \approx UV^\top, \qquad W \mathrel{-}= \eta\, O_t$$关键工程点是用 Newton–Schulz 迭代避开显式 SVD。把它跑出来看:
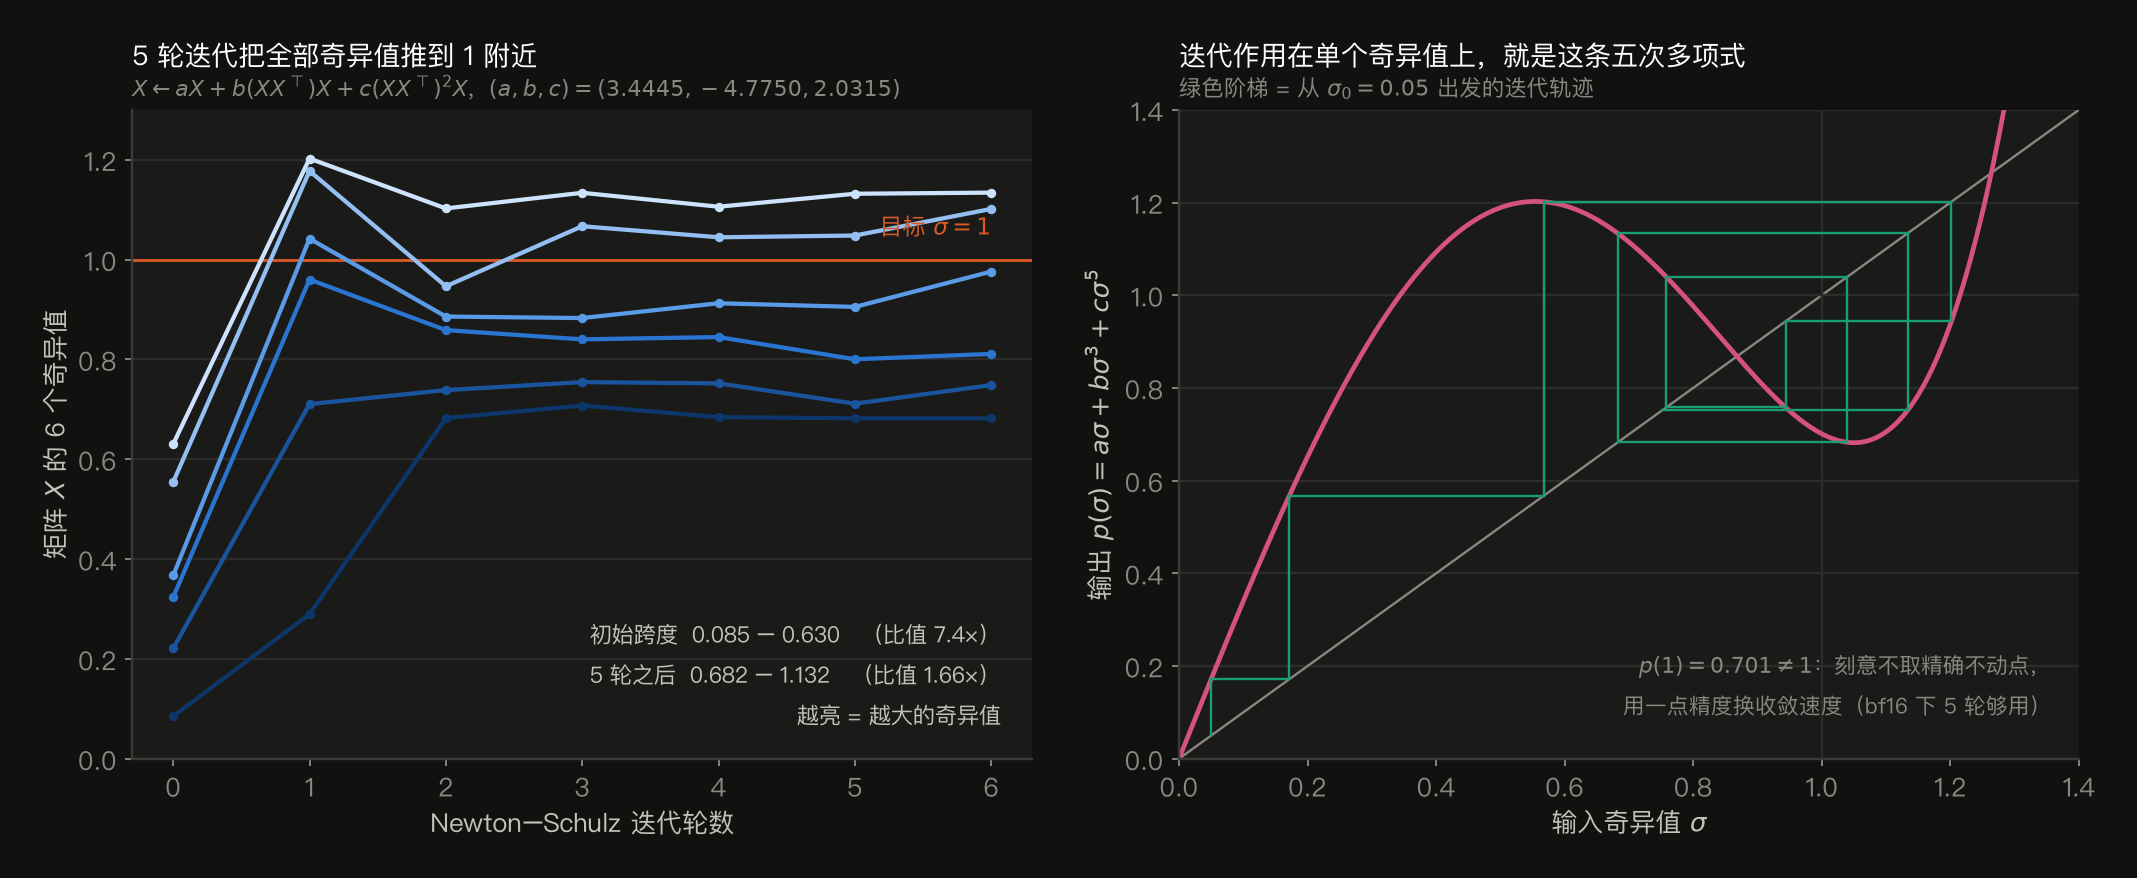
- 迭代作用在单个奇异值上就是一个五次多项式 $p(\sigma)=a\sigma+b\sigma^3+c\sigma^5$。右图的阶梯把这件事变得显然:任何起点都被吸进 1 附近的窄带。
- ⚠️ $p(1) = 0.701 \ne 1$:1 并不是这个迭代的不动点。 系数是"刻意不收敛到精确正交"换来的——牺牲精度让前几轮跨度收缩得极快(7.4× → 1.66× 只用 5 轮),而且整个迭代只用矩阵乘法,能在 bf16 下跑。这是个典型的"算法-硬件协同设计"决策,值得单独记住。
- 只作用于 2D 参数。embedding、lm_head、所有 1D 参数(norm gain、bias)仍用 AdamW。见 3.3 第 3 点。
- 规模化:Moonshot 的 “Muon is Scalable for LLM Training”(2025,Moonlight 模型)补上了两件事——给 Muon 加解耦 weight decay,以及把 Muon 的更新 RMS 缩放到与 AdamW 一致(乘一个 $\propto\sqrt{\max(m,n)}$ 的因子),使 AdamW 的学习率经验可以直接迁移。Kimi K2 用它做了万亿参数级验证。
- 一句话概括价值:它是第 3 章框架的直接产物——把范数从 $\ell_\infty$ 换成谱范数,就在同等状态开销(1 份动量)下拿到了比 AdamW 更快的收敛。
Sophia (Liu et al., 2023) [争议]:用 Hessian 对角的随机估计(Hutchinson 或 Gauss-Newton-Bartlett)代替 $v$,加逐坐标裁剪,声称把 GPT-2 预训练加速 2 倍。独立复现结果不一致,目前不算已确立的结论。列在这里是因为它代表"用真 Hessian 信息而非梯度二阶矩"的方向。
7.5 迭代平均线:Schedule-Free 与 Polyak–Ruppert
这条线对付的还是失效模式 B,但作用点不同:不改每步的更新,而是对迭代轨迹本身做平均。
- Polyak–Ruppert 平均(经典结果):对 SGD 的迭代序列取平均 $\bar\theta_T = \frac{1}{T}\sum_t \theta_t$,在凸问题上可以达到最优渐近方差。深度学习里的对应物就是权重 EMA(见 5.7)。
- Schedule-Free (Defazio et al., 2024):维护两个序列——做梯度步的 $z$,和用于评估的平均 $x$;梯度在两者的插值点 $y=(1-\beta)z+\beta x$ 上求。结果是完全不需要学习率 schedule(不用提前知道总步数,也不用 cosine / warmup 的形状),却能匹配甚至超过调好 schedule 的 AdamW。Schedule-Free AdamW 拿下了 NeurIPS 2024 AlgoPerf 竞赛的 self-tuning 赛道。
为什么值得关注:8.5 会讲到 cosine schedule 的一个硬伤是"必须提前锁定总步数"。这条线是从原理上消除这个约束,而 WSD 只是工程上绕开它。
8. 系统视角:优化器在训练系统里的实际重量
这一章跟推理 / 训练系统方向直接相关,值得单独精读。
8.1 显存账(必须能默算)
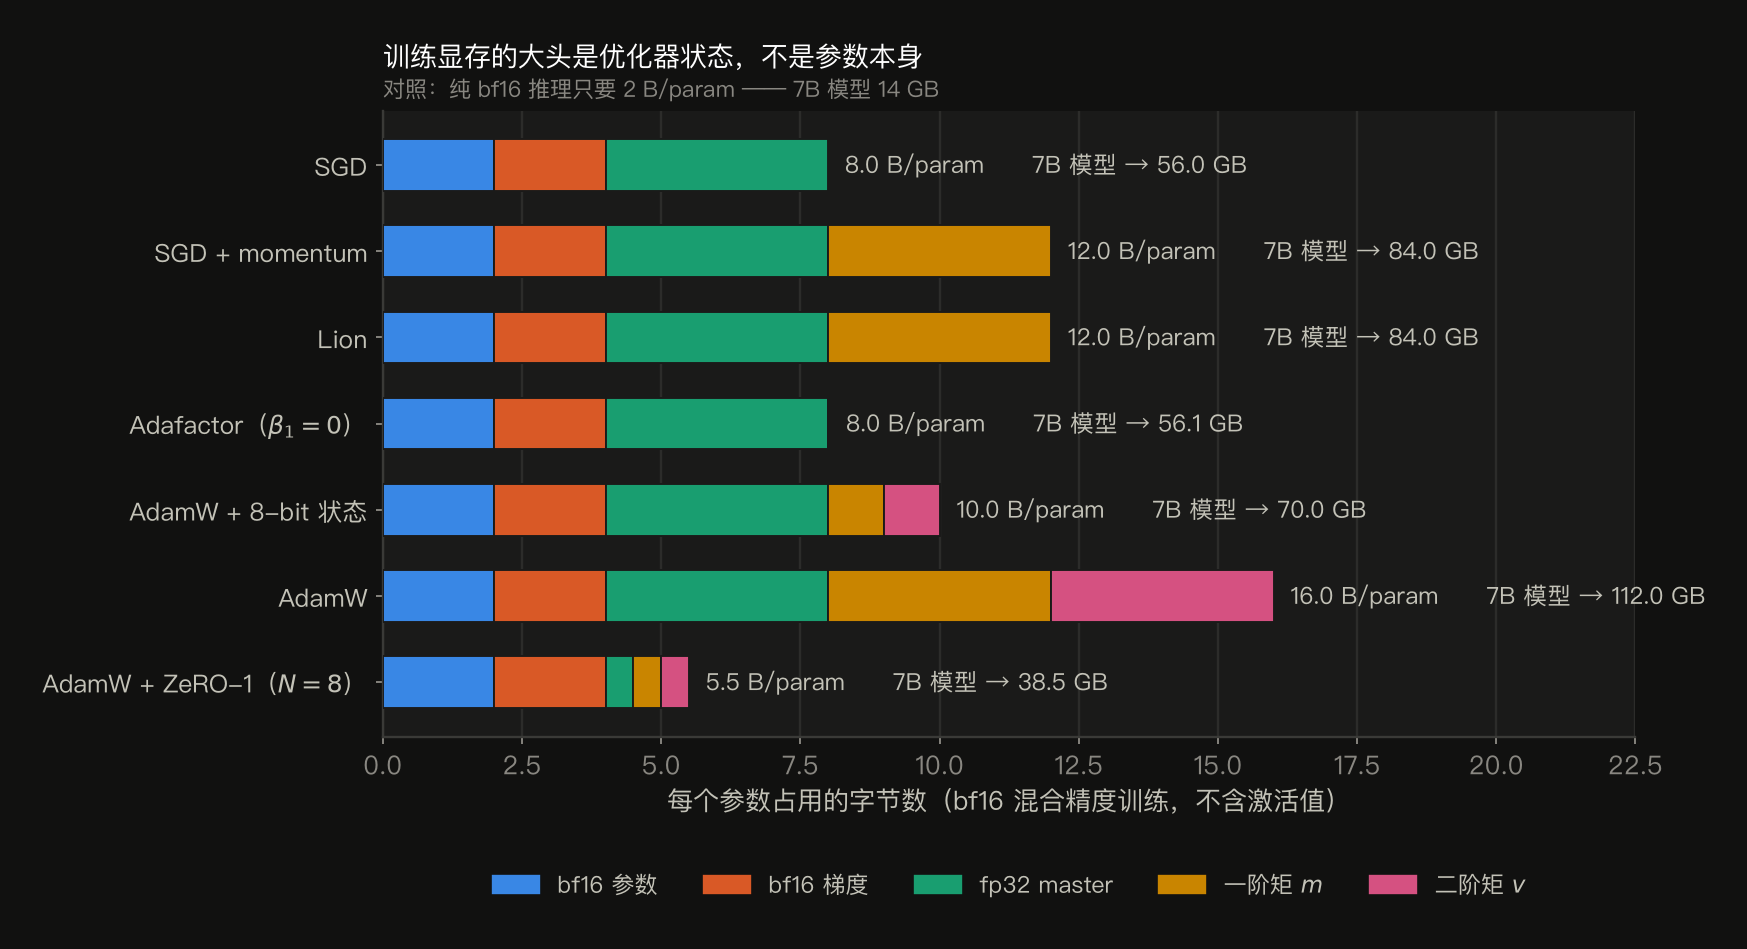
混合精度 + AdamW 的标准配置,每个参数:
| 项 | 精度 | 字节/参数 |
|---|---|---|
| 参数(计算副本) | bf16 | 2 |
| 梯度 | bf16 | 2 |
| 参数(fp32 master 副本,理由见 5.9) | fp32 | 4 |
| Adam $m$ | fp32 | 4 |
| Adam $v$ | fp32 | 4 |
| 合计 | 16 |
这就是 ZeRO 论文里的 $16\Psi$。其中优化器相关的是 12 字节(master + m + v),占 75%。
算例:7B 模型 → $7\times10^9 \times 16 = 112$ GB。单张 80GB H100 放不下,而且这还没算激活值。
对照:纯推理只需要参数本身(bf16 → 2 B/param,7B = 14 GB)。训练比推理贵 8 倍,其中 6 倍来自优化器和 master 权重。 这个 8× 是个值得记住的锚点。
8.2 分布式下优化器状态的处理
- 纯 DDP:梯度做 all-reduce,所有 rank 的梯度相同 → 所有 rank 独立算出完全相同的优化器状态。这是纯冗余,每张卡都存了一份一样的 $m,v$。
- ZeRO-1:把优化器状态(那 12 字节)按 rank 分片。每个 rank 只更新自己负责的参数分片,然后 all-gather 参数。通信量与 DDP 同量级。性价比最高的一档,几乎无脑该开。
- ZeRO-2:再分片梯度。
- ZeRO-3 / FSDP:再分片参数,前向 / 反向时按需 all-gather。通信量上升,但显存降到约 $16\Psi/N$。
- CPU offload / paged optimizer:把状态放 CPU 内存或允许分页换出,用 PCIe 带宽换显存。
8.3 PyTorch 实现的三档
torch.optim.AdamW 有三种执行路径,性能差异不小:
| 模式 | 机制 | 何时用 |
|---|---|---|
foreach=True(CUDA 上默认) | 把同 dtype / device 的张量打包,用 multi-tensor kernel 批量处理,大幅减少 kernel launch | 默认,通用 |
fused=True | 整个 optimizer step 融进单个 CUDA kernel,读写更少 | CUDA + 支持的 dtype,通常最快,推荐显式开启 |
| 逐张量 for 循环 | 每个参数单独若干 kernel | 仅调试 / CPU |
其他工程细节:
optimizer.zero_grad(set_to_none=True)是现在的默认,把.grad置 None 而非填 0,省一次写显存并让第一次累加变成直接赋值。- $m,v$ 是懒初始化的——第一次
step()时才分配。所以峰值显存要在第一步之后才测得到(见练习 4)。 capturable=True用于 CUDA Graph 捕获(要求 step 计数也在 GPU 上)。
8.4 optimizer step 是纯 memory-bound:算一下它到底占多少时间
这一节是"优化器"和"性能工程"的接口,值得自己推一遍。
每个参数搬多少字节(fused AdamW,混合精度):
| 操作 | 字节 |
|---|---|
| 读 bf16 梯度 | 2 |
| 读 + 写 fp32 master 参数 | 4 + 4 |
| 读 + 写 $m$ | 4 + 4 |
| 读 + 写 $v$ | 4 + 4 |
| 写 bf16 参数副本 | 2 |
| 合计 | ≈ 28 |
每个参数算多少 FLOP:两个 EMA 更新(各 2 次乘加)、两次偏差校正、一次 sqrt、一次除、一次 decay、一次减 —— 大约 12–15 FLOP。
$$\text{算术强度} \approx \frac{13}{28} \approx 0.46\ \text{FLOP/byte}$$H100 SXM 的 roofline 拐点约为 $990\ \text{TFLOP/s} \div 3.35\ \text{TB/s} \approx 295$ FLOP/byte。优化器 step 的算术强度比拐点低约 600 倍——它是彻头彻尾的 memory-bound kernel,一个 FLOP 都不值钱。
耗时估算(7B 模型,H100,HBM 3.35 TB/s):
$$7\times10^9 \times 28\ \text{B} = 196\ \text{GB} \quad\Rightarrow\quad \frac{196}{3350} \approx 58\ \text{ms}$$如果一个训练 step 总共 400 ms,优化器就占了约 15%,而它没做任何"有用的"数学。这解释了三件事:
- 为什么
foreach/fused值得开:非融合实现会产生大量中间张量的额外读写和上千次 kernel launch,把这 58 ms 变成几倍。 - 为什么 8-bit Adam 除了省显存还能省时间:状态从 8 字节降到 2 字节,搬运量从 28 降到约 16 B/param,接近腰斩。
- 为什么 Lion / Muon 的"少一份状态"是双重收益:省显存的同时也省带宽。
8.5 学习率 schedule(与优化器强耦合,不能分开调)
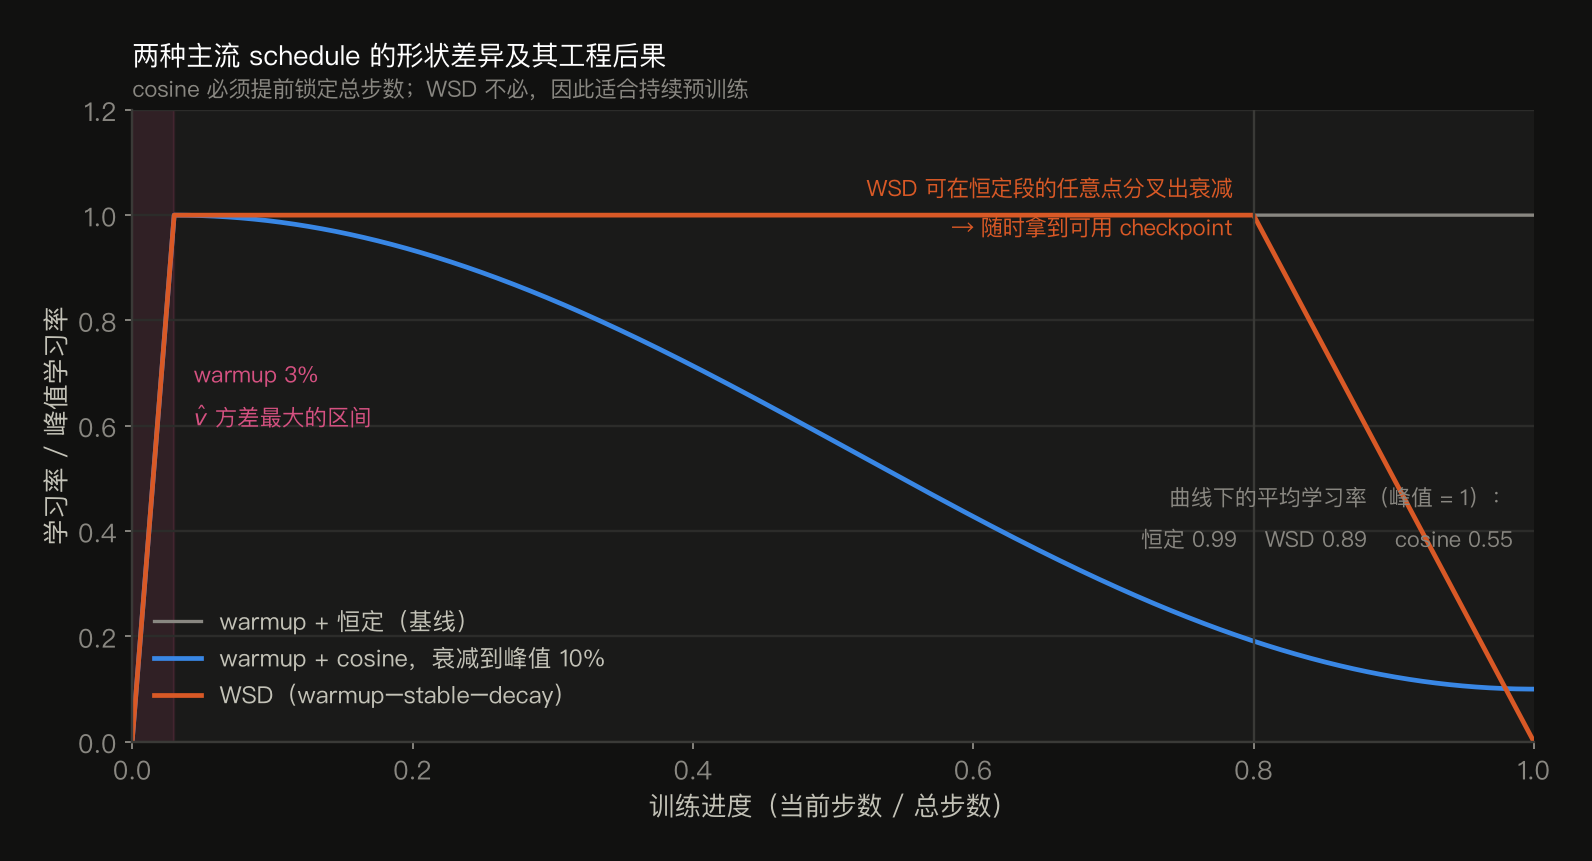
- warmup + cosine 衰减到峰值的 10%:Chinchilla / Llama 系列的标配。缺点是必须提前确定总步数——中途想延长训练,cosine 的形状就错了,只能重来。
- WSD / 梯形(warmup–stable–decay):先 warmup,再长期恒定,最后短暂快速衰减。优点是可以在恒定段的任意点分叉出一个衰减来得到可用 checkpoint,适合持续预训练。MiniCPM、DeepSeek 等采用。
- 图上还有个副产品数字:WSD 曲线下的平均学习率是 0.89,cosine 只有 0.55(以峰值为 1 单位)。这是理解"为什么 WSD 在同等步数下常常不输 cosine"的一个角度——它在大部分时间里都在用满学习率。(注意这只是形状层面的观察,不是因果论证。)
- μP(最大更新参数化):让最优学习率在模型宽度变化时保持不变,从而可以在小模型上调参、迁移到大模型。核心机制就是保持 5.6 那个"相对更新幅度"跨宽度不变。对 Adam,隐藏层权重的学习率需按 $1/\text{fan\_in}$ 缩放。
- Schedule-Free(7.5)从原理上取消了这个 schedule。
8.6 正确性检查清单(这些错误都不报错)
优化器相关的 bug 有一个共同特征:不崩、不报错,只是效果差。所以需要主动检查:
- 用的是
AdamW而不是Adam(weight_decay=)(6.2) - norm / bias 被分到了
weight_decay=0的 param group,且打印出来核对过数量 - 换动量系数时同步改了学习率(如果用 PyTorch SGD)(4.2)
- 梯度累积时 loss 除了累积步数,且
step()只在累积结束时调用(5.7) - DDP 下梯度裁剪在 all-reduce 之后(5.7)
- 换 world size 恢复 checkpoint 时,ZeRO 的分片布局能对上(否则状态会错位,通常表现为 loss 突然跳高然后勉强恢复)
-
lr_scheduler.step()每个 optimizer step 调一次,不是每个 epoch(除非你就是要那样) - 恢复训练时优化器状态和 scheduler 的 step 计数都恢复了(只恢复权重会让 lr 回到 warmup 起点)
- 混合精度下有 fp32 master weights(5.9)
9. 选型与调参
9.1 选型决策树
是 transformer / LLM / 扩散模型?
├─ 是 ──► AdamW  (β1=0.9, β2=0.95, ε=1e-8, wd=0.1, norm/bias 不 decay)
│         ├─ 显存不够? ──► 先开 ZeRO-1;还不够 → 8-bit Adam → Adafactor
│         ├─ 显存和带宽都紧? ──► Lion(少一份状态,但必须重调 lr 和 wd)
│         ├─ batch > 16K? ──► 考虑 LAMB,或直接上 μP
│         ├─ 不想调 schedule? ──► Schedule-Free AdamW
│         └─ 想追新 SOTA / 有工程预算? ──► Muon(2D 参数)+ AdamW(其余)
│
└─ 否 ──► 是卷积网络的图像分类 / 检测?
          ├─ 是 ──► SGD + Nesterov momentum(0.9) + wd 5e-4 + cosine
          │         (这类任务上 SGD 的泛化通常仍优于 Adam,见 5.8)
          └─ 否 ──► 默认 AdamW,先跑通再说
默认答案就是 AdamW。 需要给出充分理由才偏离它。
9.2 调参优先级(按收益从高到低)
- 学习率:唯一最重要的超参。对 AdamW,从 $3\times10^{-4}$ 起步(LLM 预训练常用 $1\text{–}6\times10^{-4}$,随规模增大而减小),按 3 倍或 $\sqrt{10}$ 倍网格扫。
- warmup 长度:总步数 1%–2%。不稳定就加长。
- batch size 与学习率的配对:$B \ll B_{crit}$ 时近似 $\eta\propto B$,$B$ 接近或超过 $B_{crit}$ 时收益饱和(1.4)。这两个区间的边界本身就是要测的。
- weight decay:0.1(LLM)/ 0.01–0.05(视觉)。注意由 6.5,$\eta\lambda$ 的乘积才决定有效学习率,$\eta/\lambda$ 的比值决定权重平衡范数——改一个就动了两件事。
- $\beta_2$:稳定性出问题时从 0.999 降到 0.95(5.5)。
- $\epsilon$:一般不动;数值不稳定时调大。
- $\beta_1$:几乎不用动(0.9)。
9.3 训练不稳定的排查顺序
- 先看 grad norm 曲线。是否有 spike?clip 是否生效(clip 到 1.0,但 pre-clip norm 是多少)?
- 看 loss spike 与 grad spike 的时间关系。grad 先炸 = 数据 / 数值问题;loss 先炸 = 优化器步子太大。
- 降 $\beta_2$ 到 0.95(让分母跟上)——5.5 的图就是它为什么有效的机制说明。
- 加长 warmup / 降峰值 lr。
- 检查是否用了 fp16 而非 bf16。fp16 需要 loss scaling,动态 loss scale 的调整会与 Adam 状态产生复杂交互;bf16 基本没这问题。
- 检查 norm 层和 bias 是否被错误地 decay 了。
- 检查是否误用了
Adam(weight_decay=)而非AdamW。 - 区分"锯齿"和"spike":小尺度持续锯齿可能就是 edge of stability 的正常形态(1.3),不必干预;单点跳高才是 spike。
9.4 loss spike:成因与止血
LLM 训练里 spike 是常态问题,值得单列。优化器只是止血的一环,成因常在架构侧:
| 成因 | 典型证据 | 常见对策 |
|---|---|---|
| attention logits 爆炸 | spike 时 attention 熵骤降、logit 幅值飙升 | QK-norm(对 Q、K 做 RMSNorm);logit soft-cap |
| 输出 logits 漂移 | 词表 logits 整体量级增长 | z-loss(惩罚 $\log Z$);lm_head 不共享权重时更易发生 |
| 单个坏 batch / 脏数据 | spike 与特定 data shard 强相关,跳过就没了 | 数据清洗;跳过该 batch |
| 优化器状态被污染 | spike 后几百到几千步都恢复不了 | 降 $\beta_2$(5.5 的图直接量化了这个恢复时长:3114 步 vs 137 步);更严格的 clip |
| 数值下溢 / 上溢 | fp16 的 loss scale 反复回退 | 换 bf16 |
⚠️ 注意最后一栏的第四行:“spike 之后长期恢复不了"这个现象本身就是 $\beta_2$ 太大的指纹。看到 loss 尖峰后 lr 像被人偷偷调小了几千步,先怀疑 $\beta_2$,不要先怀疑数据。
10. 自检 26 问
能流畅答出 20 题以上,这个主题就算过关了。
基础层
- SGD 的迭代次数与 Hessian 条件数是什么关系?动量把它改善到什么量级?
- PyTorch 的
SGD(momentum=0.9)和 Adam 的一阶矩 EMA,公式差在哪?把 momentum 从 0.9 改到 0.99,你必须同时改什么? - Nesterov 相比 heavy ball 多做了什么?
- AdaGrad 的原始动机是什么?它的致命缺陷是什么?RMSProp 用一行改动怎么修的?
- 写出 Adam 的完整更新式(含偏差校正)。
- Adam 的步数为什么与条件数无关?这说明它的收敛由什么决定?
理解层
- Adam 的偏差校正在 $t=1$ 时,把更新量放大了还是缩小了?给出数字。它的最坏情况在第几步?
- Adam 的第一步,每个参数移动多远?
- 为什么 Adam 已经有偏差校正了还需要 warmup?
- 为什么把 loss 乘以 10 对 Adam 几乎无影响,对 SGD 等价于改学习率?
- “Adam ≈ sign-SGD” 这个近似在什么条件下成立?它解释了哪三件事?
- Adam 里的 $\epsilon$ 除了防除零还有什么作用?调大它会让优化器往哪个方向退化?
- 为什么 LLM 训练把 $\beta_2$ 从 0.999 降到 0.95?在"抗尖峰"和"恢复速度"两件事上,哪个 $\beta_2$ 赢?
- AdaGrad 在梯度尺度变小之后,有效学习率是继续加速衰减、还是停在原处?为什么?
- Adam 有什么已知的理论问题?AMSGrad 怎么修的?为什么实践中不用?
- progressive sharpening 和 edge of stability 是什么?它们如何改变你对"学习率"的理解?
AdamW
- 为什么 L2 正则在 SGD 里等于 weight decay,在 Adam 里不等于?
- Adam+L2 的实际效果是"梯度大的参数被衰减得更多还是更少”?为什么?
Adam(weight_decay=0.1)和AdamW(weight_decay=0.1)的实际衰减量差多少量级?- 哪些参数不应该做 weight decay?为什么?
- AdamW 下权重的每坐标平衡 RMS 是多少?推一遍。$\eta\lambda$ 的乘积和 $\eta/\lambda$ 的比值各决定什么?
分支与系统
- 用"信任域 + 范数选择"的框架,分别导出 SGD、sign-SGD、Muon 对应的是哪个范数,以及各自的最优值等于什么范数。
- Shampoo 的 Kronecker 分解把 $4096\times4096$ 层的预处理器存储和求逆成本各降低多少数量级?
- Muon 为什么只作用于 2D 参数?Newton–Schulz 的 $p(1)\ne 1$ 说明了什么设计取舍?
- 混合精度 AdamW 训练每个参数占多少字节?拆开说明每一项。为什么必须有 fp32 master weights(用 bf16 的相对精度和单步相对更新量算一下)?
- 估算 7B 模型在 H100 上一次 AdamW step 的耗时。它是 compute-bound 还是 memory-bound?算术强度是多少?
11. 动手练习(代码你自己写,这里只给验收标准)
按一贯的方式:不给骨架,只给验收条件。做完这五题,理解会从"看懂"变成"拥有"。所有验收数字都能在本文的图里对照。
练习 1:复现第 1 章的三张收敛图
- 要求:二次型 $L=\frac{1}{2}(\kappa\theta_1^2+\theta_2^2)$,实现 GD / heavy ball / Adam,各用自己的最优参数。
- 验收标准:
- $\kappa=100$、起点 $(1,1)$、阈值 $\|\theta\|_\infty<0.05$ 时,步数应为 GD 150、动量 36、Adam 163($\eta_{\text{adam}}=0.01$);
- 把 $\kappa$ 扫过 $2\to10^4$,log-log 上三条线的斜率应为 1 / 0.5 / 0;Adam 的步数应恒为 163;
- 你能解释为什么动量的单步震荡幅度比 GD 更大,但总步数少 4 倍;
- 把 $\eta$ 设成 $2.1/\lambda_1$ 时 GD 必须发散(验证 $\eta<2/\lambda_1$ 这个上界)。
练习 2:从零实现 Adam,与 torch.optim.Adam 数值对拍
- 验收标准:
- 固定种子,同一组参数跑 100 步,与
torch.optim.Adam(foreach=False)的参数最大绝对误差 < 1e-6(fp32); - 关掉偏差校正再跑,验证 $t=1$ 的更新量比开启时大 3.16 倍,且比值在 $t=12$ 达到峰值 6.57 倍;
- 打印第 1 步每个参数的更新量,确认其绝对值 $\approx \eta$;
- 构造"每步 $g=1$、第 300 步 $g=30$“的序列,验证 $\beta_2=0.999$ 时尖峰当步放大 1.85×、$\beta_2=0.95$ 时压到 0.58×,且恢复到稳态 ±2% 分别需 3114 步和 137 步。
- 固定种子,同一组参数跑 100 步,与
练习 3:复现 AdamW 与 Adam+L2 的差异
- 要求:同一个小模型(3 层 MLP + LayerNorm),分别用
Adam(weight_decay=λ)和AdamW(weight_decay=λ),用同一个 λ。 - 验收标准:
- 两者的权重范数曲线必须显著分离;
- 你能用实测的 $\sqrt{\hat v}$ 均值估算出"要让 Adam+L2 达到与 AdamW 相同的实际衰减量,λ 需要缩小多少倍”,量级应在 $10^2\text{–}10^3$;
- 用 AdamW 长跑到平衡,验证每坐标权重 RMS $\approx\sqrt{\eta/2\lambda}$(误差 10% 内),并验证它与张量维度无关;
- 分组实验:把 LayerNorm 的 gain 加入 / 排除 decay,观察它是漂向 1 还是漂向 0。
练习 4:显存与耗时账实测
- 验收标准:
- 用
torch.cuda.max_memory_allocated()测一个几百 M 参数模型在 bf16 混合精度 + AdamW 下的峰值显存,能把实测值拆解成参数 / 梯度 / master / m / v / 激活六项,并解释残差从哪来; - 换成
SGD(momentum=0.9)后,优化器状态部分应减少约 8 B/param,实测能对上; - 在
step()前后各测一次,能观察到 $m,v$ 是懒初始化的; - 用 CUDA event 单独计时
optimizer.step(),与 8.4 的 $28\ \text{B/param} \div \text{HBM 带宽}$ 估算对比,误差应在 2 倍以内;分别测fused=True/foreach=True/ 都关,记录三档差异。
- 用
练习 5:量一遍你自己模型的尺度异质性(填 1.5 的空)
- 要求:在一个真实 transformer(哪怕是 nanoGPT 规模)上,逐参数块记录梯度范数。
- 验收标准:
- 输出一张表:每个参数块的 $\|g\|_2$、$\|g\|_\infty$、以及 $\|g\|/\sqrt{\text{numel}}$(逐元素 RMS,这才是可跨块比较的量);
- 报告最大块与最小块的逐元素 RMS 之比,并观察它在训练过程中是收敛还是持续存在;
- 对同一个模型分别跑 SGD 和 AdamW 各 200 步,验证 AdamW 下各块的相对更新幅度 $\|\Delta\theta_l\|/\|\theta_l\|$ 远比 SGD 下均匀——这就是失效模式 C 被修掉的直接证据;
- 拿到数字后回来把 1.5 那一节补完。
附录 A:一页速查表
| 更新式核心 | 状态 | 修哪个失效模式 | 主要用途 | |
|---|---|---|---|---|
| SGD | $-\eta g$ | 0 | — | 基线 |
| Momentum | $m=\beta m+g$ | $1\times$ | A, B | CV,凸问题 |
| Nesterov | 前瞻点取梯度 | $1\times$ | A, B | CV |
| AdaGrad | $/\sqrt{\sum g^2}$ | $1\times$ | C(稀疏) | 已淘汰 |
| RMSProp | $/\sqrt{\text{EMA}(g^2)}$ | $1\times$ | A, C | RNN 时代 |
| Adam | $\hat m/(\sqrt{\hat v}+\epsilon)$ | $2\times$ | A, B, C | 通用基线 |
| AdamW | Adam + 解耦 wd | $2\times$ | A, B, C + 正则 | 当代默认 |
| AMSGrad | $v\leftarrow\max(v_{t-1},v_t)$ | $3\times$ | 同 Adam | 理论修补,实践不用 |
| Adafactor | $v$ 秩 1 分解 | $\approx0.1\times$ | 同 Adam | 省显存(T5) |
| 8-bit Adam | 状态分块量化 int8 | $0.5\times$ | 同 Adam | 省显存 + 省带宽 |
| LAMB | Adam + 逐层 trust ratio | $2\times$ | + 层间 C | 超大 batch |
| Lion | $\mathrm{sign}(\text{插值动量})$ | $1\times$ | A, B, C | 省显存,需重调 lr |
| Schedule-Free | 梯度在 $z,x$ 插值点求 + 平均 | $2\times$ | B(末端) | 免 schedule |
| Shampoo / SOAP | Kronecker 预处理 | $\ge2\times$ + 矩阵 | A(跨坐标) | 追求收敛速度 |
| Muon | 动量 → Newton-Schulz 正交化 | $1\times$ | A(谱意义) | 2025 前沿,配 AdamW |
默认超参速记(LLM 预训练):AdamW,$\eta = 3\times10^{-4}$(随规模下调),$\beta_1=0.9$,$\beta_2=0.95$,$\epsilon=10^{-8}$,wd $=0.1$(norm / bias 除外),grad clip $=1.0$,warmup 占总步数 1%–2%,cosine 衰减到峰值 10%,fused=True。
几个值得记住的数:AdamW 混合精度 16 B/param;训练比推理贵 8×;优化器 step 算术强度 0.46 FLOP/byte;7B 在 H100 上一次 step 约 58 ms;权重平衡 RMS $=\sqrt{\eta/2\lambda}$。
附录 B:不报错但会毁掉训练的错误清单
- 用
Adam(weight_decay=)当 AdamW(差约 1000 倍衰减强度) - 改动量系数没同步改学习率(PyTorch SGD 有 $1/(1-\beta)$ 放大)
- norm / bias 忘了排除 weight decay(gain 缓慢漂向 0)
- 梯度累积时在每个 micro-batch 上
step()(等效 batch 缩小 N 倍) - 梯度累积时 loss 没除以累积步数
- DDP 下在 all-reduce 之前裁剪梯度
- 混合精度没有 fp32 master weights(后期更新被 bf16 舍入吃掉)
- 恢复 checkpoint 只恢复权重,不恢复优化器状态 / scheduler 步数
- 换 world size 后 ZeRO 分片布局对不上
lr_scheduler.step()调用频率错(每 epoch vs 每 step)- 换优化器(Adam → Lion / Muon)不重调学习率和 weight decay
- 把 CV 的"SGD 泛化更好"经验直接搬到 LLM
附录 C:术语英中对照(读论文用)
| 英文 | 中文 | 出现在 |
|---|---|---|
| ill-conditioning | 病态(条件数大) | 1.1 |
| condition number | 条件数 | 1.2 |
| progressive sharpening / edge of stability | 渐进锐化 / 稳定边界 | 1.3 |
| gradient noise scale / critical batch size | 梯度噪声尺度 / 临界批量 | 1.4 |
| preconditioner | 预处理器 | 1.6 |
| steepest descent under a norm | 某范数下的最速下降 | 3.1 |
| dual norm | 对偶范数 | 3.1 |
| trust region | 信任域 | 3.1 |
| bias correction | 偏差校正 | 5.1 |
| decoupled weight decay | 解耦权重衰减 | 6.2 |
| scale-invariant | 尺度不变(层) | 6.4 |
| trust ratio | 信任比 | 7.2 |
| Kronecker factorization | Kronecker 分解 | 7.3 |
| Newton–Schulz iteration | Newton–Schulz 迭代 | 7.4 |
| Polyak–Ruppert averaging | Polyak–Ruppert 平均 | 7.5 |
| arithmetic intensity / roofline | 算术强度 / 屋顶线 | 8.4 |
| maximal update parametrization (μP) | 最大更新参数化 | 8.5 |
附录 D:主要文献
基础
- Polyak (1964) — heavy ball momentum
- Nesterov (1983); Sutskever et al. (ICML 2013) — NAG 及其深度学习重参数化
- Duchi, Hazan & Singer (JMLR 2011) — AdaGrad
- Hinton, Coursera Neural Networks Lecture 6e — RMSProp(无正式论文)
- Zeiler (2012) — Adadelta
- Kingma & Ba (ICLR 2015) — Adam
- Reddi et al. (ICLR 2018) — “On the Convergence of Adam and Beyond”(AMSGrad)
- Défossez et al. (2020); Zhang et al. (2022) — Adam 收敛性的后续修补
- Loshchilov & Hutter (ICLR 2019) — AdamW / 解耦 weight decay
- Liu et al. (ICLR 2020) — RAdam / warmup 的方差解释
训练动力学
- Cohen et al. (ICLR 2021) — progressive sharpening / edge of stability
- Cohen et al. (2022) — “Adaptive Gradient Methods at the Edge of Stability”
- McCandlish et al. (2018) — “An Empirical Model of Large-Batch Training”(梯度噪声尺度)
- Van Laarhoven (2017) — L2 与归一化的交互(有效学习率)
内存
- Shazeer & Stern (ICML 2018) — Adafactor
- Dettmers et al. (ICLR 2022) — 8-bit Optimizers
- Rajbhandari et al. (SC 2020) — ZeRO
- Zhao et al. (2024) — GaLore;Zhang et al. (2024) — Adam-mini
大 batch / 参数化
- You et al. (2017) — LARS;You et al. (ICLR 2020) — LAMB
- Yang & Hu (2021) — Tensor Programs V / μP
二阶与新方向
- Martens & Grosse (ICML 2015) — K-FAC
- Gupta, Koren & Singer (ICML 2018) — Shampoo;Anil et al. (2020) — Distributed Shampoo
- Vyas et al. (2024) — SOAP
- Chen et al. (NeurIPS 2023) — Lion
- Jordan et al. (2024) — Muon;Moonshot AI (2025) — “Muon is Scalable for LLM Training”
- Bernstein & Newhouse (2024) — “Old Optimizer, New Norm” / “Modular Duality in Deep Learning”(第 3 章的范数视角)
- Defazio et al. (2024) — “The Road Less Scheduled”(Schedule-Free)
Adam 为何有效(尚无定论)
- Zhang et al. (2020) — “Why are Adaptive Methods Good for Attention Models?"(重尾噪声)
- Kunstner et al. (2023) — “Noise Is Not the Main Factor Behind the Gap Between SGD and Adam”
- Kunstner et al. (2024) — 重尾类别不平衡假说
- Zhang et al. (2024) — “Why Transformers Need Adam: A Hessian Perspective”
配图脚本:images/optimizers/make_figures.py(python make_figures.py 即可全部重算重绘,依赖 scripts/mathviz.py)