视频: https://youtu.be/26FtD08ZpOU | 频道: Stanford Online | 发布时间: 2026-06-04 时长: 1h17m40s | 播放量: 8634 (记录时) | 分类: llm 讲者: Percy Liang | 讲义: https://github.com/stanford-cs336/lectures/blob/main/lecture_17.py (本讲是可执行讲义,没有 PDF;引用的图在 https://github.com/stanford-cs336/lectures/tree/main/images )
视频简介: 这是 CS336 讲多模态的一讲,由 Percy Liang 主讲。它要回答的问题很具体:前面十几讲我们一直在处理 text ⇒ text,而现在的前沿模型都被期待是 natively multimodal 甚至 omni 的——任意模态进、任意模态出。但 transformer 只会说 token,所以一切非文本模态都必须先被转成 token,这一步怎么做?讲座只讲输入侧(理解),把这一侧的方法按时间线捋了一遍:从 2021 年的 CLIP 用对比学习把图像压成语义向量,到 SigLIP 把多分类换成二元分类换来 4 倍训练效率,再到 LLaVA 用一个线性投影把视觉向量塞进语言模型、Qwen 系列一路把分辨率、位置编码、模态配比和训练流水线工程化到 235B 的 Qwen3-VL。最后用 Meta 的 Chameleon 收尾,讨论把图像也离散成 token、用一个自回归模型统一处理所有模态这条"优雅但不划算"的路线。
§1 开场:为什么语言模型必须学会看图
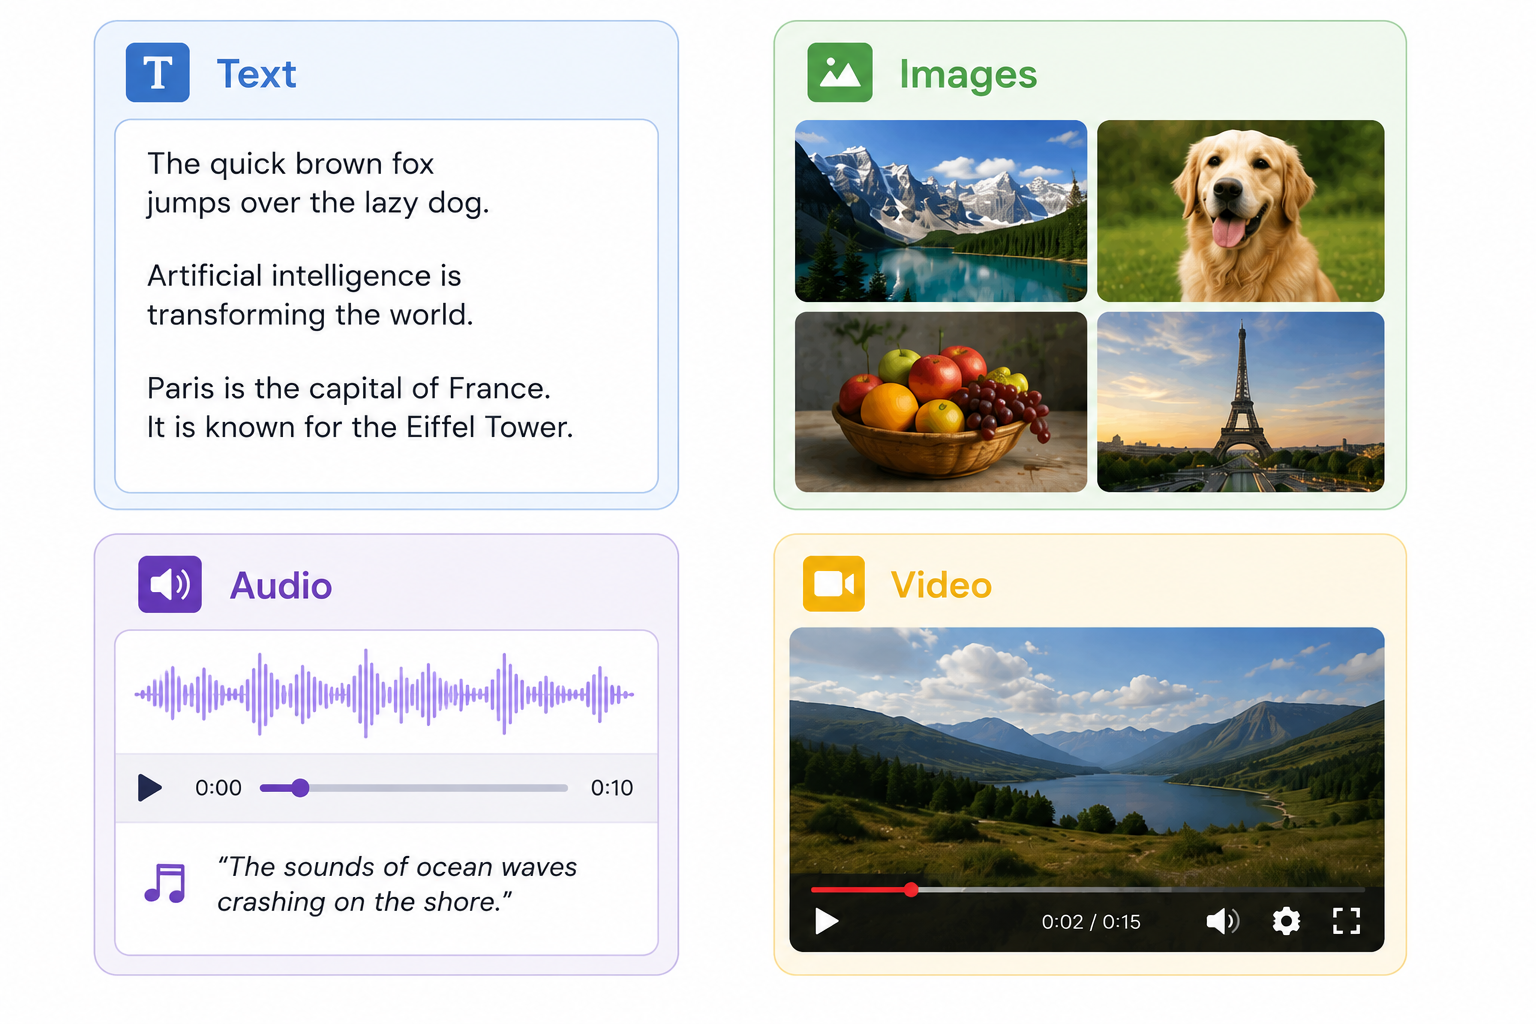
CS336 讲到第十七讲,主题一直是语言模型:输入 text,输出 text。但 Percy 开场的第一张图就把问题摊开了——真实世界是多模态的,文本只是其中一格。讲义图 images/multimodality.png 把四类数据并排放:Text(“The quick brown fox jumps over the lazy dog."、“Paris is the capital of France.")、Images(雪山湖泊、金毛犬、水果篮、埃菲尔铁塔)、Audio(一段波形,配一句"The sounds of ocean waves crashing on the shore.",进度条显示 0:00 到 0:10)、Video(一段 15 秒的风光片,进度条停在 0:02 / 0:15)。
终极目标是 omni model:任意模态组合作为输入(understanding,理解),任意模态组合作为输出(generation,生成)。但"今天能站在哪里"这件事,先被 transformer 本身的性质限制住了。逻辑链是这样的:transformer 真的很好用,所以我们必须用它;而 transformer 只会说 token——离散或连续的 token,每个 token 代表某个"语义单元"量级的信息;因此任何东西想进这个模型,都必须先被转成 token。文本这条路我们已经走通了(第一讲的 tokenization 就是在解决这件事,把字节流切成 50k 量级的词表),非文本模态则困难得多。
于是在这个框架下,多模态只剩下两个真问题:
- 怎么把非文本数据输进去(例如理解图像)?
- 怎么把非文本数据输出出来(例如生成音频)?
这一讲只讲第一个问题。第二个问题在收尾时会再回到,Percy 的观点是:输出侧大概率要靠 diffusion,而输入侧大概率还是连续的 encoder——但那是推测,不是讲义里能给出证据的部分。
§2 CLIP:用对比学习把图像压成语义向量
2.1 动机:标注瓶颈
Percy 把时钟拨回 ‘21——原话是 “rewind the clock back to 21”——那一年 GPT-3 已经发生了,语言模型已经进入 foundation model 时代,而计算机视觉还停留在"用人工标注的图像训练分类器"的范式里。CLIP 问的是一个很朴素的问题:既然网上存在海量的 (image, caption) 配对,能不能不用人工标注,直接把这些天然配对当成监督信号?
CLIP 的全名是 Contrastive Language-Image Pretraining(论文 https://arxiv.org/abs/2103.00020 )。
2.2 方法:一个 batch 里的 2N 个分类问题
做法如下。取一个 batch 的 (image, text) 样本,Percy 口述的约数是 32,000(讲义图里 figcaption 用的是精确值 32768)。把每张图、每段文本各自编码成向量,然后要求:对每张图,它自己的配对文本的相似度要高于 batch 里其他所有文本;对每段文本,它自己的配对图像的相似度也要高于其他所有图像。把相似度排成一个 $N \times N$ 的矩阵,对角线是全对齐的正例,其余全是负例。
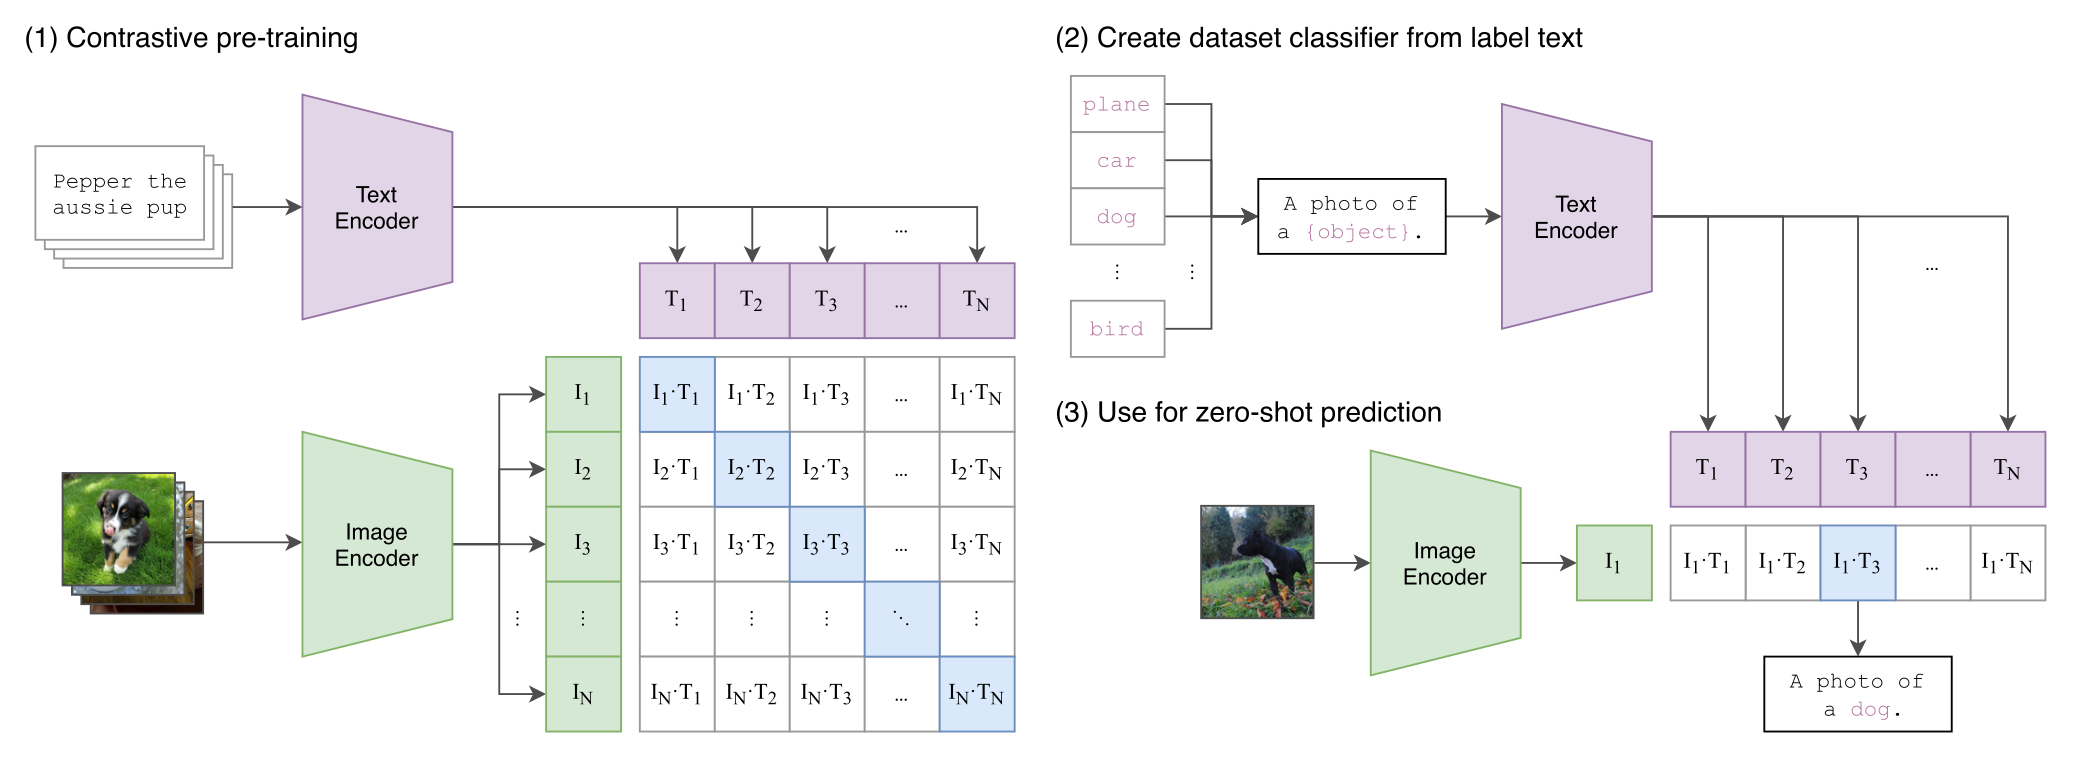
讲义图 images/clip.png 把 CLIP 的完整用法画成三块。
(1) Contrastive pre-training:文本编码器与图像编码器各出一个向量,两两做点积得到 $I_i \cdot T_j$ 矩阵,对角线高亮。
(2) Create dataset classifier from label text:把类别名套进模板变成句子 “A photo of a {object}.",比如 plane / car / dog / bird,过文本编码器得到每类的文本向量。
(3) Use for zero-shot prediction:来一张新图,编码成 $I_1$,与所有类别文本向量算点积,最大的那个就是预测类别——输出了 “A photo of a dog."。这就是"zero-shot"的含义:ImageNet 的 1000 个类名从未参与训练,只是作为文本被喂进文本编码器。
Percy 强调这里的结构:这本质上就是 $2N$ 个 softmax 分类问题,只不过样本被排成了矩阵形式,正例落在对角线上,算的是一个对称的 cross entropy。讲义直接把这一步的伪代码印了出来:
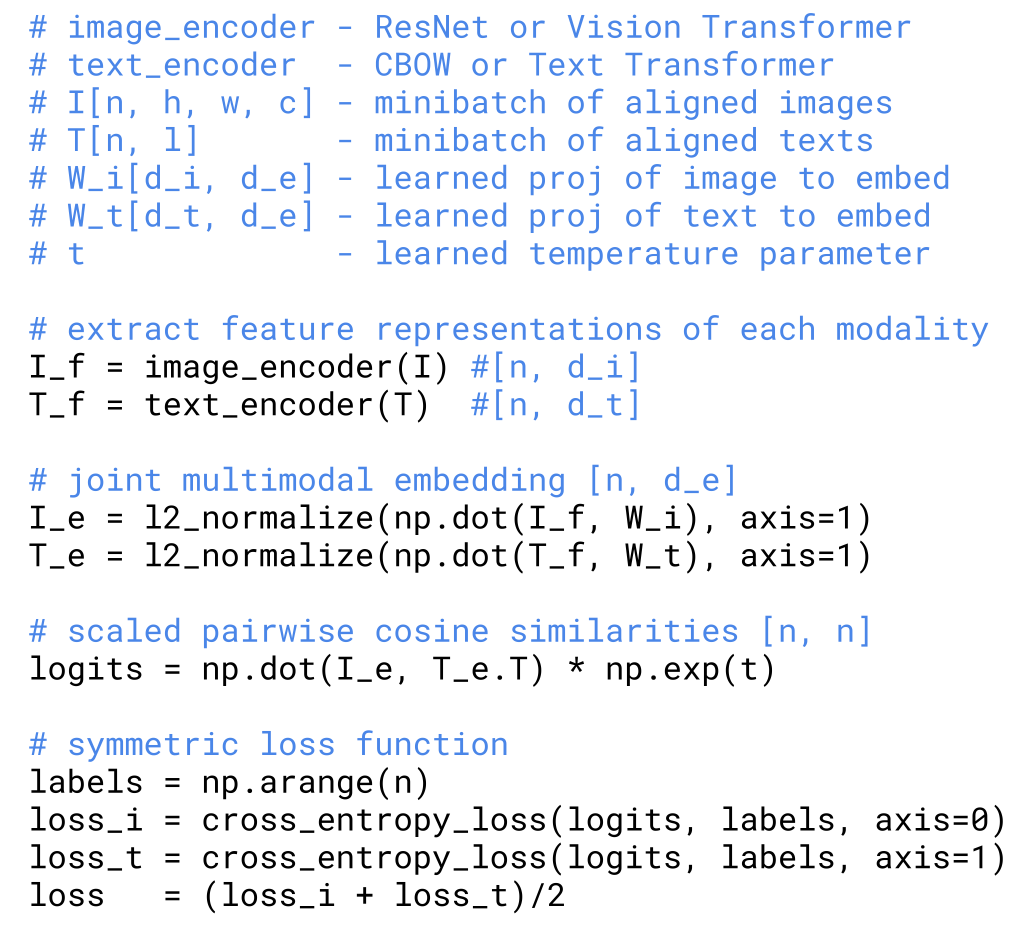
这段代码里藏着几个容易被口头讲述盖过去的细节:图像侧和文本侧各有一个学到的投影矩阵 W_i[d_i, d_e] 和 W_t[d_t, d_e],把两路特征投到同一个 $d_e$ 维空间;投完之后做 l2_normalize;相似度是 logits = np.dot(I_e, T_e.T) * np.exp(t),其中 t 是一个学到的温度参数——注意它写成 exp(t),也就是温度可通过指数任意放大缩小而不受正负约束;最后 loss_i = cross_entropy(logits, labels, axis=0)、loss_t = cross_entropy(logits, labels, axis=1)、loss = (loss_i + loss_t) / 2。图像→文本和文本→图像两个方向各算一次再平均,这就是"对称"的含义。
2.3 数据:400M 配对,一个没有发布的数据集
论文里对数据来源说得很含糊。大致做法是:拿一批查询词去网上搜,把搜到的图像和它周围的文本一起挖下来,每个 query 大约得到 20,000 个 (image, text) 配对;总共 500K 条查询,最后得到 400 million(4 亿)image-text 配对。这个数据集没有公开。
它的公开复现是 OpenCLIP(https://arxiv.org/abs/2212.07143 ),用的是 LAION-5B——一个 5 billion(50 亿)量级的图像加文字描述数据集。有意思的是 LAION-5B 本身是用 CLIP 做过滤的:先用已有的 CLIP 模型给网页图文对打分,只留下分数高的。这形成了一个 bootstrap 循环:CLIP 定义了什么是好配对,然后好配对又用来训更好的 CLIP。
2.4 预处理:短边缩放到 336 再中心裁剪
图像尺寸五花八门(任意 W × H),CLIP 的处理是:用 bicubic 插值把短边缩放到 336 像素,再 center crop 成 336 × 336——也就是把超出的边框直接切掉。Percy 特意指出 224 也可以是这个目标尺寸(后来的模型多用 224)。这个 center crop 是个很粗暴的启发式,后面讲 LLaVA OneVision 时会看到它成了要解决的问题:文档类图像裁到 336 × 336 以后根本读不出字。
§3 CLIP 的细节:ViT、文本编码器与实验结果
3.1 Vision encoder:从 ResNet 到 ViT
CLIP 论文试了 ResNet-50 和 Vision Transformer 两条路(ViT 论文 https://arxiv.org/pdf/2010.11929 )。讲义给出的 ViT 结构图是这样的:
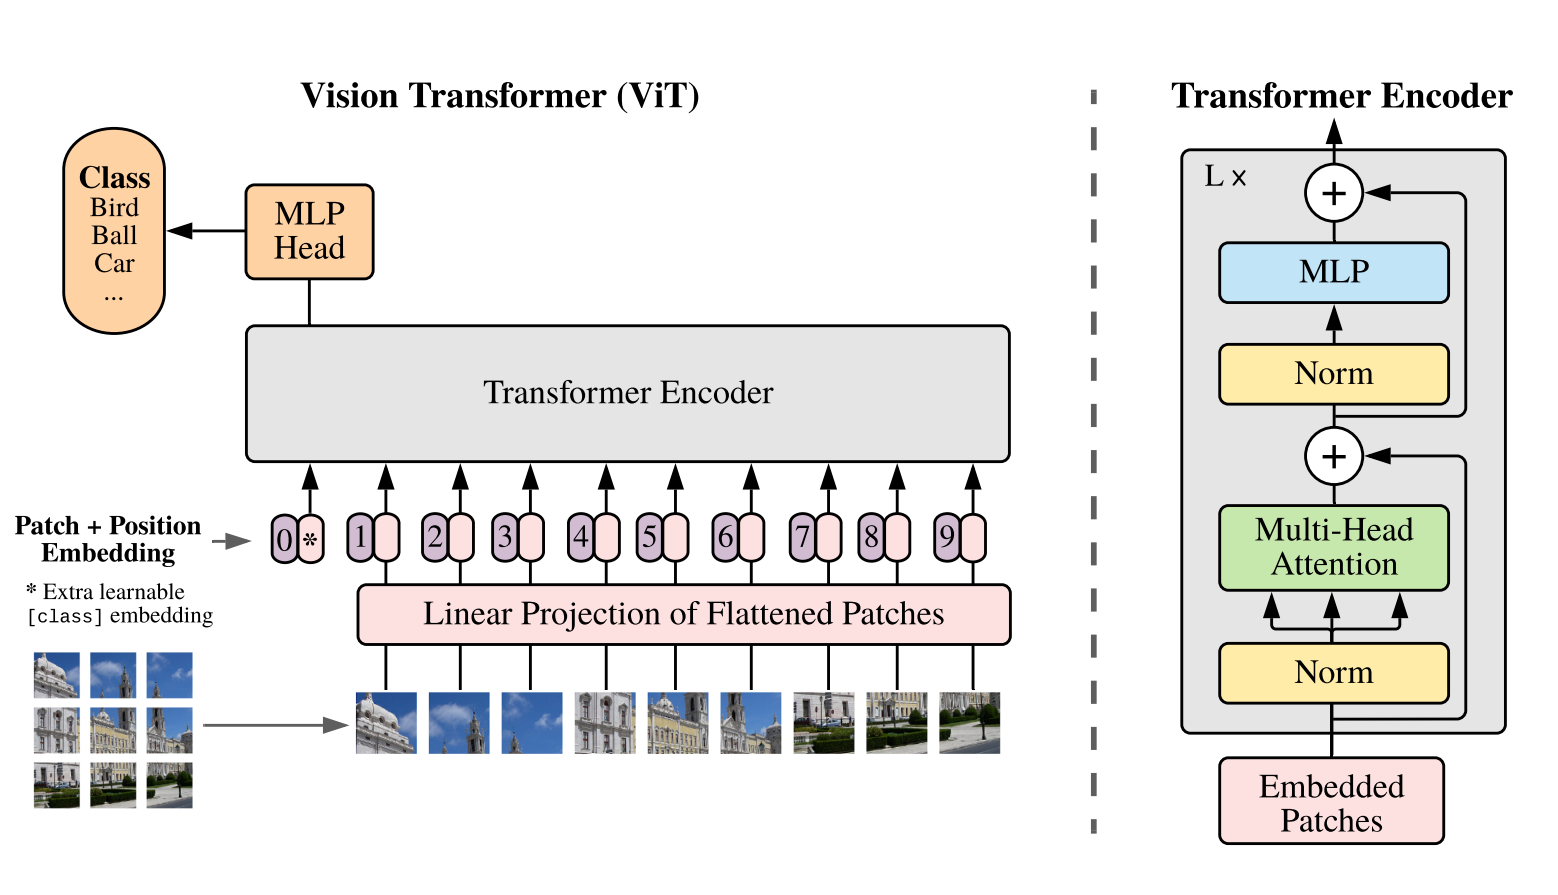
图的左侧把流程画得很直白:一张大图先被切成 patch(图中标了编号 0 到 9,也就是 10 个 patch),每个 patch 展平后做线性投影(Linear Projection of Flattened Patches),再加上位置编码,另外额外塞一个可学习的 [class] embedding(图中标成 0*);这一串 token 过一个标准的 Transformer encoder——Norm → Multi-Head Attention → Norm → MLP,每块都带残差连接,重复 $L$ 次;最后取 [class] 位置的输出过一个 MLP Head 得到分类。
CLIP 的 attention pooling 有个细节:做 QKV 时,query 用的是所有激活的全局平均,而不是只取某一个位置。这个设计带来的直接后果就是"没有位置依赖的输出”——整张图最后被压成一个向量,这对后面的对比学习是必需的。
最佳配置是 ViT-L/14@336px。Percy 逐字拆了这个名字:L 是 large,14 × 14 是 patch 大小(image patch 尺寸,原文说最初的 ViT 论文用的是 16 × 16,CLIP 改成了 14 × 14),3 是通道数,336 是训练分辨率。他顺口提到这个 L 模型"大概有 24 层左右”。
3.2 文本编码器:GPT-2,取 EOS 位置的激活
文本侧用的是 GPT-2 风格的 Transformer——因为 CLIP 和 GPT-2 出自同一个组织(OpenAI)。规模是 63M 参数、12 层。编码方式很干脆:把 [BOS] ... [EOS] 整个序列喂进去,取最高层 [EOS] 位置的激活作为整句的表示。用最后一个 token 的隐藏状态来代表整句,是这一类 encoder 的标准做法。
3.3 头条结果与消融
真正让 CLIP 在 2021 年引爆关注的是这个数字:在 ImageNet 上,zero-shot 的 CLIP 超过了在 1.2 million(120 万)张 ImageNet 图像上训练过的 ResNet。Percy 特意补了上下文——1.2 million 张图的标注是"很多很多小时的 Amazon Mechanical Turk 人工工时”,而 CLIP 一次标注都没用。
消融实验更有意思:如果把目标从"排序"换成"直接从图像预测文本”(预测 bag of words,或者用一个 Transformer 语言模型生成 caption),效率会差很多。
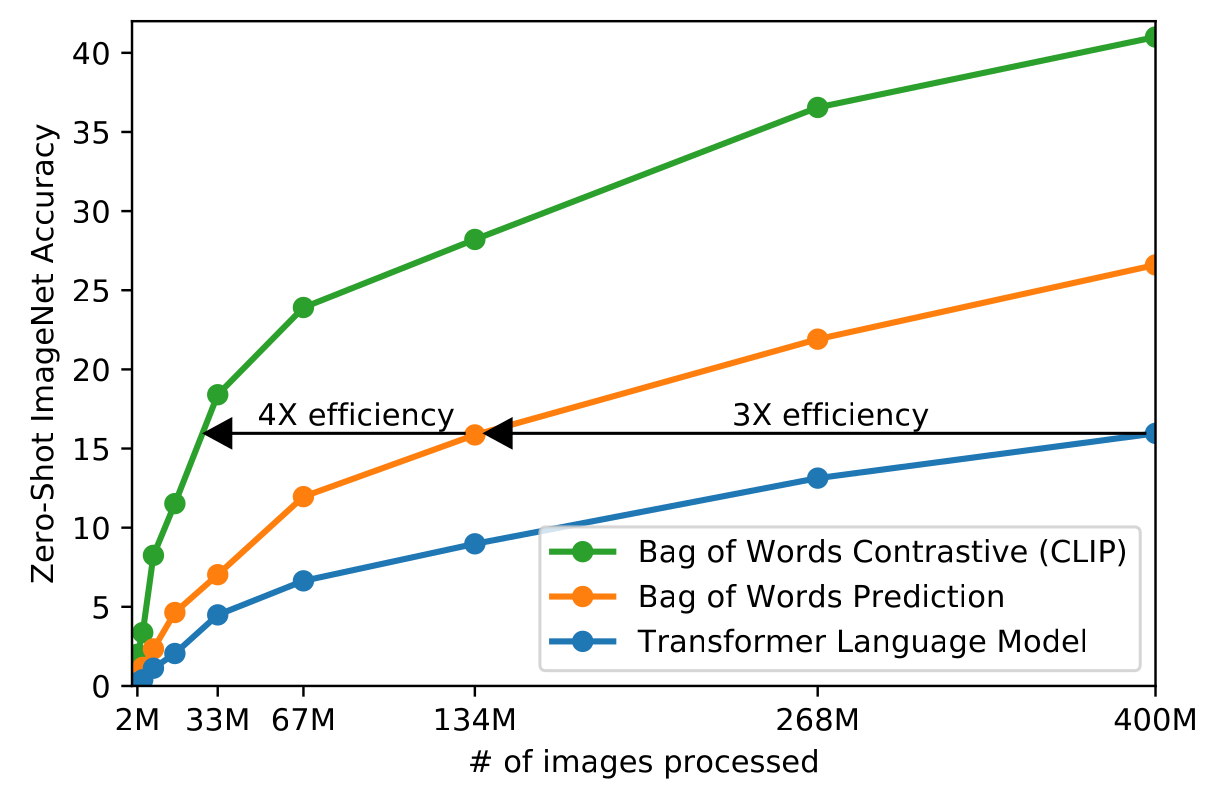
横轴是处理过的图像数量(2M、33M、67M、134M、268M、400M),纵轴是 zero-shot ImageNet 准确率。三条曲线分别是 Bag of Words Contrastive(就是 CLIP 本身)、Bag of Words Prediction、Transformer Language Model。在 400M 图像这个点上,CLIP 达到约 41%,预测式 bag-of-words 约 26.5%,Transformer LM 约 16%。图上标了两条效率箭头:同样的准确率,CLIP 用 4X 更少的算力达到预测式的水平,而在更高区间是 3X。
这个结果的含义是:为了拿到图像的粗略语义表示,精确建模 caption 的 token 序列并不重要。Percy 反复提醒要结合"他们的目标是分类"这一点来读这些设计决策——分类是高层语义任务,不需要细节,所以 CLIP 的向量可以很小、很粗。这个限制在讲 OCR 和图像生成时会反过来变成问题。
3.4 第一轮问答:位置编码能更聪明吗
有学生问:既然 patch 位置只是线性编号 0 到 9,能不能用更复杂的二维位置编码?Percy 回答说,CLIP 论文其实试过某种 2D 版本,结论是差别不大。他给了一个很有意思的解读框架:读这类结论永远要记住"他们关心的是分类"——对分类任务来说位置编码可能无所谓;后面讲 Qwen 时会看到更讲究的位置编码,那些模型关心的是别的能力。
3.5 第二轮问答:caption 噪声会不会混淆模型
另一个学生问:如果一张图里有狗,而 batch 里其他 caption 里也出现了 dog,会不会把模型搞糊涂?Percy 的回答分两层。第一层是统计上的:这个过程的噪声很大,但平均来说没事——同一张图的负样本大部分时候是苹果、猫之类完全不同的东西,偶尔撞上一个 dog 不会毁掉梯度。第二层更本质:这些图像和文本是从网页上爬的,文本可能是旁边的段落、也可能是 alt 属性,本身极其嘈杂。学术界已经有过研究:caption 并不必然逐字描述图像内容——如果图里就是一只狗,人根本不觉得有必要写"狗"。所以这个训练过程"有点令人惊讶地能work",但前提是必须做大量数据过滤:随意抓网页图文对噪声会大到不可用。
3.6 CLIP 的技术硬伤
Percy 明确点出 CLIP 的一个技术缺陷:它需要非常大的 batch(约 30,000 这个量级)。batch size 为 1 显然不行,甚至等于 10 也不行——因为 softmax 要在整个 batch 上做,batch 里的负样本就是全部监督信号。更要命的是,softmax 作用在整个 batch 上意味着这个损失不可分解:普通语言模型训练里,一个 batch 的序列各自独立计算、最后做个聚合就行,而 CLIP 的每一项都和其他所有项耦合在一起。这个点直接引出了下一张幻灯片。
§4 SigLIP:把多分类换成二元分类
这篇来自 Google 的论文 SigLIP(Sigmoid Loss for Language Image Pre-Training, https://arxiv.org/abs/2303.15343 )可以理解成 CLIP 的改进版,名字就说明了改动点。
4.1 目标函数:从 softmax 到 log-sigmoid
区别在这里:CLIP 做的是多分类——“这段文本和这张图对齐,我要让它赢过其他所有图/所有文本”,本质是一个 softmax。SigLIP 则简单得多,它问的是二元分类:给定一个图文对,它们对齐还是不对齐?回到 clip.png 那张图,现在对角线上是正例,非对角线上是负例,就这么简单。
具体算法是:
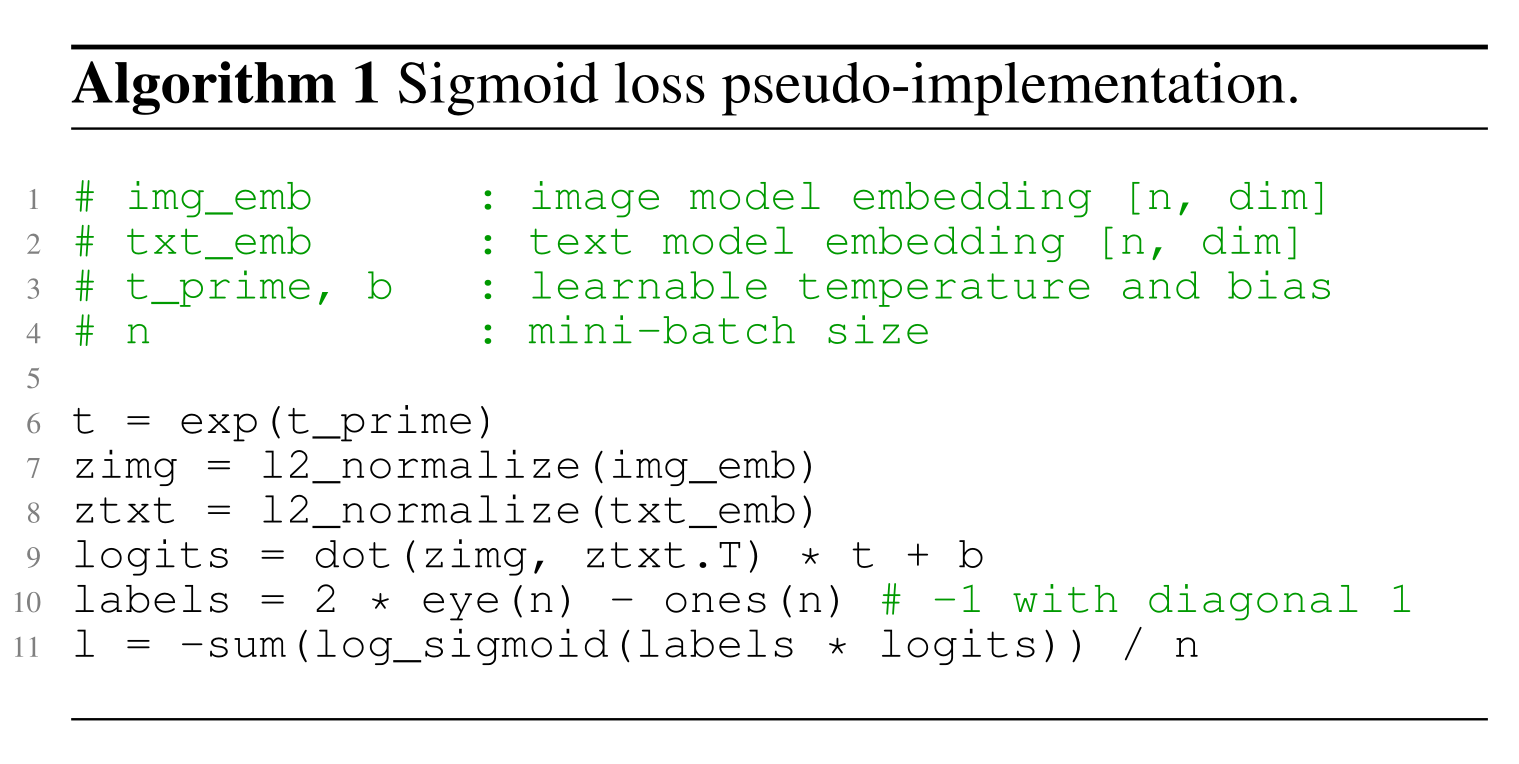
和 CLIP 的代码对照着看,能看出三处结构差异。第一,标签构造是 labels = 2 * eye(n) - ones(n)——对角线上是 +1,非对角线上全是 −1,也就是把"对齐/不对齐"编码成了符号。第二,logits 除了乘温度还要加一个偏置:logits = dot(zimg, ztxt.T) * t + b,这里 b 是个可学习的 bias 项,CLIP 的代码里没有。第三,损失是 l = -sum(log_sigmoid(labels * logits)) / n——把 logits 乘上 ±1 标签之后统一过 log-sigmoid,再对所有项求和取平均。这是标准的 logistic 回归形式的损失。
关键就在最后这一行:每个矩阵元素只出现在它自己那一项里,求和是可分解的。于是 SigLIP 能把"batch 大小"和"损失函数形状"解耦——这一点后面会说。
4.2 数据:WebLI、图内文字 OCR、多语言
SigLIP 在 Google 内部做的,用的是 WebLI 数据集(https://arxiv.org/pdf/2209.06794 ),量级是 order billion 级别的图文对,同样是从互联网上爬的。他们做了两件额外的处理:一是对图像里内嵌的文字做自动 OCR,把图里的字抽出来变成额外的文本配对——这样天然多了一批高质量样本;二是做了过滤,只保留质量最高的 10%。数据集支持 100 种语言。
4.3 效率:5 天 vs 10 天
这一部分是全篇的重点,也是 SigLIP 相对 CLIP 最硬的卖点:
- CLIP:在 256 块 TPUv3 上训练 10 天
- SigLIP:在 32 块 TPUv4 上训练 5 天
“这就是快得多了。“Percy 顺着这个数字讲了一个容易被误读的点:直觉上 v4 应该比 v3 快,但单看 FLOP/s,TPUv4 在这个规模上其实并不更快——它真正的好处是能在 pod 里塞进更多、互连带宽更好。Percy 给的具体数字是:同规模下 FLOP/s 反而低 60% 左右,也就是说这个速度提升完全来自算法与并行方式的改进,不是靠硬件。他也补了一句诚实的限定:CLIP 当时大概并没有为最大吞吐优化过代码,就是"先把这东西跑起来”。
那 SigLIP 是怎么并行起来的?讲义图把整个过程画成了四个阶段:
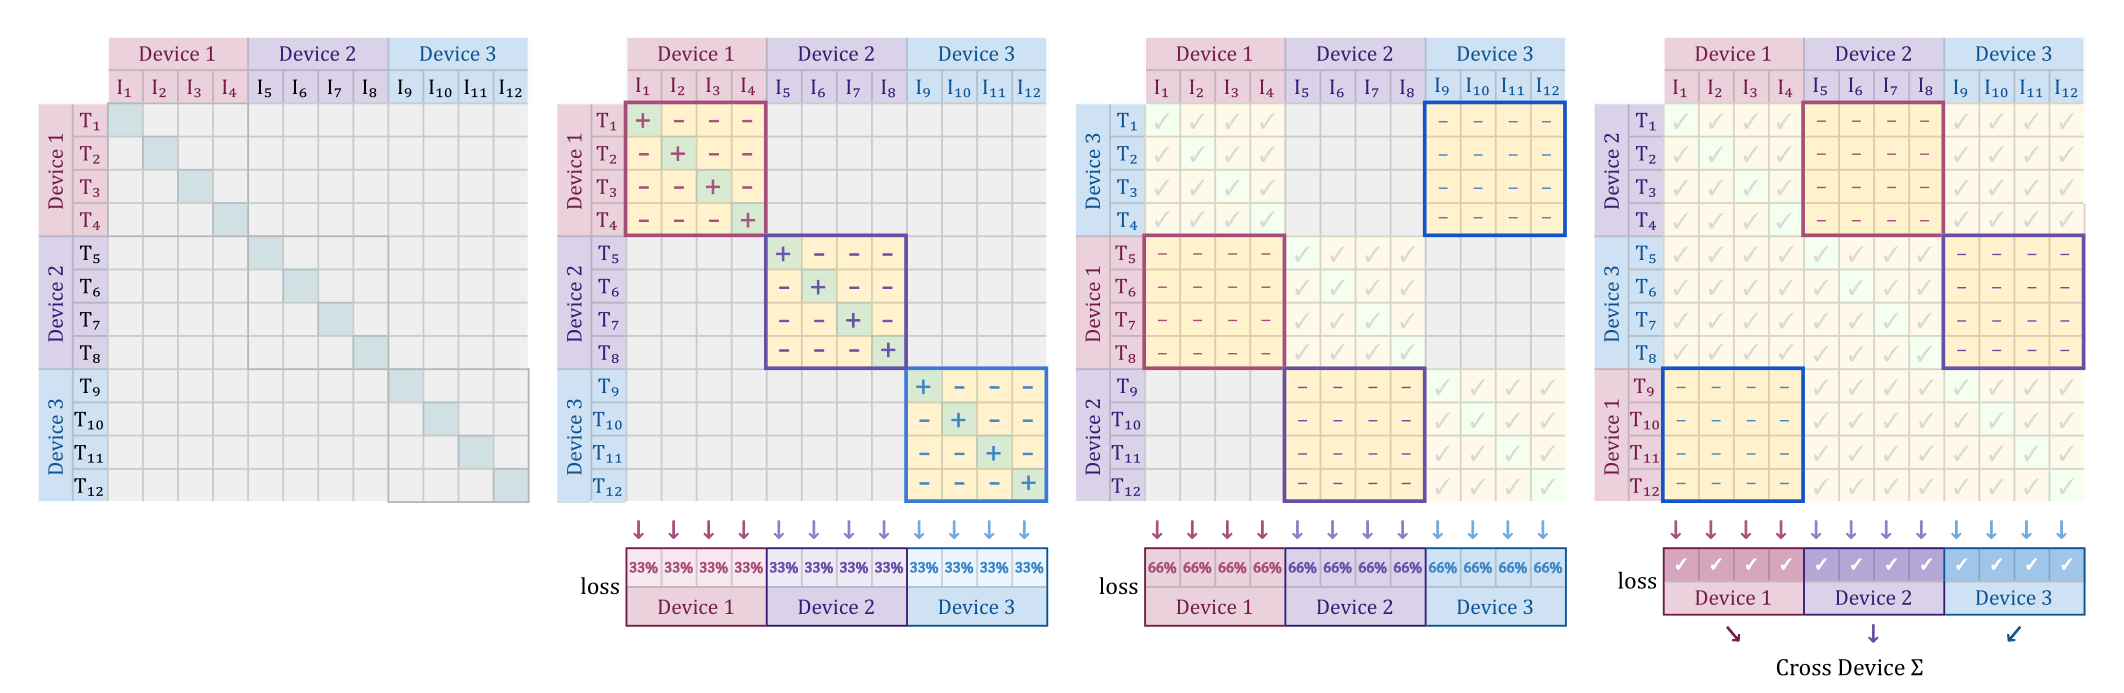
第一格是 CLIP 的情形:每个设备只持有自己那一段对角块,图上只有对角线附近被点亮——因为 softmax 必须看到整行整列,本地只能算出这一小块,其他地方都是空的。第二格:每台设备先在自己持有的图文对内部算所有损失(本地块里对角线是 +、其余是 −),图下方的 loss 条显示每个设备承担 33% 的损失。第三格是关键的"旋转”:设备之间交换文本,比如设备 1 拿到原来属于设备 2、设备 3 的文本块,于是能算出更多非对角项;loss 条变成每个设备 66%。第四格:旋转足够多轮之后,矩阵的每一个元素都被某台设备算过,最后做一个 cross device Σ 把结果聚合。Percy 用口头版本描述同一件事:“设备 1 拿到 T5 到 T8,算完这一块的非对角项,然后再拿到 T9 到 T12”,如此绕圈直到覆盖所有非对角块。他还把这件事类比成 DDP:每台设备存一部分图文对,区别在于——语言模型训练里样本之间完全因子化,而这里样本之间 有交互,这正是需要旋转的原因。
4.4 Batch size 解耦与 32K 临界点
因为损失可分解,SigLIP 把 batch size 从损失函数里彻底解耦了。而 CLIP 不是:改 batch size 就等于换了一个损失函数(负样本集合变了,softmax 的分母变了)。这个解耦带来两个后果:
- 小 batch 区间 SigLIP 明显更好。他们能实验到小于 16K 的 batch,CLIP 在这个区间会因为损失本身退化而变差;CLIP 在小 batch 下只是方差更大,期望上还是同一个损失,SigLIP 则是真的换了个更合适的损失。
- 大 batch 区间收益消失。理论上可以开到 1M 的 batch,但没必要。Percy 说他们测出关键 batch size 大约是 32K,超过这个规模再加大 batch 已经没有收益。
4.5 第三轮问答:需要复杂的负采样策略吗
有学生问 SigLIP 是否需要精心设计负采样策略来平衡正负例或构造"紧"负例。Percy 说至少在最初的论文版本里,他们就是老老实实在同一个矩阵上操作,没有复杂的采样技巧。他也承认这个问题在对比学习方法里是普遍存在的——负例有时需要平衡、有时需要难负例,否则会有偏差——但这篇论文的初版没有处理这些。
§5 VLM 总模板与 LLaVA
到这里,图片已经能被编码成"承载语义的向量"了。讲义图 clip.png 和 siglip-code.png 里的 encoder 都是固定尺寸(336 × 336,或者 224)输入、输出一个向量。
接下来是视觉语言模型(VLM, Vision Language Model)。Percy 只说两个家族:LLaVA 和 Qwen。它们在宏观模板上高度一致——视觉 encoder + projector + 语言模型——差别都在细节里。方法论上有一点值得强调:这不是从头训练,而是拿一个现成的图像 encoder、一个现成的 LLM,把两者缝合起来,属于 mid-training 或 post-training 的性质。
5.1 LLaVA:一个线性投影 + 两阶段
LLaVA(Large Language and Vision Assistant,https://arxiv.org/abs/2304.08485 )2023 年问世。Percy 说明了它为什么让人兴奋:那个时间点上 GPT-4 已经能做视觉推理了,而 LLaVA 是一个开放模型,规模上当然比不上 GPT-4,但人们第一次能看到"里面是怎么搭的"。
组件。视觉侧用 CLIP,而且是表现最好的那版 ViT-L/14(14 × 14 patch);文本侧用 Vicuna——LLaMA 在 ShareGPT 对话数据上微调出来的对话模型(https://www.lmsys.org/blog/2023-03-30-vicuna/ )。
数据。MS COCO 的图像带着 bounding box 标注和 Amazon Mechanical Turk 写的 caption,这些是现成的。做法是把 caption 或者检测出来的物体列表塞给 GPT-4,让它生成问题或对话,再把生成结果和原图配对。一共 158,000 条合成样本。
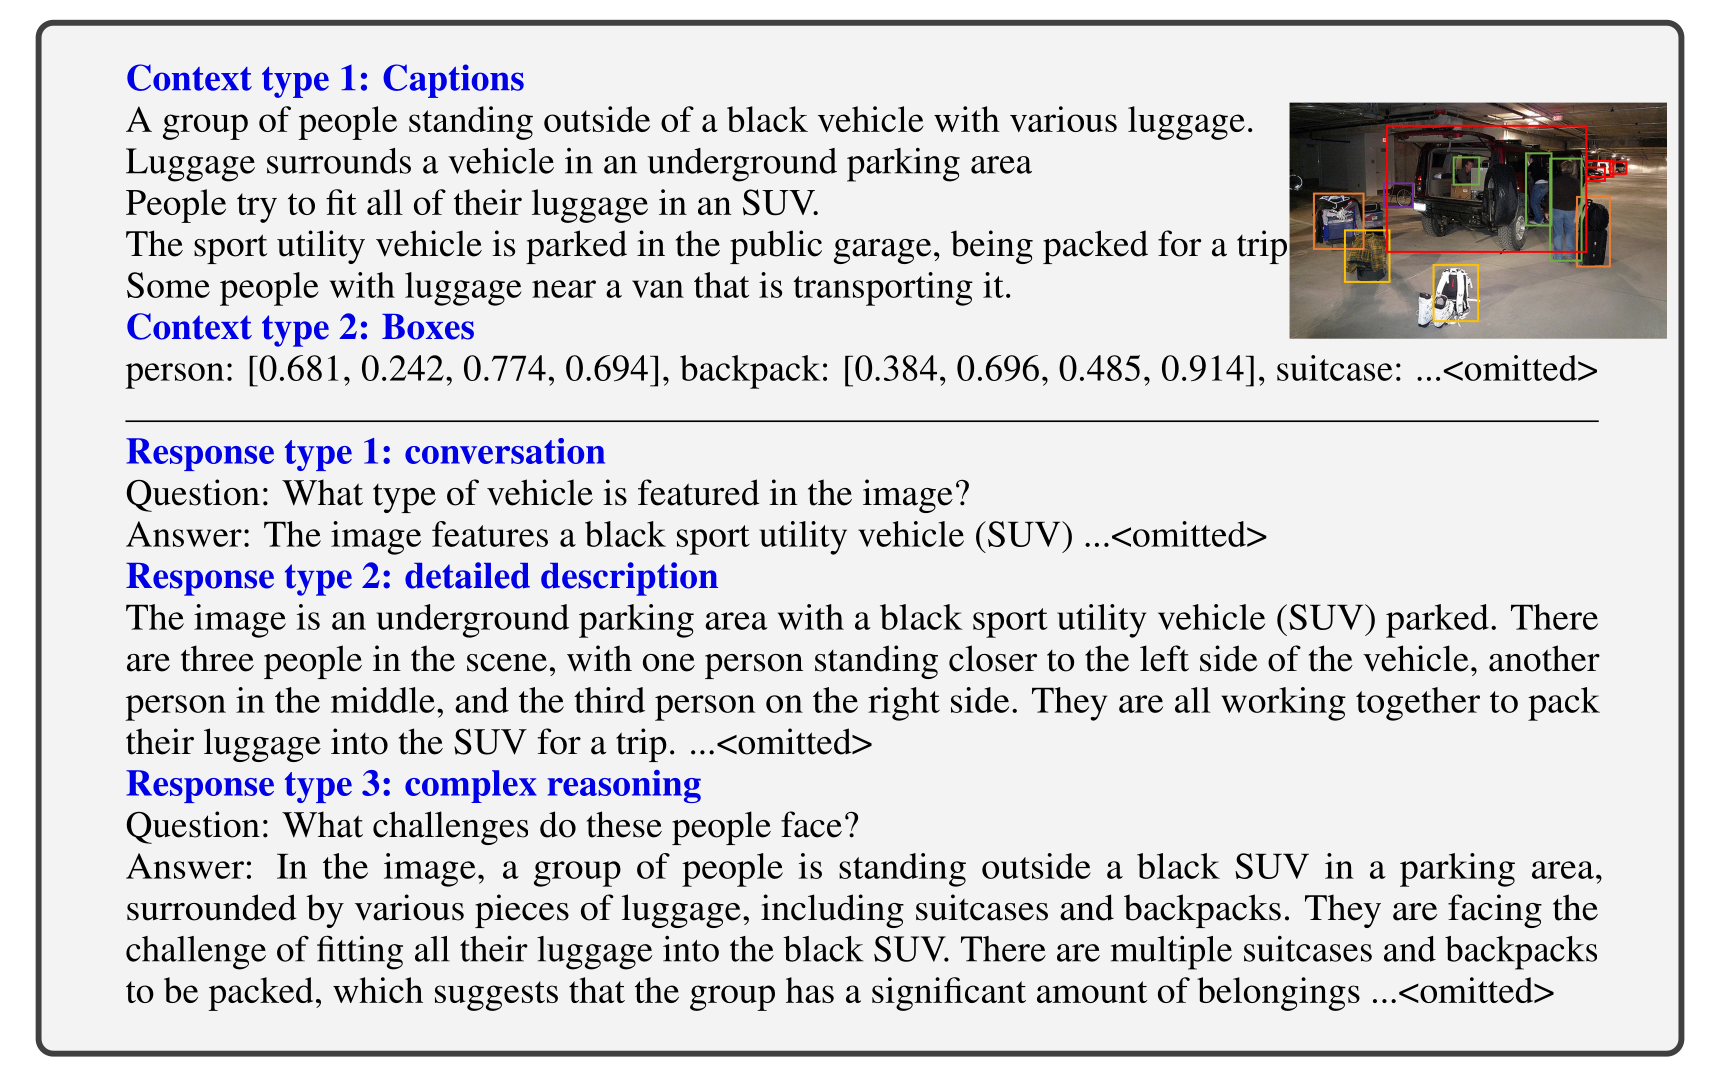
讲义图把输入输出的组合摊开了。Context type 1 是 Captions,同一张地下车库图配了五条不同粒度的描述;Context type 2 是 Boxes,直接给坐标——person: [0.681, 0.242, 0.774, 0.694]、backpack: [0.384, 0.696, 0.485, 0.914](归一化坐标)。Response 有三型:type 1 是对话(问 “What type of vehicle is featured in the image?",答 “a black sport utility vehicle (SUV)"),type 2 是详细描述(描述停车场地库、三个人、往 SUV 里装行李),type 3 是复杂推理(问 “What challenges do these people face?",答装不下行李的困难)。注意每个类型下面的 ...<omitted>——原文里回答都被截断了。
模型。图像过 CLIP 得到视觉特征,再过一个线性投影矩阵 $\mathbf{W}$ 投到语言模型的 embedding 空间。Percy 在这里提了一句:Flamingo 和 Q-Former 用的是更复杂的结构,LLaVA 故意选了最简单的那个。
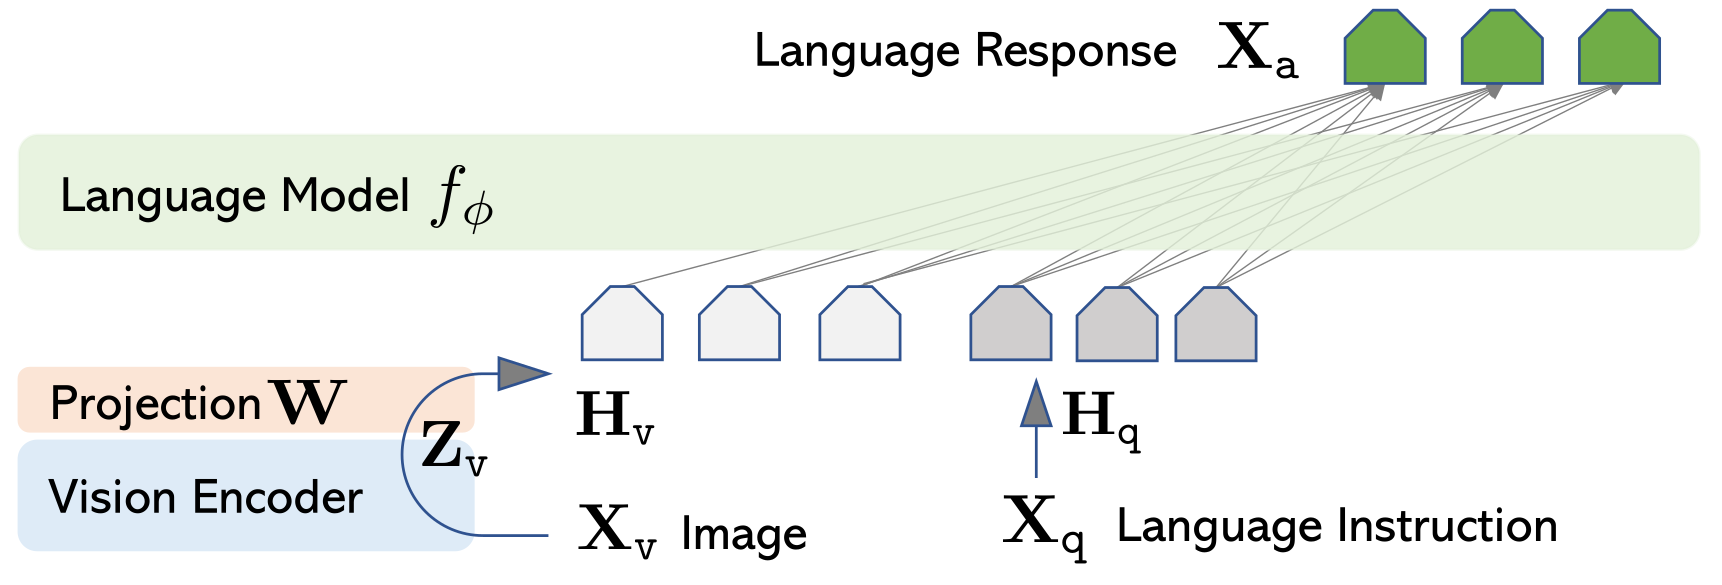
图的读法:图像 $\mathbf{X}_v$ → Vision Encoder → $\mathbf{Z}_v$ → Projection $\mathbf{W}$ → $\mathbf{H}_v$(一串视觉 token);文本指令 $\mathbf{X}_q$ → $\mathbf{H}_q$(一串文本 token);两串拼在一起(图中 $\mathbf{H}_v$ 的 3 个 token 后面接 $\mathbf{H}_q$ 的 3 个 token)送进 Language Model $f_\phi$,最后输出 Language Response $\mathbf{X}_a$。就是这么简单的一件事。
训练。两个阶段:
- Stage 1(alignment):冻结视觉 encoder 和语言模型,只训练 $\mathbf{W}$
- Stage 2(fine-tuning):冻结视觉 encoder,训练 $\mathbf{W}$ 和语言模型
第一阶段只训投影,是为了让随机初始化的 $\mathbf{W}$ 先把视觉空间对齐到语言模型的 embedding 空间,否则直接把垃圾向量灌进一个训练好的 LLM 会破坏它。第二阶段才放开语言模型一起调。
效果。讲义给了一张定性对比:
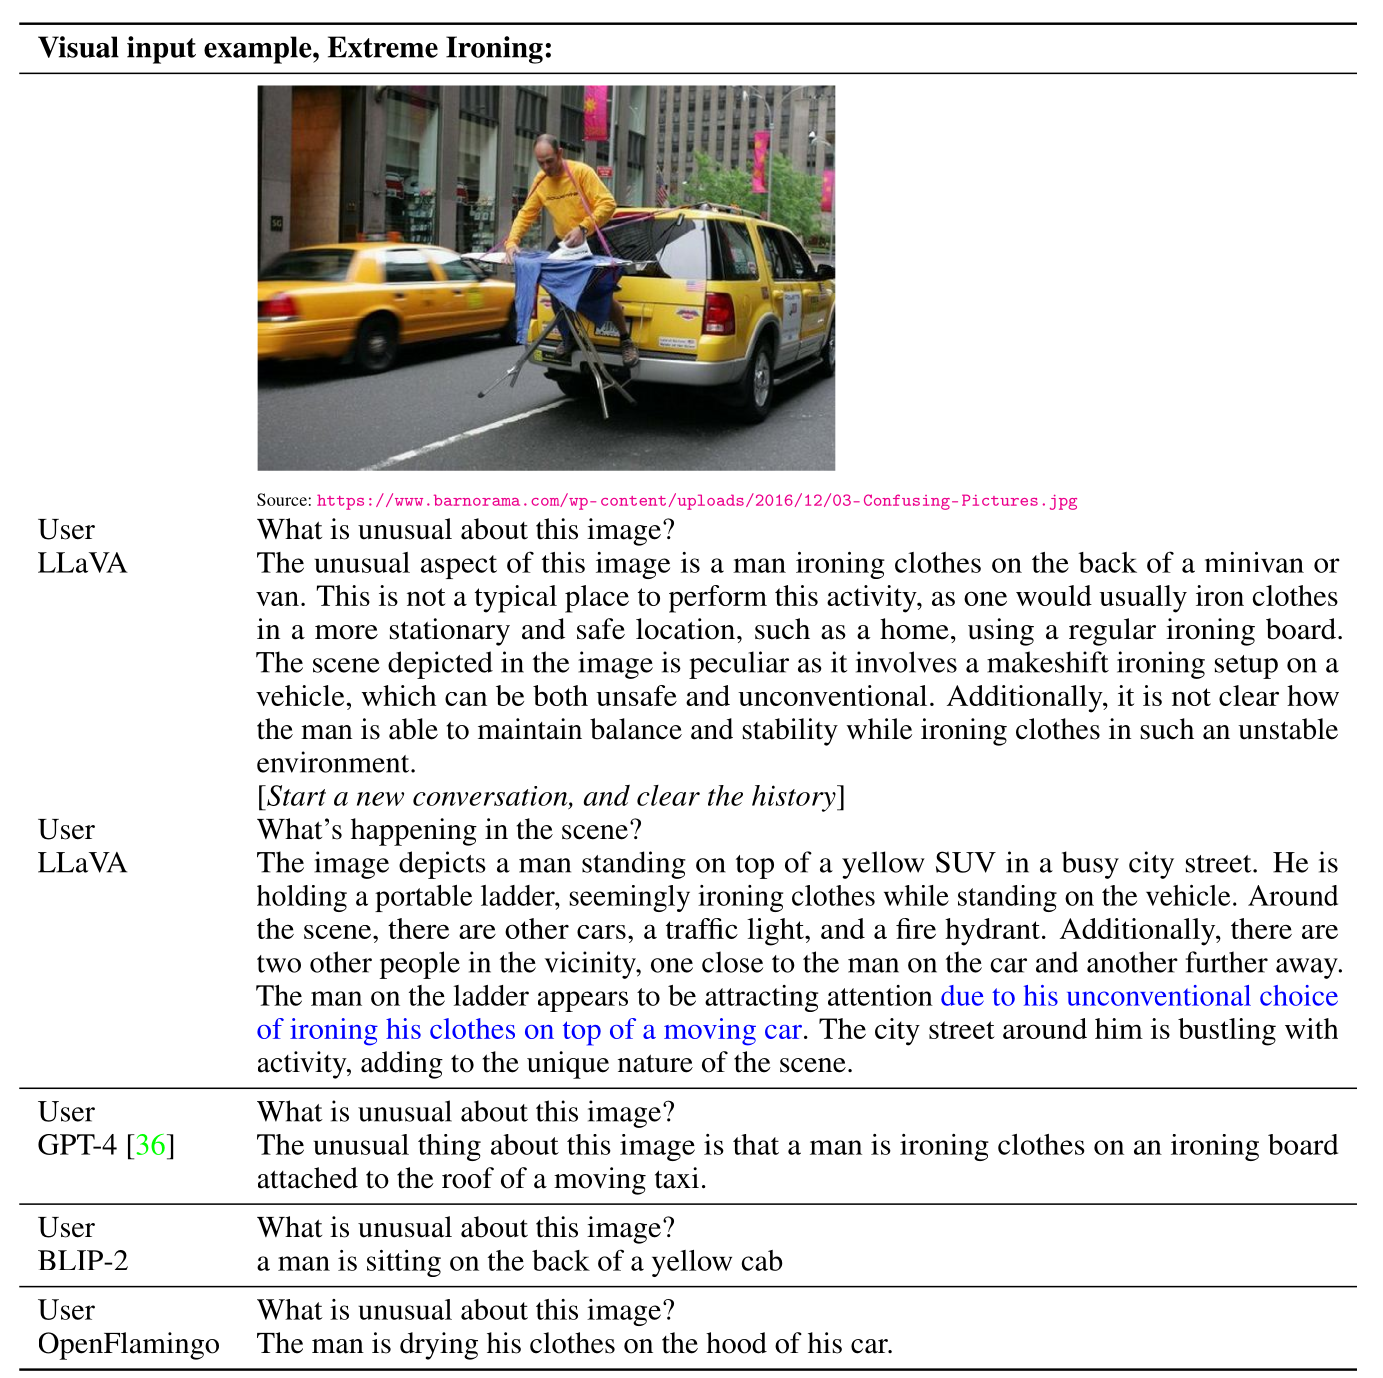
图里是一张黄色出租车后备箱上搭着熨衣板、人在街上熨衣服的照片。问"这张图有什么不寻常的”:LLaVA 给出一大段分析(在车上熨衣服既不安全也不常规,还好奇他怎么保持平衡),并能在多轮对话中继续描述(“一个人站在黄色 SUV 顶上,手里拿着便携梯子……");GPT-4 的回答是"一个男人在移动的出租车的车顶的熨衣板上熨衣服”;BLIP-2 说"一个男人坐在黄色出租车后座上”;OpenFlamingo 说"这个男人在车头盖上晾衣服”。Percy 指出的一个细节是:即使提问没有引导"不寻常",LLaVA 仍然会主动去讲这个场景的异常之处。
5.2 第四轮问答
LLaVA 讲完,Percy 停下来问"关于 LLaVA 有疑问吗",这轮问答没有展开实质内容,紧接着就翻页了。
§6 LLaVA OneVision:动态分辨率与模态配平
LLaVA OneVision(https://arxiv.org/pdf/2408.03326 )是 2024 年的版本,在它之前还有 LLaVA 1.5 和 LLaVA-Next 两个中间版本。它要解决的核心问题是 LLaVA 只处理单张固定分辨率图像。
组件升级。视觉 encoder 从 CLIP 换成 SigLIP(用最后一层 Transformer 前后的 grid features);文本 decoder 从 Vicuna 换成 Qwen-2 72B(当时能拿到的最好的语言模型);投影从一个线性层变成 2 层 MLP。
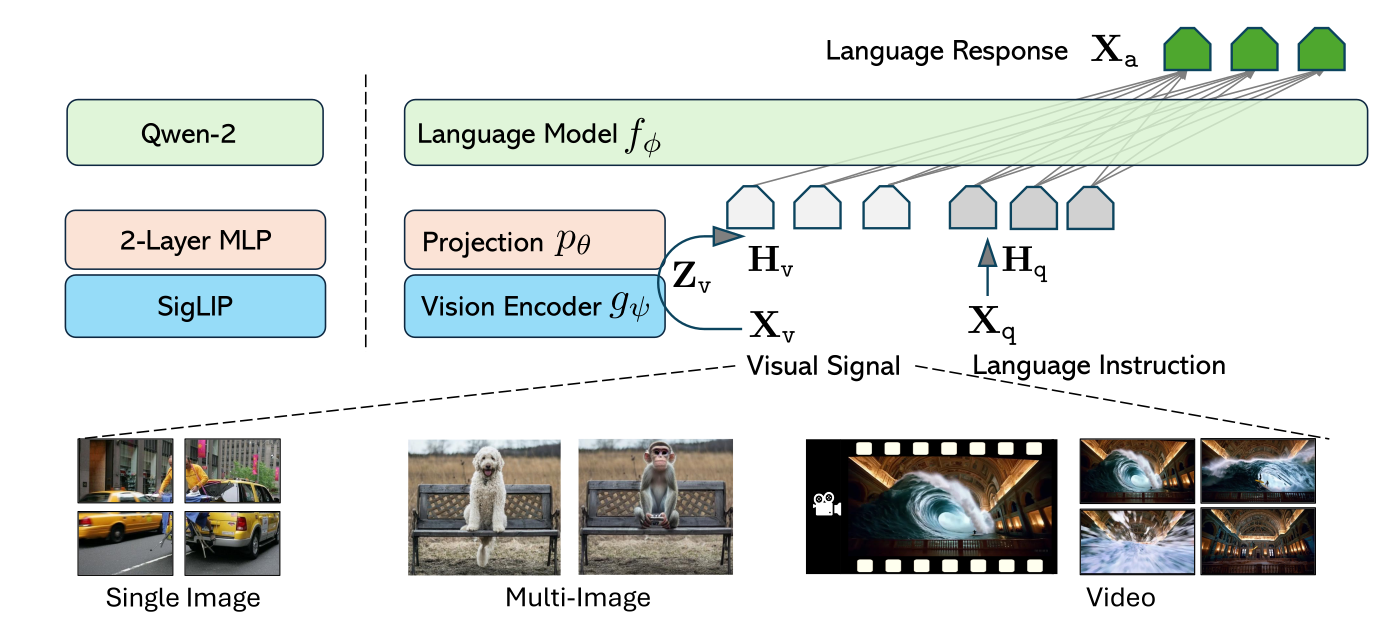
6.1 AnyRes:保留高分辨率
为什么需要动态分辨率。Percy 的理由很直接:保留高分辨率很重要,比如 OCR。而 CLIP 那种"缩放到短边 336 再中心裁剪到 336 × 336"的做法,对文档来说是灾难——一张文档裁到 336 × 336 之后根本读不出字。
解法是 LLaVA 1.5 就引入的 AnyRes(https://static.hliu.cc/files/llava/improved_llava.pdf ):把图像切成 $a \times b$ 块,每块分辨率匹配视觉 encoder 的输入尺寸,逐块编码再拼起来;如果块数太多(原图分辨率过高),就用双线性插值把 token 数压下去。
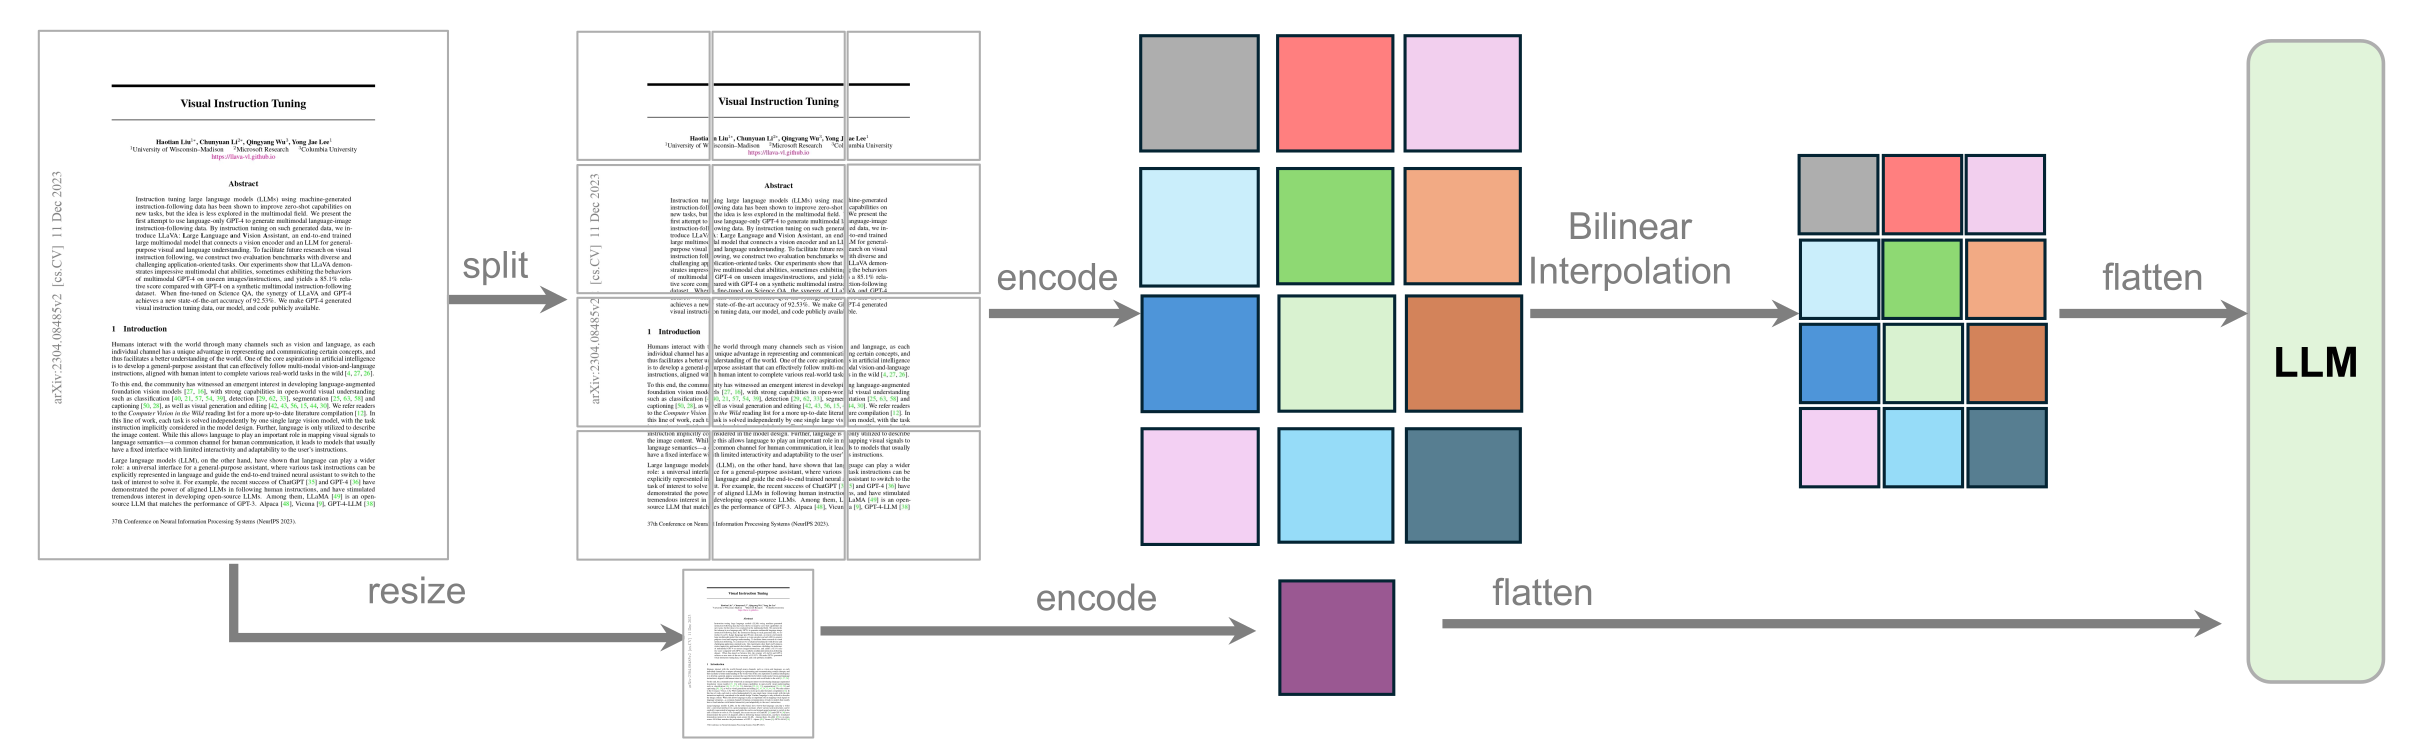
讲义图用 LLaVA 论文自己当输入(一张 2023 年 12 月 11 日的 arXiv 预印本首页)演示整个流程:左边是原文档;两条路径并行——上面的 “split” 路径把它切成 3 × 3 九块,每块单独 encode 成一个彩色方块;下面的 “resize” 路径把整张图缩成一个小图,encode 成一块紫色。九块彩色 + 一块紫色对齐拼成完整版面之后,做 Bilinear Interpolation(这正是"块数太多就插值降采样"的那一步),flatten 成序列送进 LLM。
6.2 三类输入的 token 配平
OnVision 要同时处理单图、多图、视频。目标是让所有模态产生长度大致相当的序列,否则视频会把数据集淹没。讲义图把策略和 token 数一起标了出来:
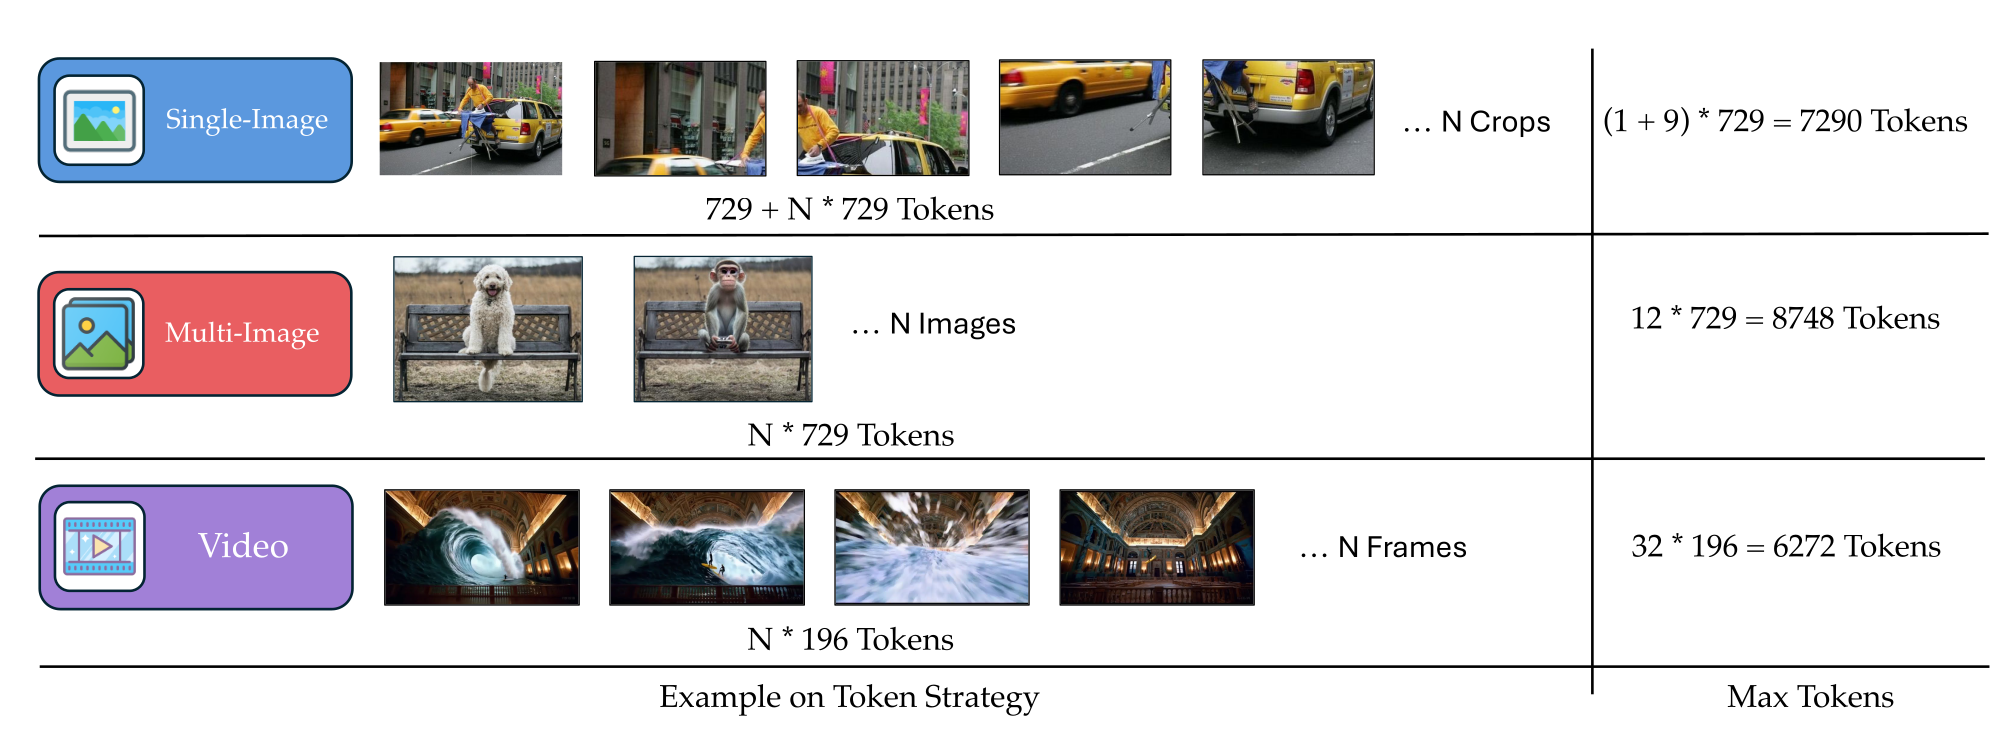
- 单图:用更高分辨率。一张全图降采样 + 最多 N 个 crop,N 上限是 9,公式 $729 + N \times 729$,最大 $(1 + 9) \times 729 = 7290$ 个 token。也就是说每个 crop 贡献 729 个 token。
- 多图:每张图都用基础分辨率,公式 $N \times 729$,最大 $12 \times 729 = 8748$。因为每张图只有 729 个 token,所以能塞进更多张。
- 视频:每帧用更低分辨率,公式 $N \times 196$,帧数上限 32,最大 $32 \times 196 = 6272$。每帧只有 196 个 token。
Percy 用一句很形象的话总结:“如果只有一张图,我就多看几眼;如果有多张图,我就远远地看一眼;如果是视频,每帧看得更粗。“他也解释了为什么视频要限帧:上下文长度会爆——这也是他说"后面会看到,能处理多模态很大一部分就是能处理更长上下文"的伏笔。
6.3 数据哲学:质量优先,以及"明目张胆"的蒸馏
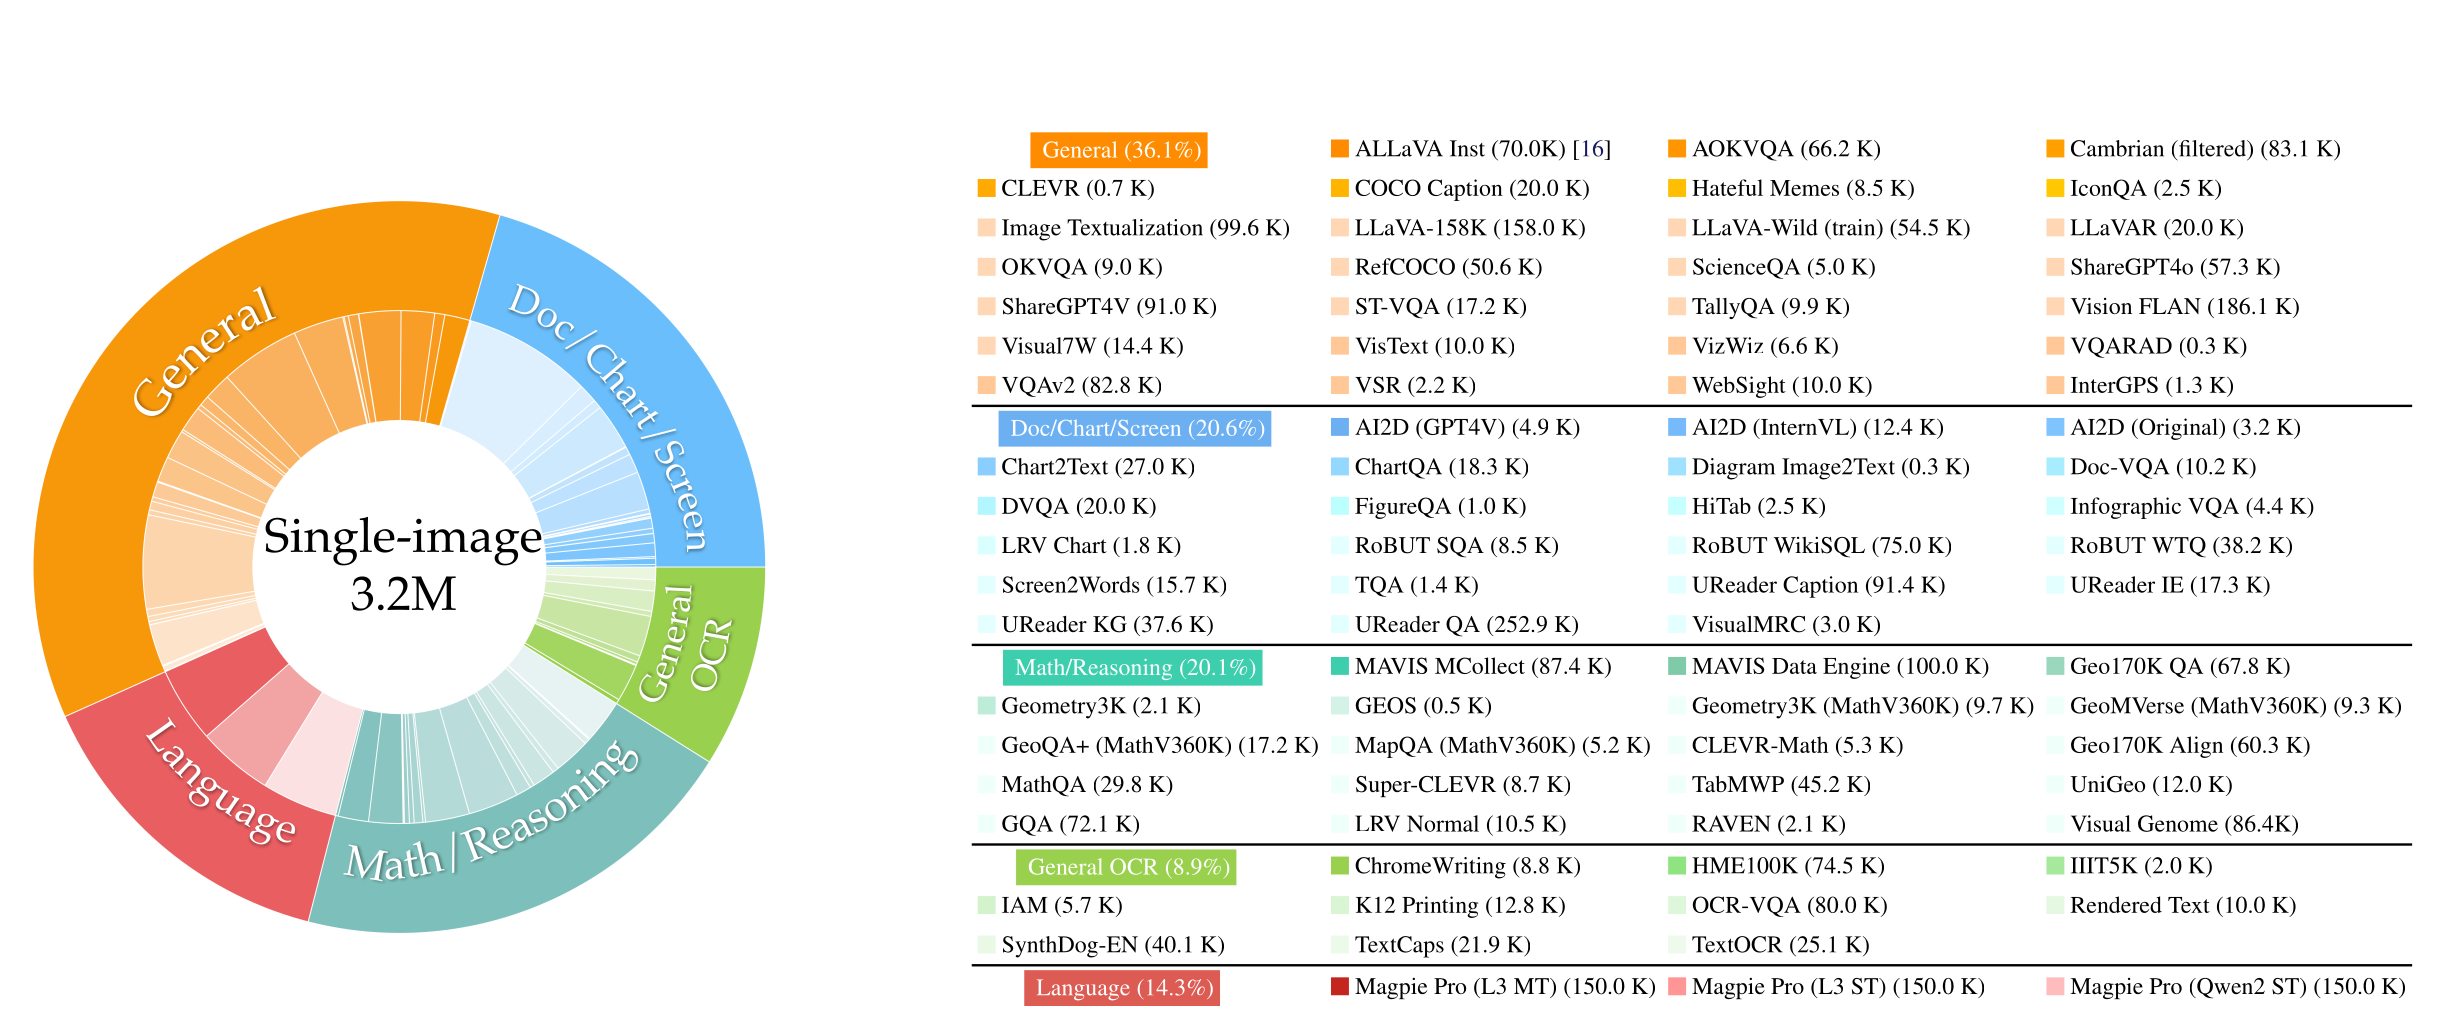
数据总量 1.6M,讲义给了两张甜甜圈图。第一张是单图部分(3.2M,属于 LLaVA 1.5 阶段):
第二张是 OneVision 的混合:
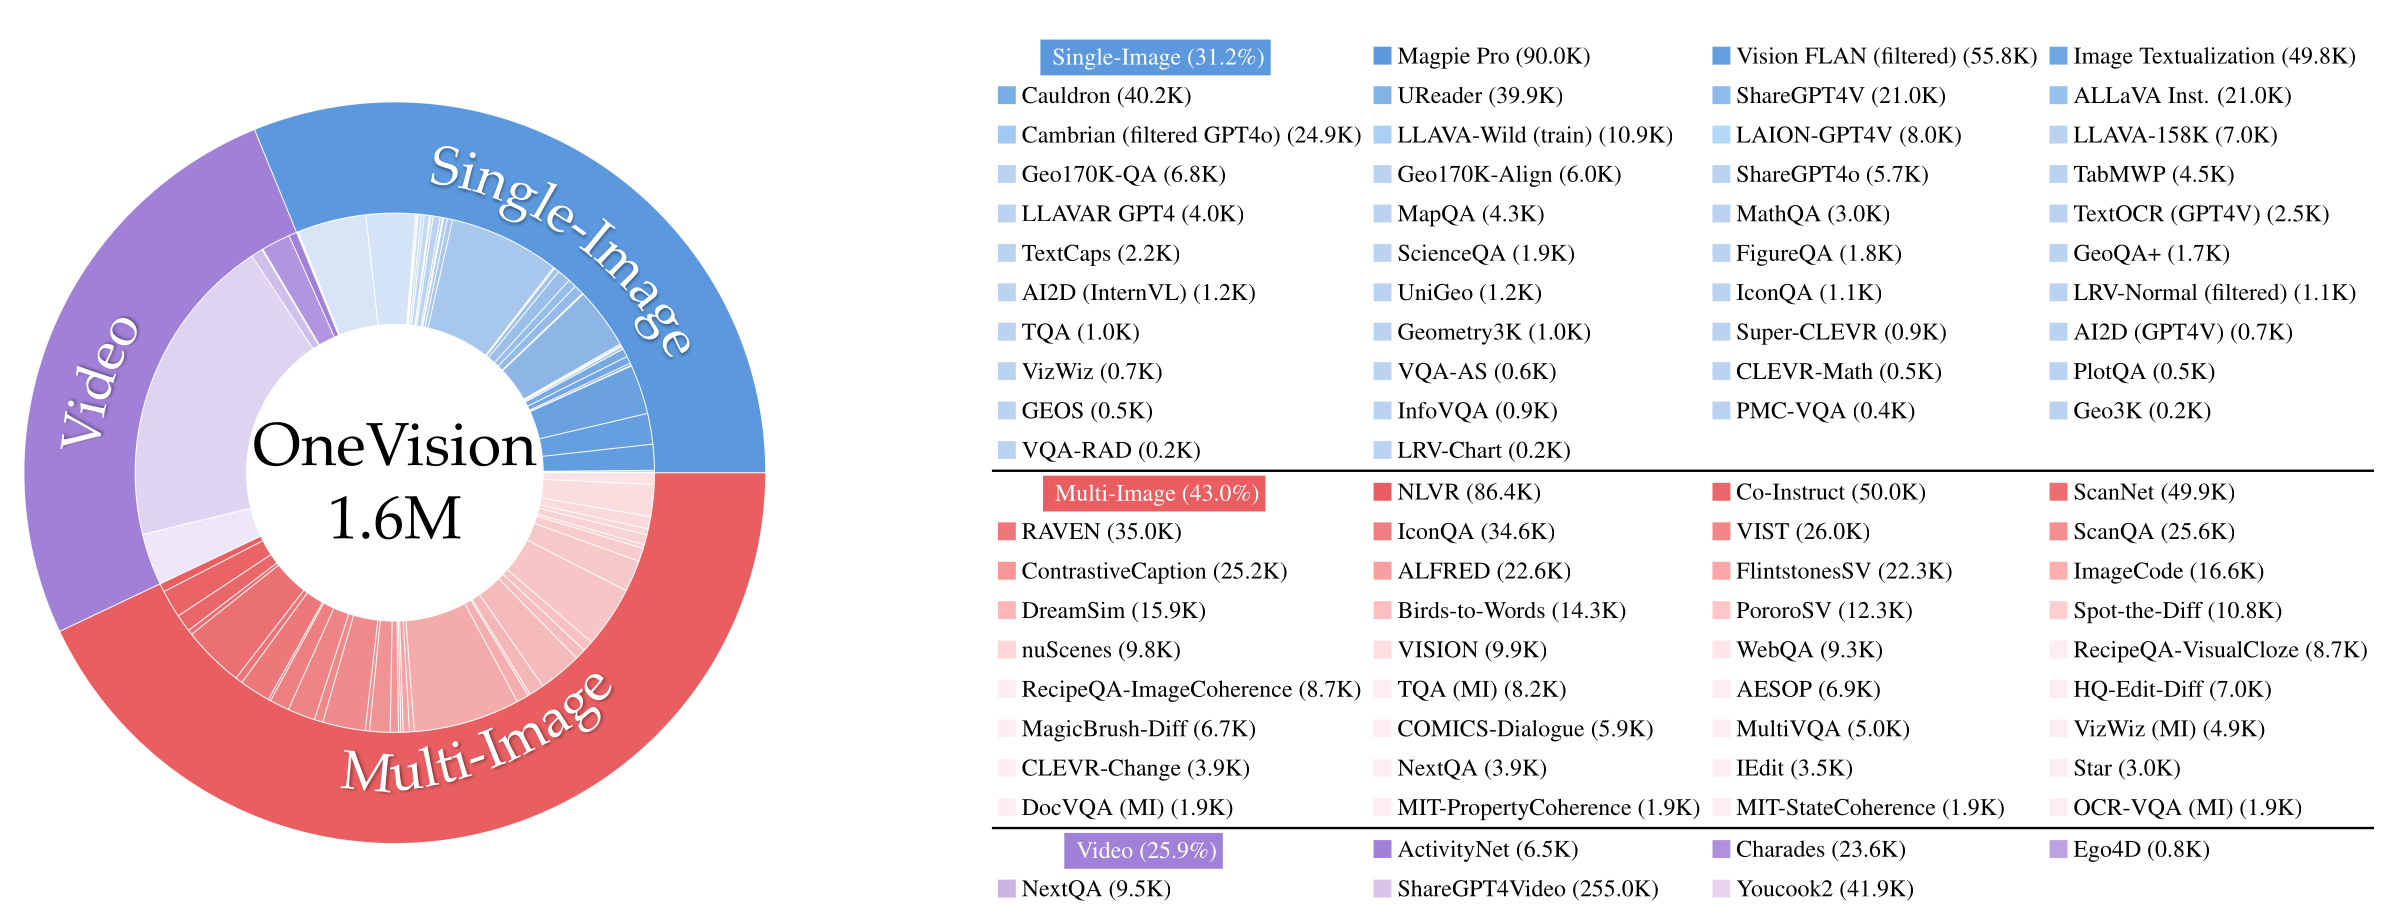
从这两张图能看出数据的味道。单图部分的大头是 OCR 和文档类——UReader QA 252.9K、ChartQA 18.3K、AI2D 各版本 12.4K/4.9K/3.2K、InfographicVQA 4.4K、SynthDog-EN 40.1K;多图部分有 NLVR 86.4K、ScanNet 49.9K、VIST 26.0K、Spot-the-Diff 10.8K、RecipeQA-ImageCoherence 8.7K;视频部分 ShareGPT4Video 就占 255.0K,还有 Youcook2 41.9K、Charades 23.6K。Percy 的评价是:这是很典型的”targeted data",任务导向极强——本质上属于 post-training territory,你要模型会做什么任务,就去造那类任务的样本。而且"这篇工作是毫不掩饰地在蒸馏 GPT-4",这样能拿到最好的性能;他坦承这不算理想,“但如果你没有标注预算,这就是你会做的事”。
6.4 三阶段训练
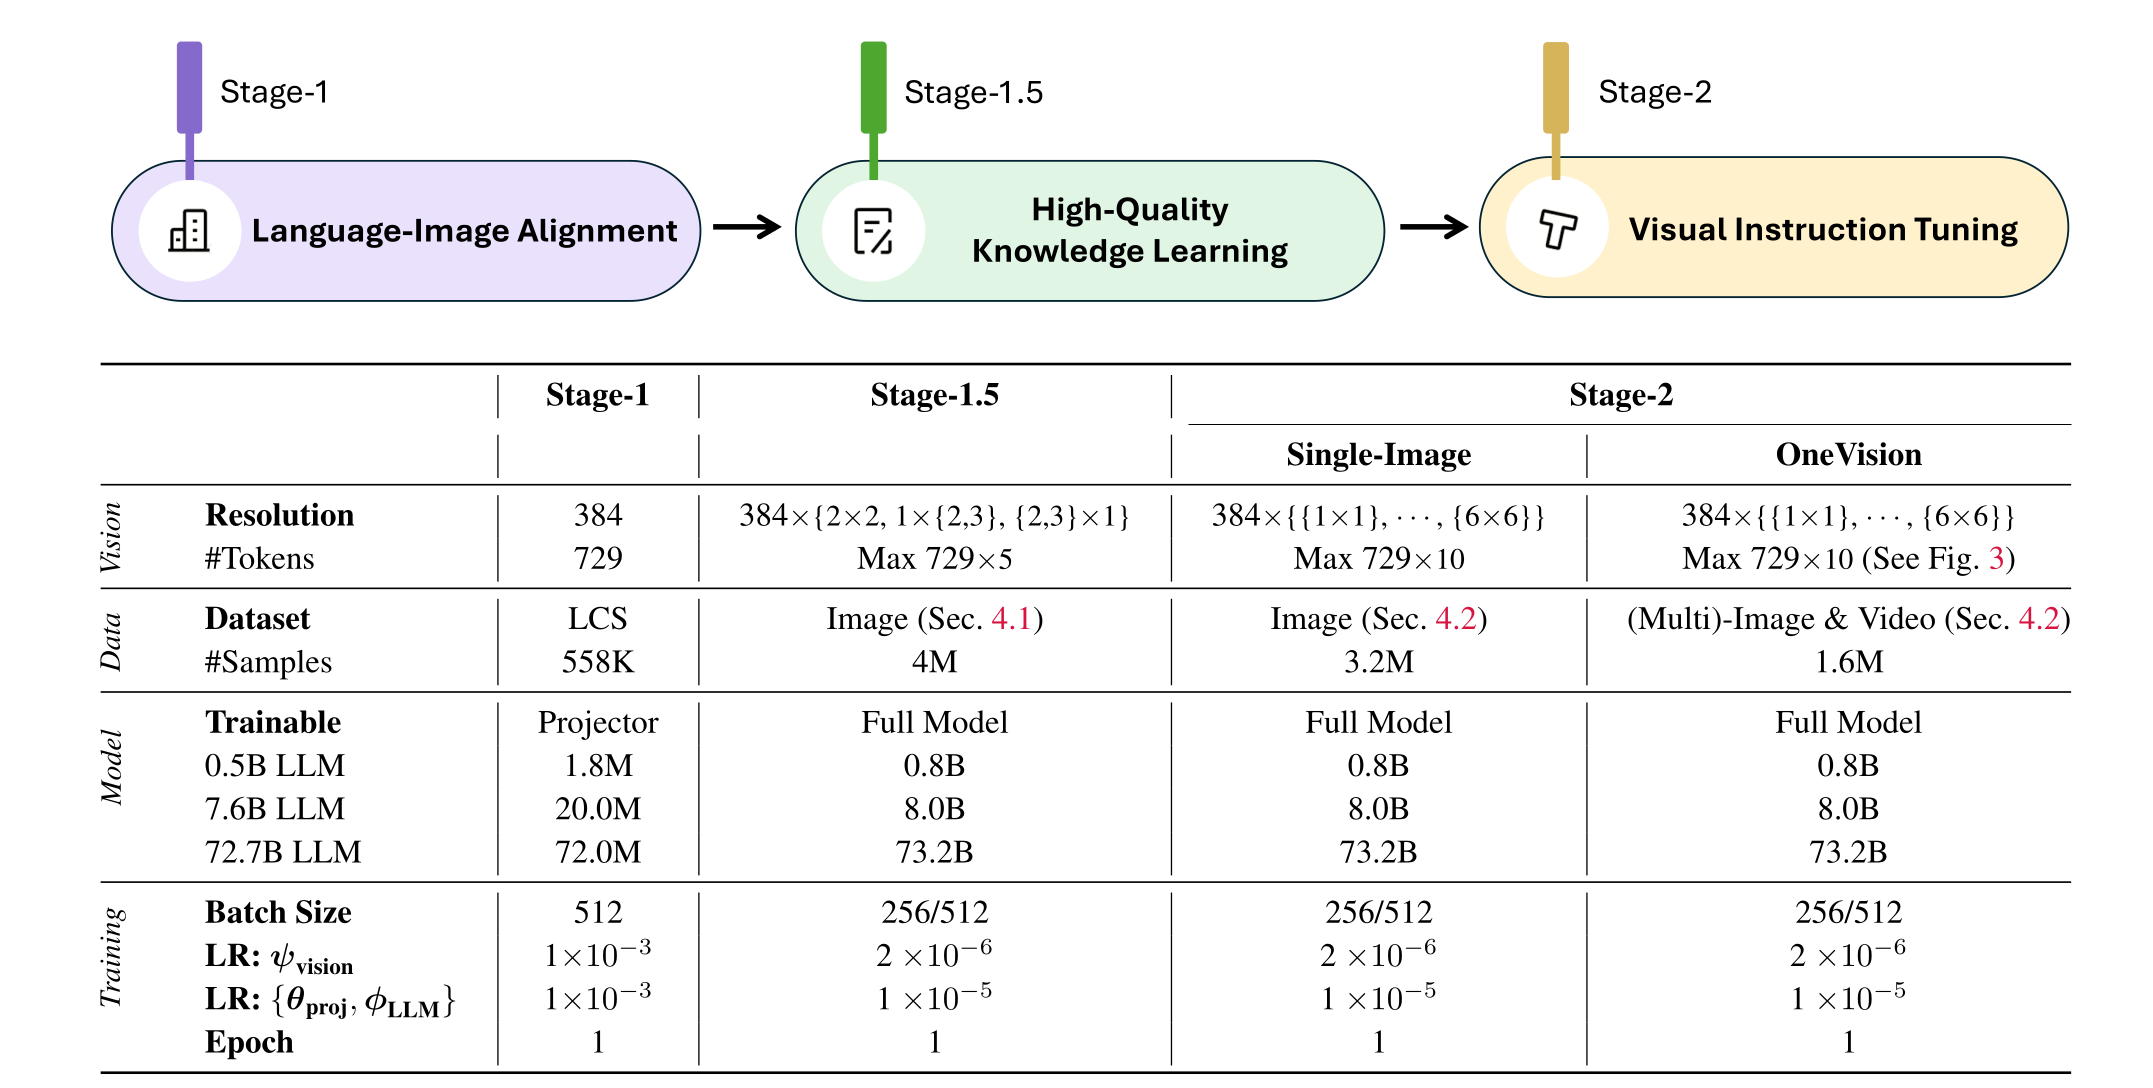
讲义这张表把每个阶段的每个数字都列了:
| 维度 | Stage-1 | Stage-1.5 | Stage-2 (Single-Image) | Stage-2 (OneVision) |
|---|---|---|---|---|
| 分辨率 | 384 | $384\times\{2{\times}2, 1{\times}\{2,3\}, \{2,3\}{\times}1\}$ | $384\times\{\{1{\times}1\},\dots,\{6{\times}6\}\}$ | 同左 |
| token 数 | 729 | 最多 $729\times5$ | 最多 $729\times10$ | 最多 $729\times10$ |
| 数据集 | LCS | Image | Image | (Multi)-Image & Video |
| 样本数 | 558K | 4M | 3.2M | 1.6M |
| 可训练参数(72.7B LLM) | 仅 Projector,72.0M | Full Model,73.2B | Full Model,73.2B | Full Model,73.2B |
| batch size | 512 | 256/512 | 256/512 | 256/512 |
| 视觉侧学习率 | $1\times10^{-3}$ | $2\times10^{-6}$ | $2\times10^{-6}$ | $2\times10^{-6}$ |
| 投影+LLM 学习率 | $1\times10^{-3}$ | $1\times10^{-5}$ | $1\times10^{-5}$ | $1\times10^{-5}$ |
几个可以直接读出来的结论:第一阶段(Language-Image Alignment,558K 条 LCS 数据)只训 projector,对 0.5B LLM 时是 1.8M 参数、对 7.6B LLM 时是 20.0M、对 72.7B LLM 时是 72.0M;第二阶段开始全参数训练(73.2B);三阶段各只跑 1 个 epoch;学习率从第一阶段的 $10^{-3}$ 掉到第二阶段的 $10^{-6}$ / $10^{-5}$——差了三个数量级,因为第一阶段是在训一个随机初始化的投影,第二三阶段是在微调一个已经训好的模型。
Percy 对"为什么从两阶段变成三阶段"给了一个很诚实的说法:他不确定有什么原则性的理由,只知道中间那个 Stage-1.5 是用高质量数据、更偏向"知识”;最后那个 Stage-2 则是让训练样本长成下游任务的样子。
6.5 跨模态迁移
这一节是 Percy 觉得有意思的部分:不同模态之间存在迁移,而且有些组合在训练时从未出现过。
单图图表数据 → 多图联合推理。训练时全是单图,问的是图表或表格的问题;测试时给两张图,一张表、一张图,让模型一起推理。讲义的例子是一道保险题:
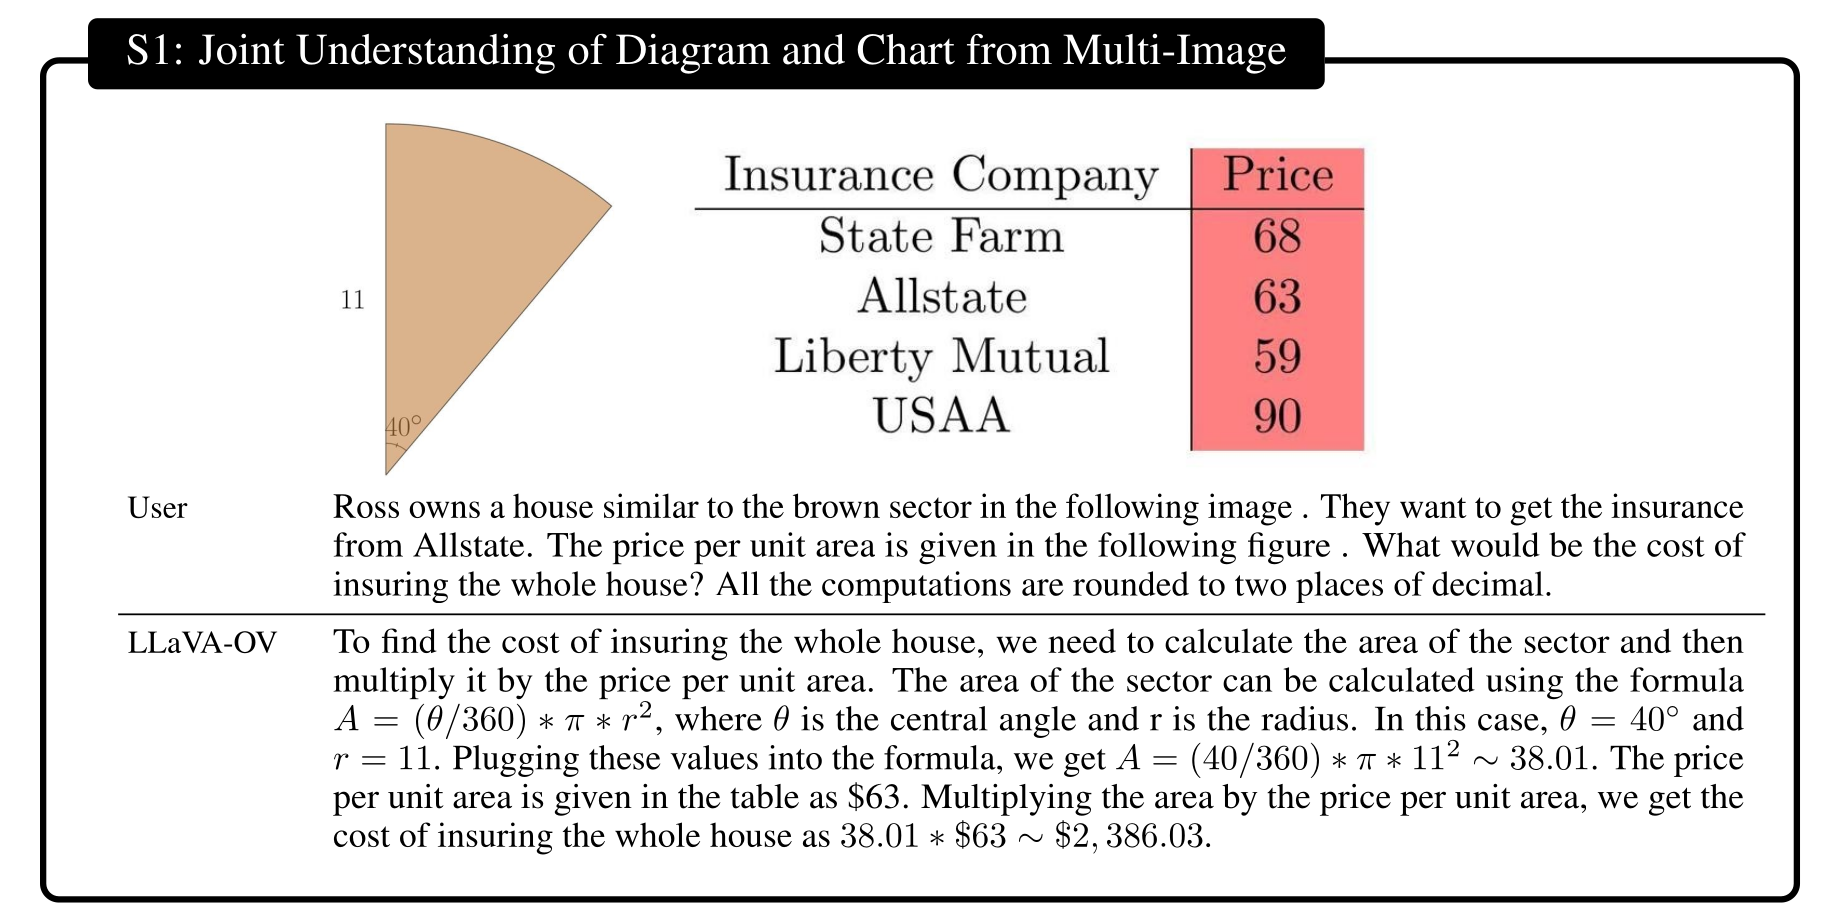
S1:扇形图(r=11,θ=40°)加一张保险价格表,模型自己算出面积再乘单价(讲义图 images/llava-onevision-transfer-s1.png) 用户问:Ross 有一栋房子形状像图里的棕色扇区,想从 Allstate 买保险,单价在表里,整栋房子的保费是多少?表里列着 State Farm 68、Allstate 63、Liberty Mutual 59、USAA 90。模型自己写了 $A = (\theta/360) \times \pi \times r^2$,代入 $\theta = 40$、$r = 11$ 得 $A \approx 38.01$,乘单价 63,算出 $\$2{,}386.03$——这是把两张图的信息联合起来做完一整条计算链。
单图 OCR + 多图关系推理 → GUI agent。训练时 OCR 只在单图上做,关系推理只在多图上做;测试时给四张连续的手机截图,让它描述三步点击操作。
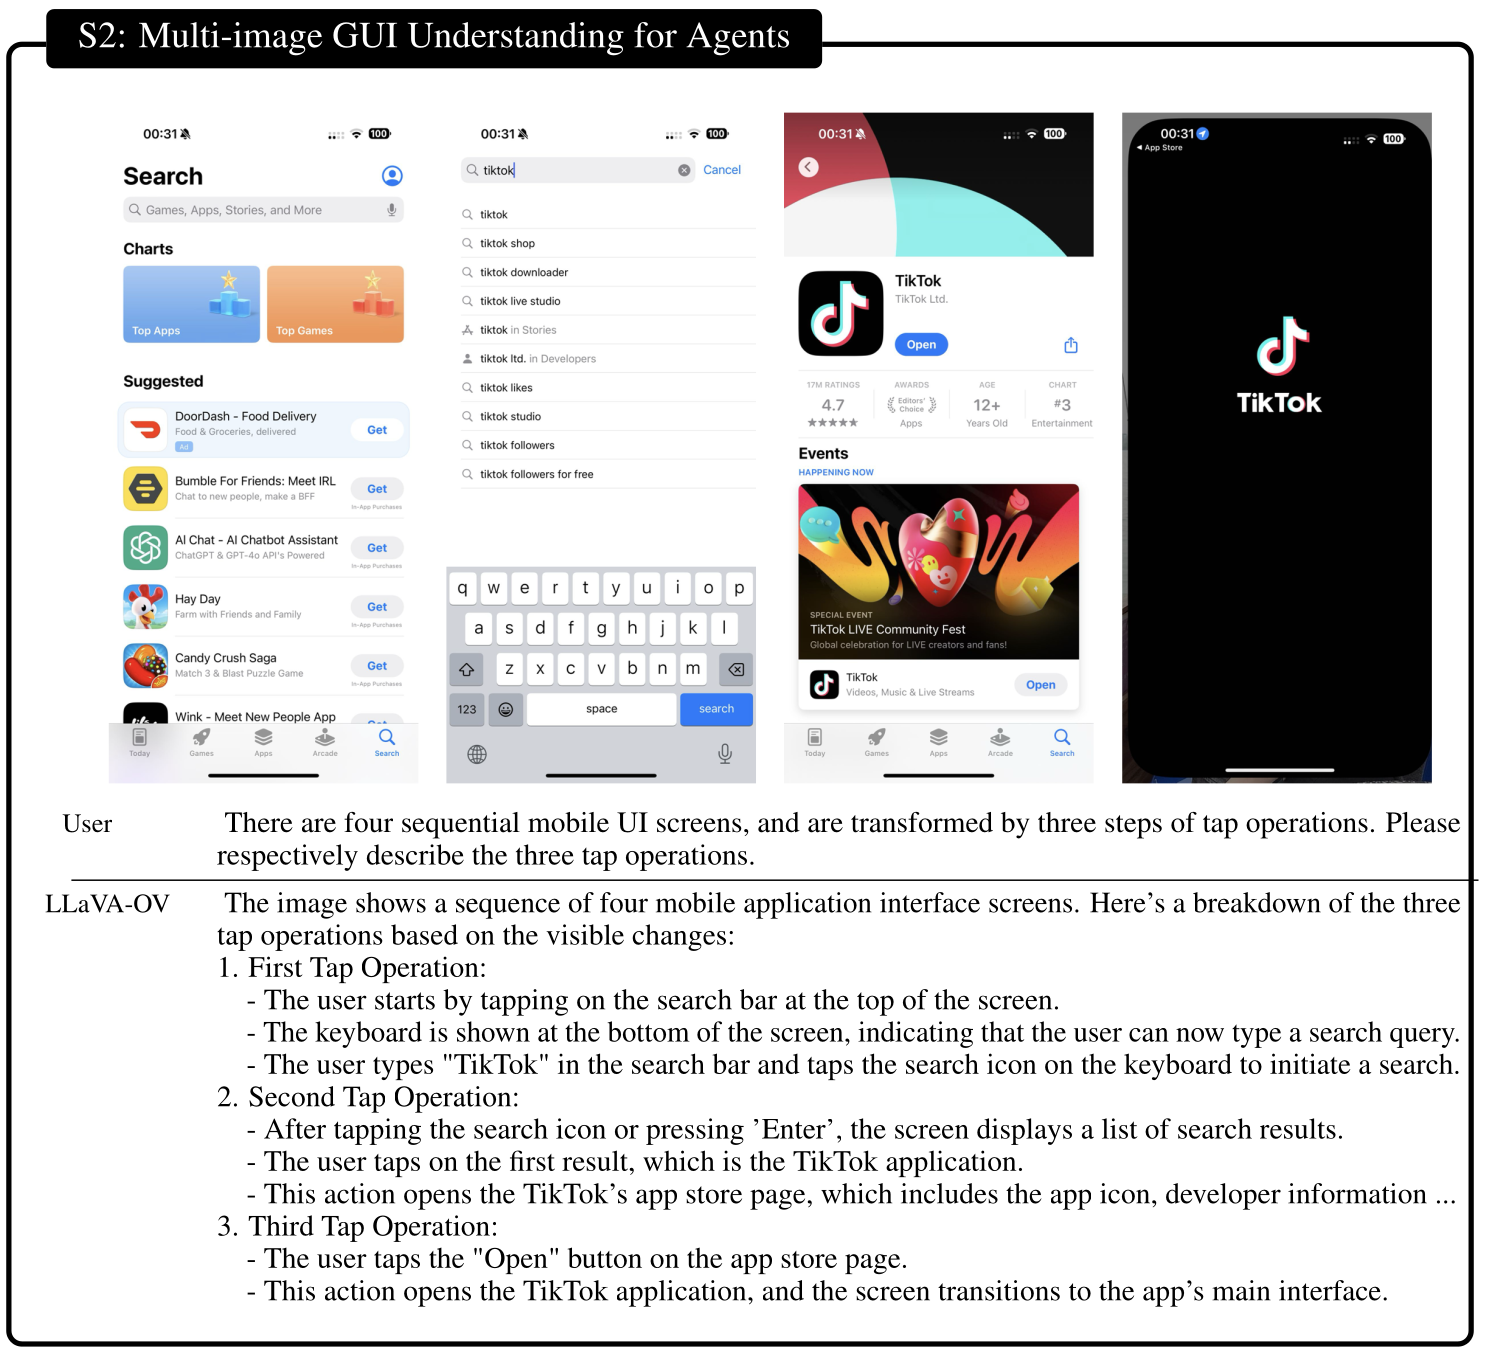
S2:四张 iPhone 截图(搜索、输入、应用商店页、App 主界面),模型还原出三步操作(讲义图 images/llava-onevision-transfer-s2.png) 模型的回答把整条链路拆开了:第一步点亮搜索框、键盘弹出、输入 “TikTok” 并点搜索;第二步点第一条搜索结果、打开 TikTok 的应用商店页;第三步点 “Open” 按钮、应用启动。这类能力正是 GUI agent 需要的。
单图 visual prompting → 视频。训练数据里只有"在一张图上画个圈,表示你应该关注这块区域",测试时变成视频里圈一个球员。
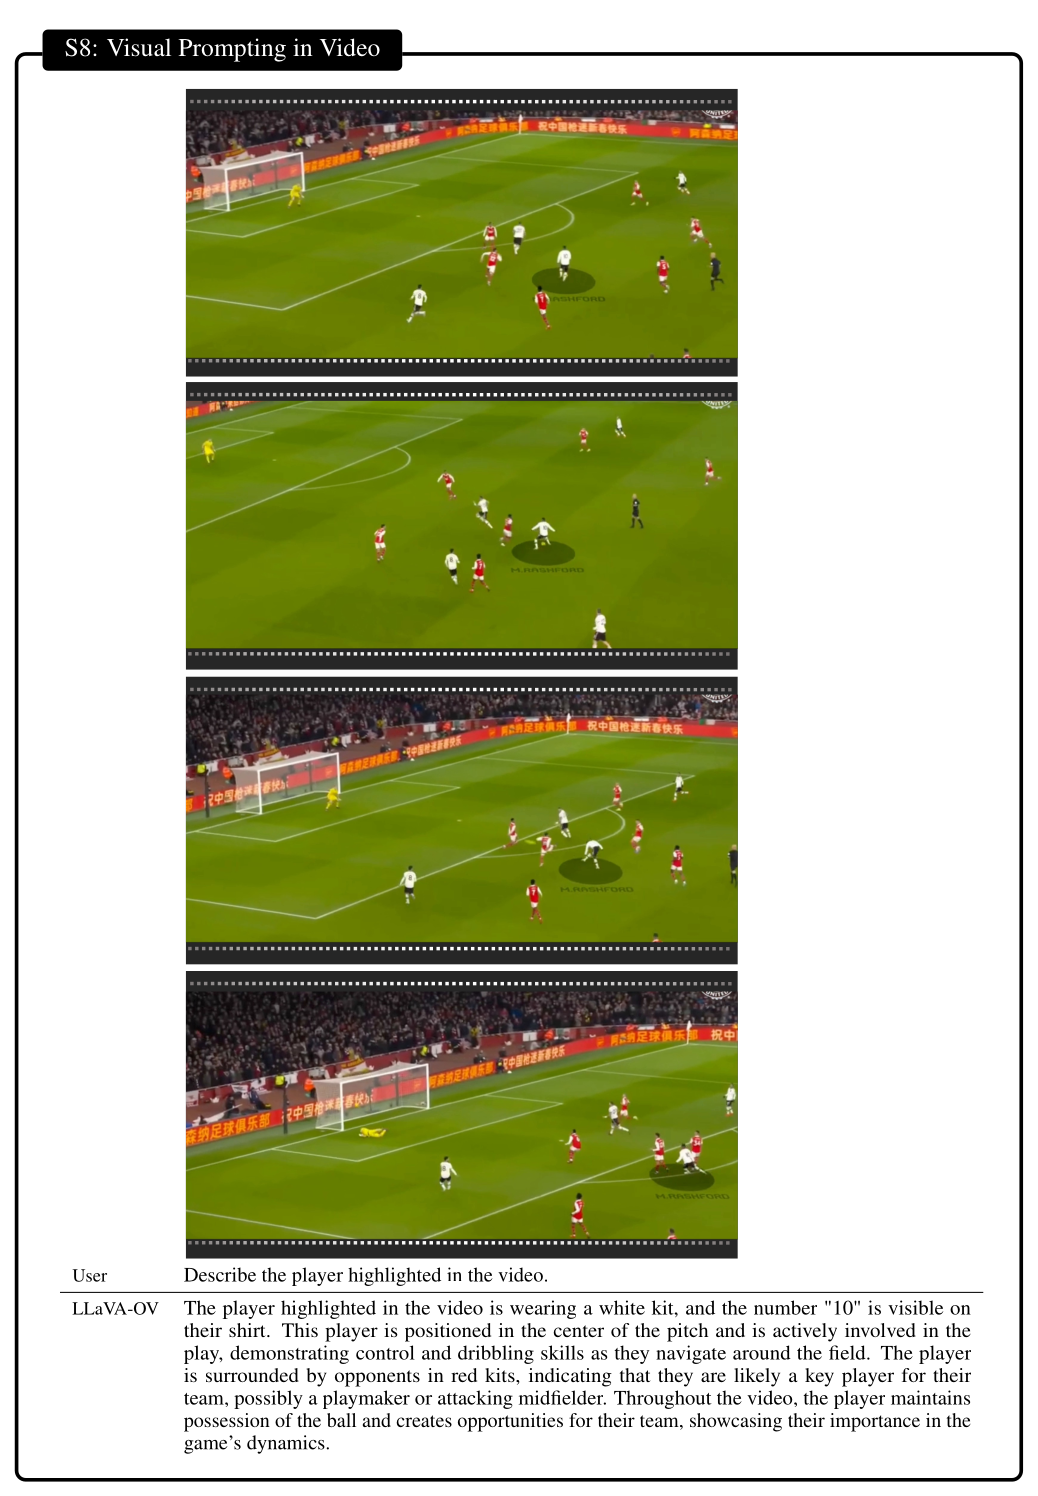
S8:足球视频里高亮一个球员,问"描述被高亮的球员",模型认出穿白衣、号码 10(讲义图 images/llava-onevision-transfer-s8.png) 用户问 “Describe the player highlighted in the video.",模型回答那个被高亮的球员穿白色球衣、球衣上有 “10” 号、在中场位置控球,并推断他可能是组织核心或进攻型中场——而"高亮圈"这个提示概念在视频数据里从未出现过。
Percy 的态度是"乍一看挺吓人,你基本是在逐任务地做监督学习”,但只要任务数量足够多,模型就会产生某种迁移,这算是让人安心的证据。
总结 LLaVA 系列:标准 VLM 模板(视觉 encoder + projector + LM);绝大部分工作量花在数据策展上,而且严重依赖"合成的、任务特定的"数据;LLaVA 系列最可贵的一点是开源——不只放权重,还放数据,你可以真正复现和研究。
§7 Qwen-VL 与 Qwen2-VL:从固定 256 token 到原生分辨率
7.1 Qwen-VL(2023)
Qwen 从 2023 年也开始做多模态。第一版叫 Qwen-VL(https://arxiv.org/abs/2308.12966 ),Percy 说希望快速过掉,因为模式已经看熟了。
架构有三处要记:视觉 encoder 用 OpenCLIP 的 ViT-bigC(14 × 14 patch)——OpenCLIP 就是 CLIP 的开源复现(https://arxiv.org/abs/2212.07143
);adaptor 用一层 cross-attention,引入 2D 位置编码,输出映射到固定 256 个 token;特殊 token 有三个:<img> 表示图像、<box> 表示 bounding box、<ref> 表示描述引用。Percy 吐槽了那个固定 256:“这显然不够灵活,后面会被改掉”——顺带自嘲了一句,这个现象的根源是"讲义是用 HTML 写的"(幻灯片被裁掉了一部分)。
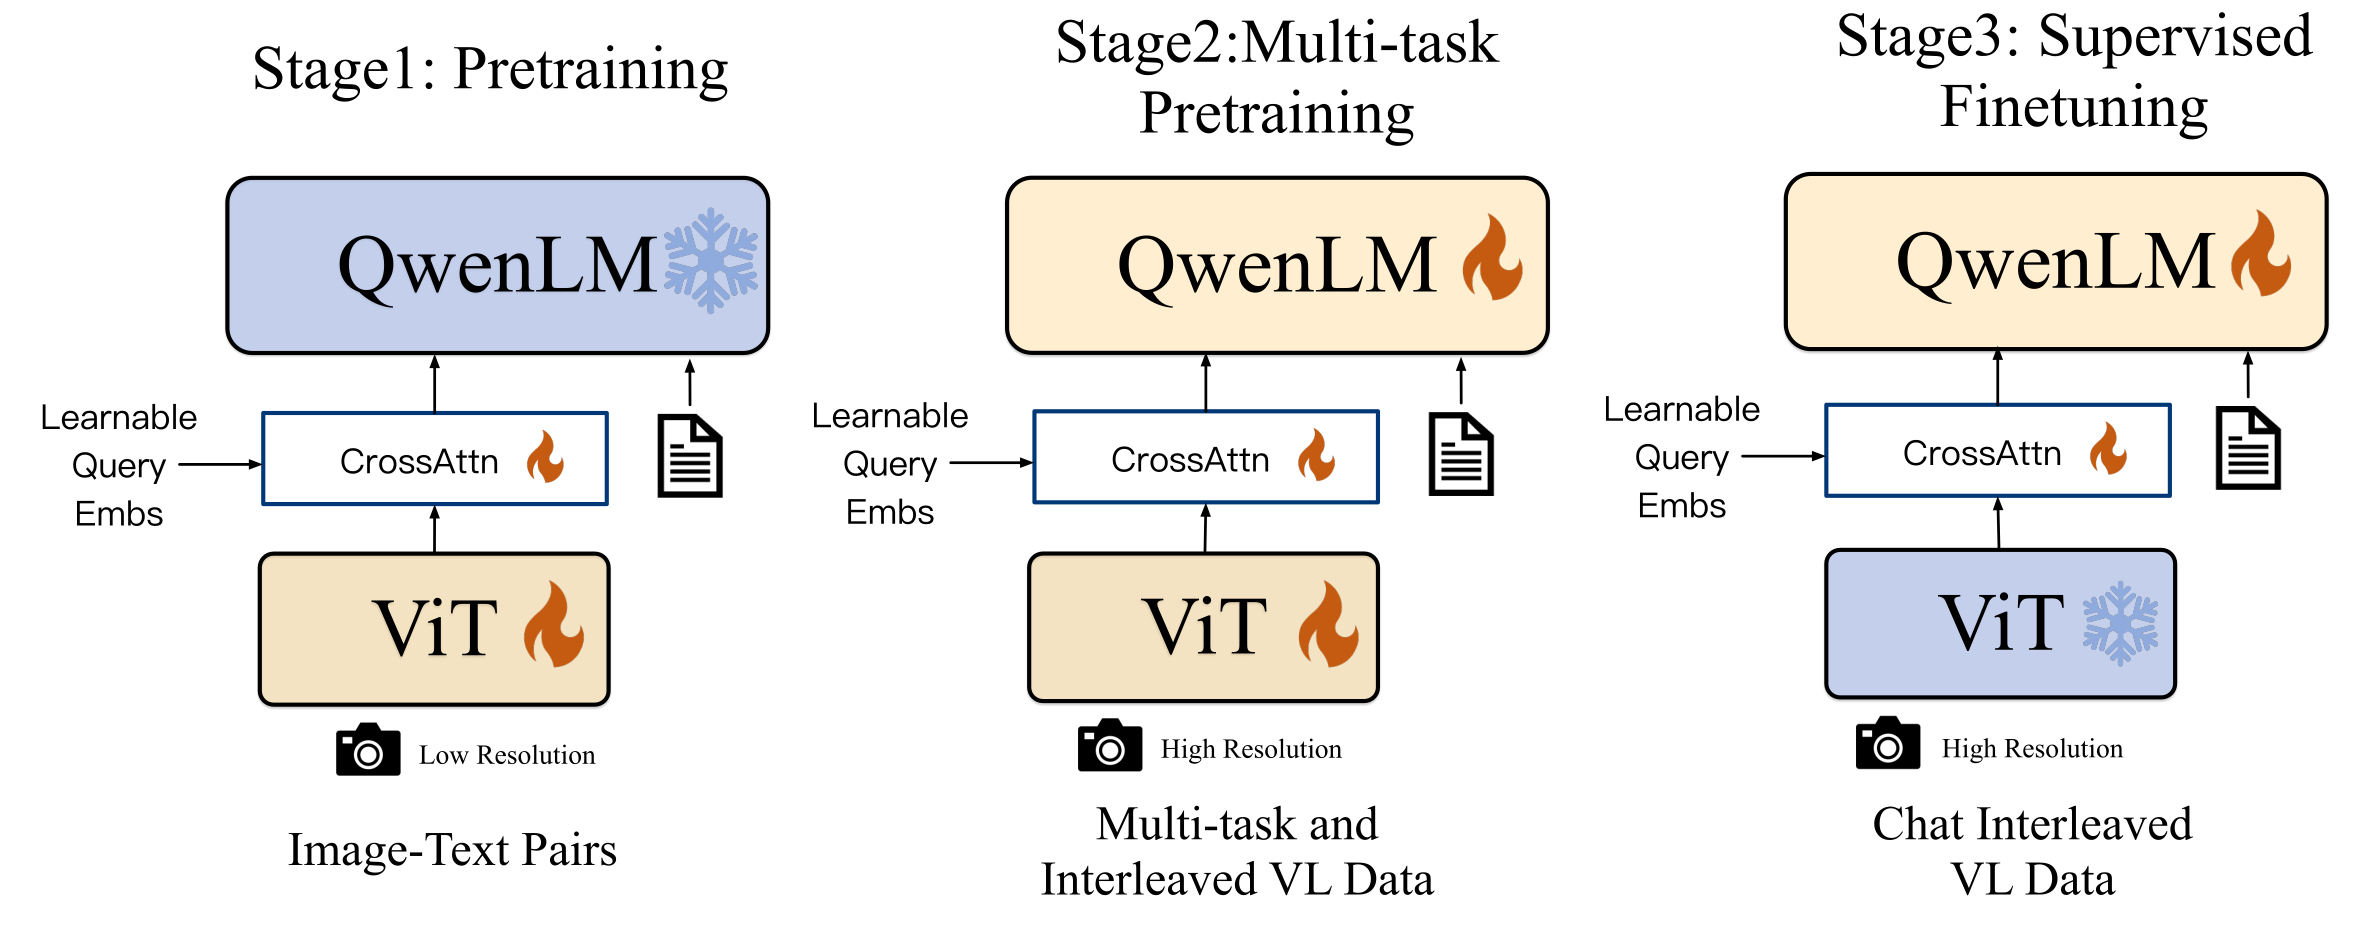
训练分三阶段,和 LLaVA 一样是三阶段,但冻结策略不同:
- Stage 1(Pretraining):大规模低质量数据(Image-Text Pairs),低分辨率。冻结 QwenLM,训练 ViT 和 CrossAttn adaptor。注意这里和 LLaVA 的区别——LLaVA 第一阶段冻结视觉 encoder 只训 projector,Qwen-VL 这一阶段是训练视觉 encoder 的。
- Stage 2(Multi-task Pretraining):质量更高的任务特定数据(多任务 + 交错图文数据),提高分辨率,训练全部参数。
- Stage 3(Supervised Finetuning):指令微调数据(Chat Interleaved VL Data),冻结 visual encoder,训练 adaptor 和 LM。
Percy 提到 Stage 1 的训练数据量是 1.4 billion 条样本。
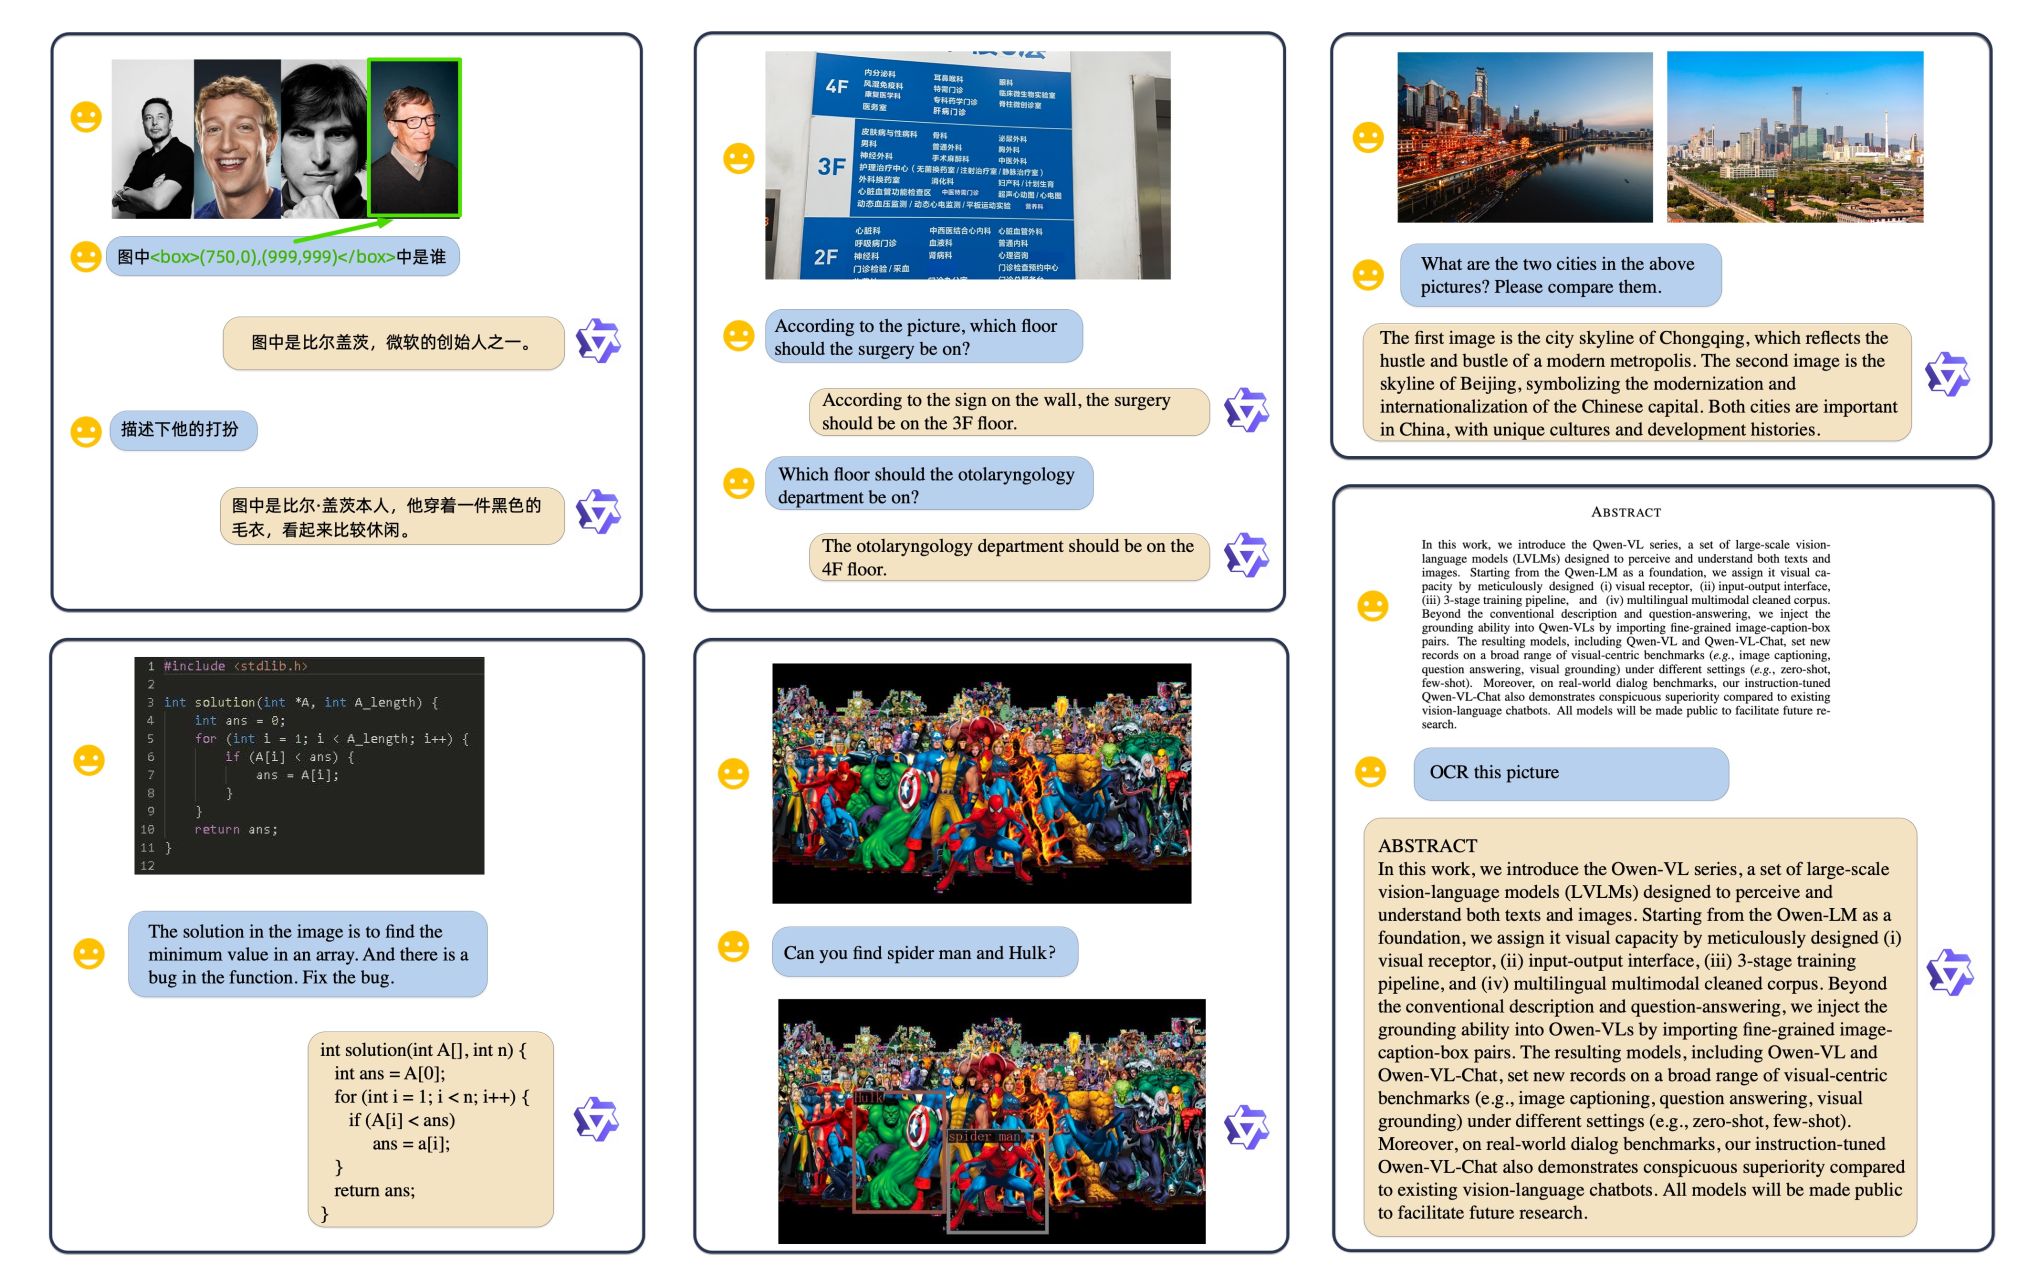
<box> 定位比尔·盖茨)、医院指示牌 OCR、城市对比、从截图改代码 bug、定位蜘蛛侠和浩克、OCR 论文摘要(讲义图 images/qwen-vl-examples.png)
六个象限里能看出这一版的取向。左上是用中文问 图中<box>(750,0),(999,999)</box>中是谁,模型答"比尔·盖茨,微软的创始人之一",接着还能用中文描述他的穿着——这体现了 <box> 这个特殊 token 的用法:模型输出的不是图像,而是边界框坐标。中间是医院楼层指示牌的 OCR,问"手术应该在几楼"(答 3 楼)、“耳鼻喉科在几楼”(答 4 楼)。右边是两张城市照片的对比描述。左下是一张 C 代码截图,问"找出最小值并修复 bug",模型识别出 ans = 0 的初始化错误。中下是"Can you find spider man and Hulk?",输出两个框。右下是"OCR this picture",直接把 Qwen-VL 论文的摘要识别出来。Percy 说这很"Qwen"——他们的目标本来就包含"让视觉模型也擅长代码",因为语言模型本身就会写代码。
7.2 Qwen2-VL:动态分辨率与 MRoPE
Qwen2-VL(https://arxiv.org/abs/2409.12191 )升级了两件事。视觉 encoder 更大,达到 675M;更关键的是引入了动态分辨率——Percy 指出这其实就是把 LLaVA 的 AnyRes 想法搬过来,而做视频时动态分辨率是必需的。
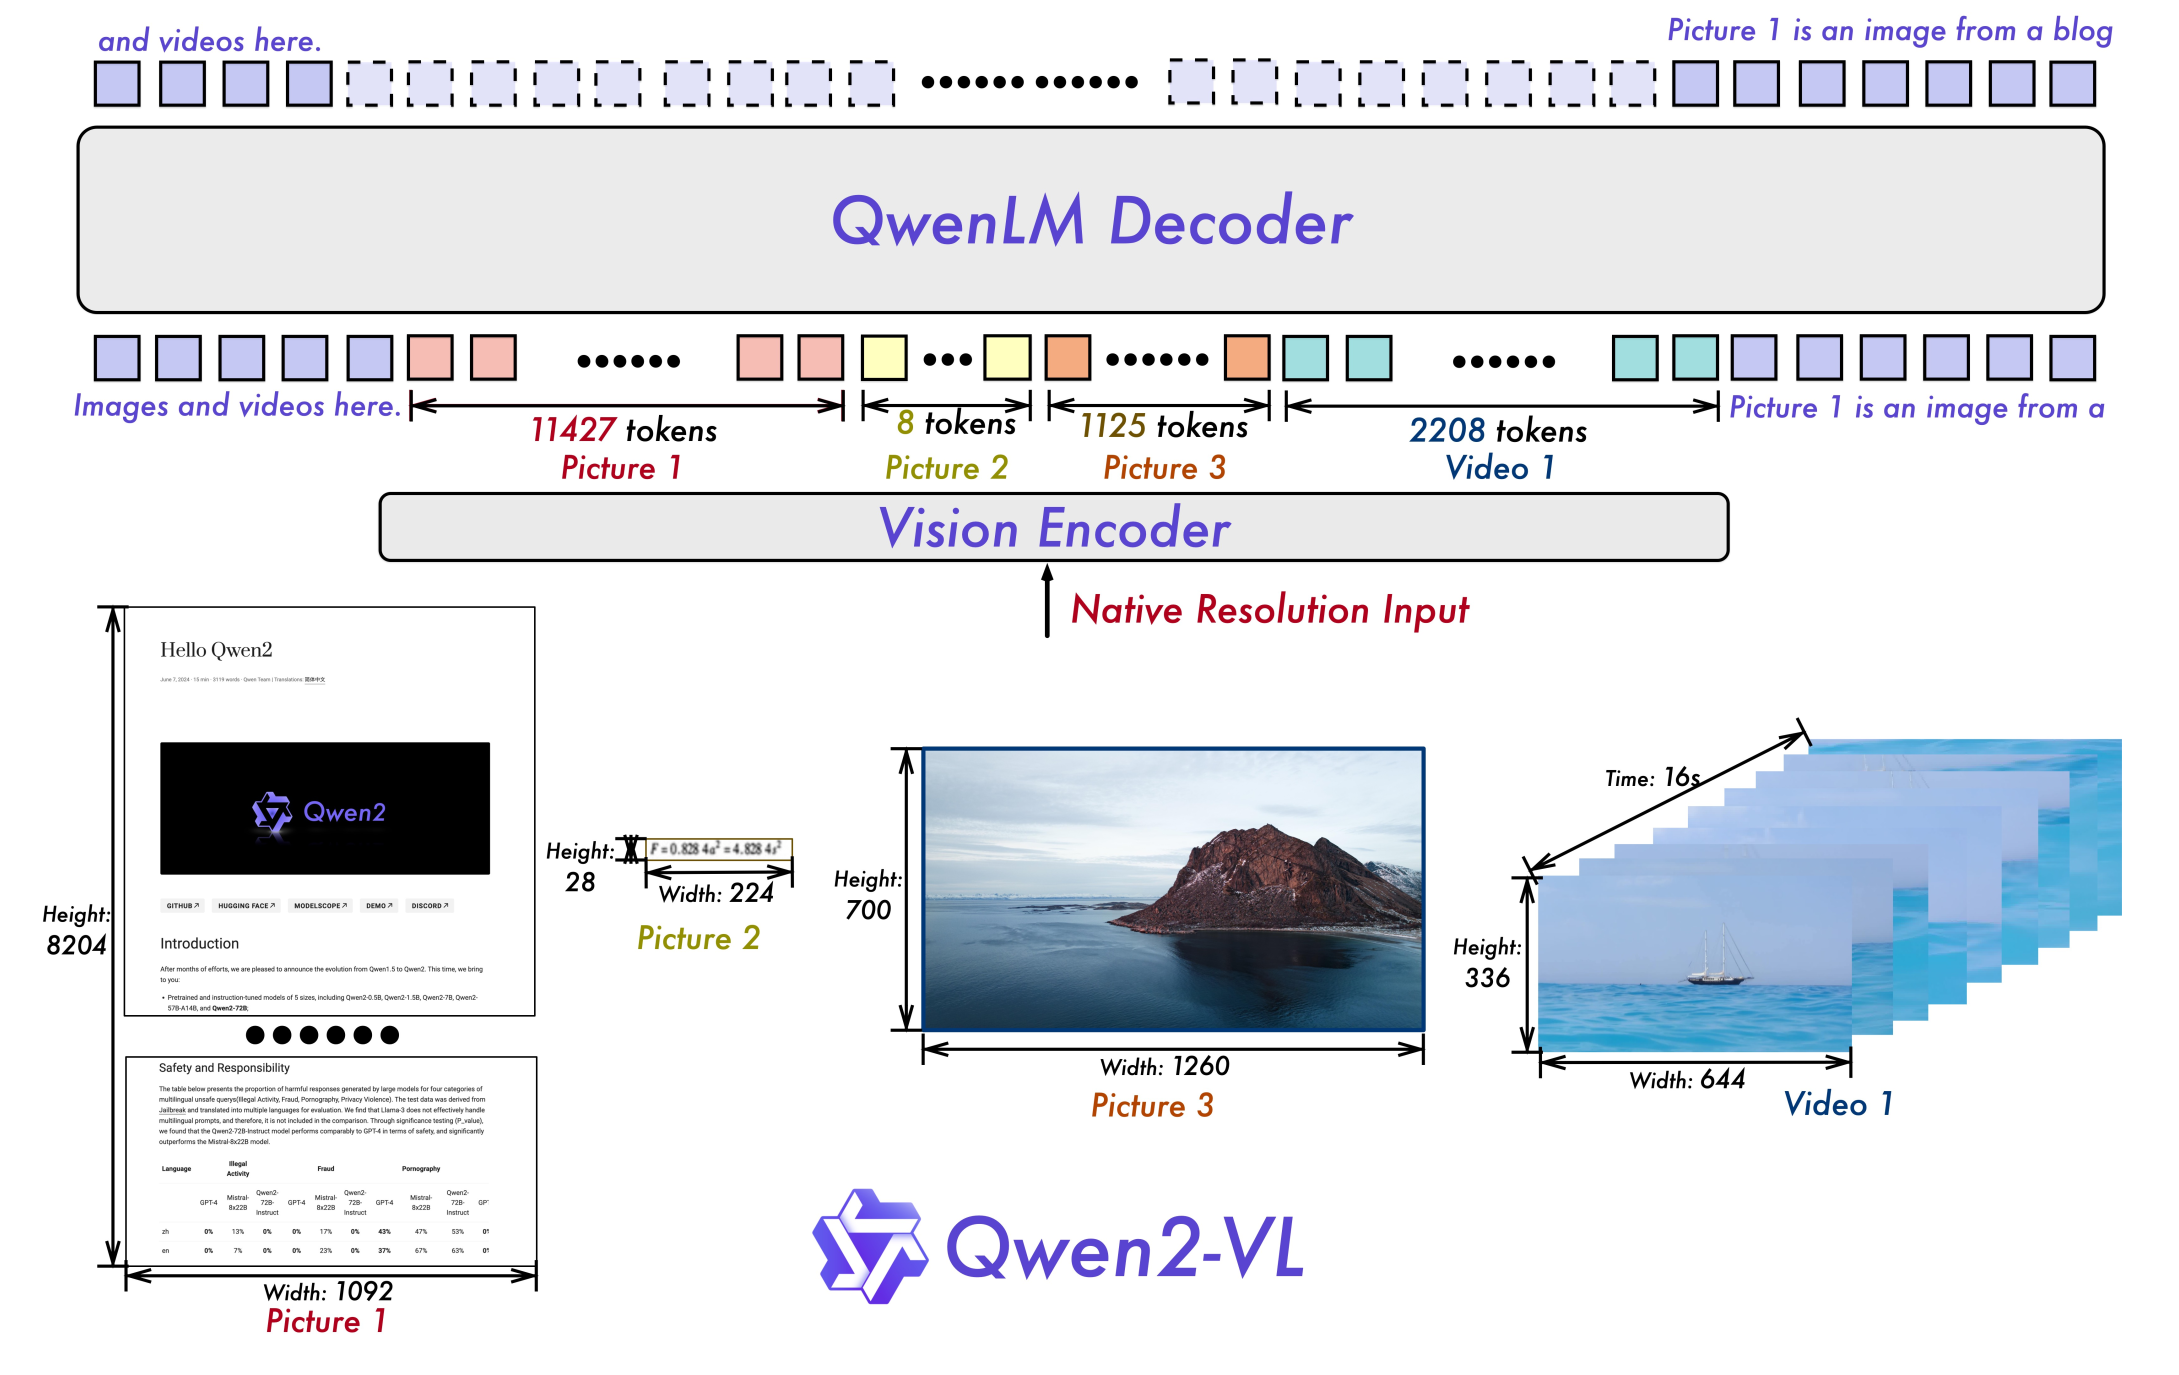
讲义图给了非常精确的对照,正好补上口述的约数:
| 输入 | 原始分辨率 | token 数 |
|---|---|---|
| Picture 1(一篇博客长截图) | 1092 × 8204 | 11427 |
| Picture 2(一张公式小图) | 224 × 28 | 8 |
| Picture 3(一张风景照片) | 1260 × 700 | 1125 |
| Video 1(16 秒视频) | 644 × 336 | 2208 |
Percy 口头说的是"这张图可能映射到 11,000 个 token,这张公式小图只映射到 8 个",图上给的精确值是 11427 和 8——差了三个数量级。机制是这样的:每个 224 × 224 的 patch 用 ViT/14 编码,然后为了压缩序列长度,把每 2 × 2 个 token 合并成 1 个,于是每个 patch 最终产生 66 个 token。视频则是每秒采样 2 帧,token 数上限 16,000(讲义其他地方的精确值是 16384)。Percy 还提了一句,那个 8 个 token 的公式小图旁边标着 $F = 0.8284f'^4 = 4.8284f'$,这是图像尺寸到 token 数的换算公式。
MRoPE(Multimodal Rotary Position Embedding)。回到 CLIP 那轮问答里关于位置编码的讨论,Qwen2-VL 在这里做了实质改动:
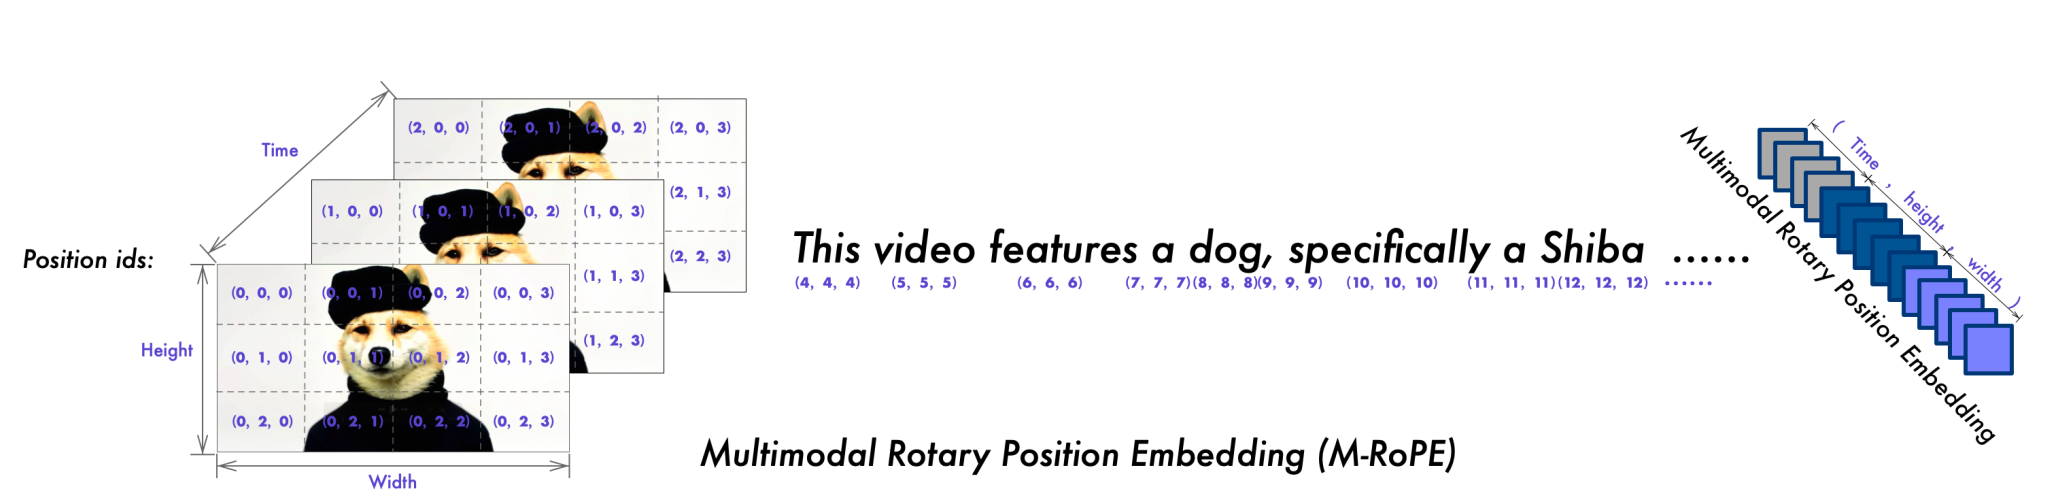
RoPE 的性质是:两个向量的内积只依赖它们的距离。一维情况下距离就是 token 索引之差。M-RoPE 把这个想法推广到 3D:一个 patch 的位置是一个三元组(time、height、width),每一维各自算 RoPE 再拼起来。图的左半部分是位置 id 的实际取值——第一帧(time = 0)是 $(0,0,0)$、$(0,0,1)$、$(0,0,2)$、$(0,0,3)$、$(0,1,0)$…… 沿 height 和 width 展开;第二帧 time = 1,以此类推;等到图像/视频 token 结束、进入文本 token 时,位置 id 变成 $(4,4,4)$、$(5,5,5)$、$(6,6,6)$——三个维度同步递增,相当于文本把时间轴也一起往前推。Percy 评价这个想法"相当直接",但预告了 Qwen3 会指出它其实有点次优。
其他细节:语言模型用 Qwen2 初始化,视觉 encoder 用 DFN 初始化(https://arxiv.org/abs/2309.17425 );训练还是三阶段(Stage 1 只训视觉 encoder、Stage 2 训全部参数、Stage 3 在指令跟随数据上训语言模型);Percy 强调从这里开始,一张图里会有一堆 token,上下文长度成了主要矛盾。
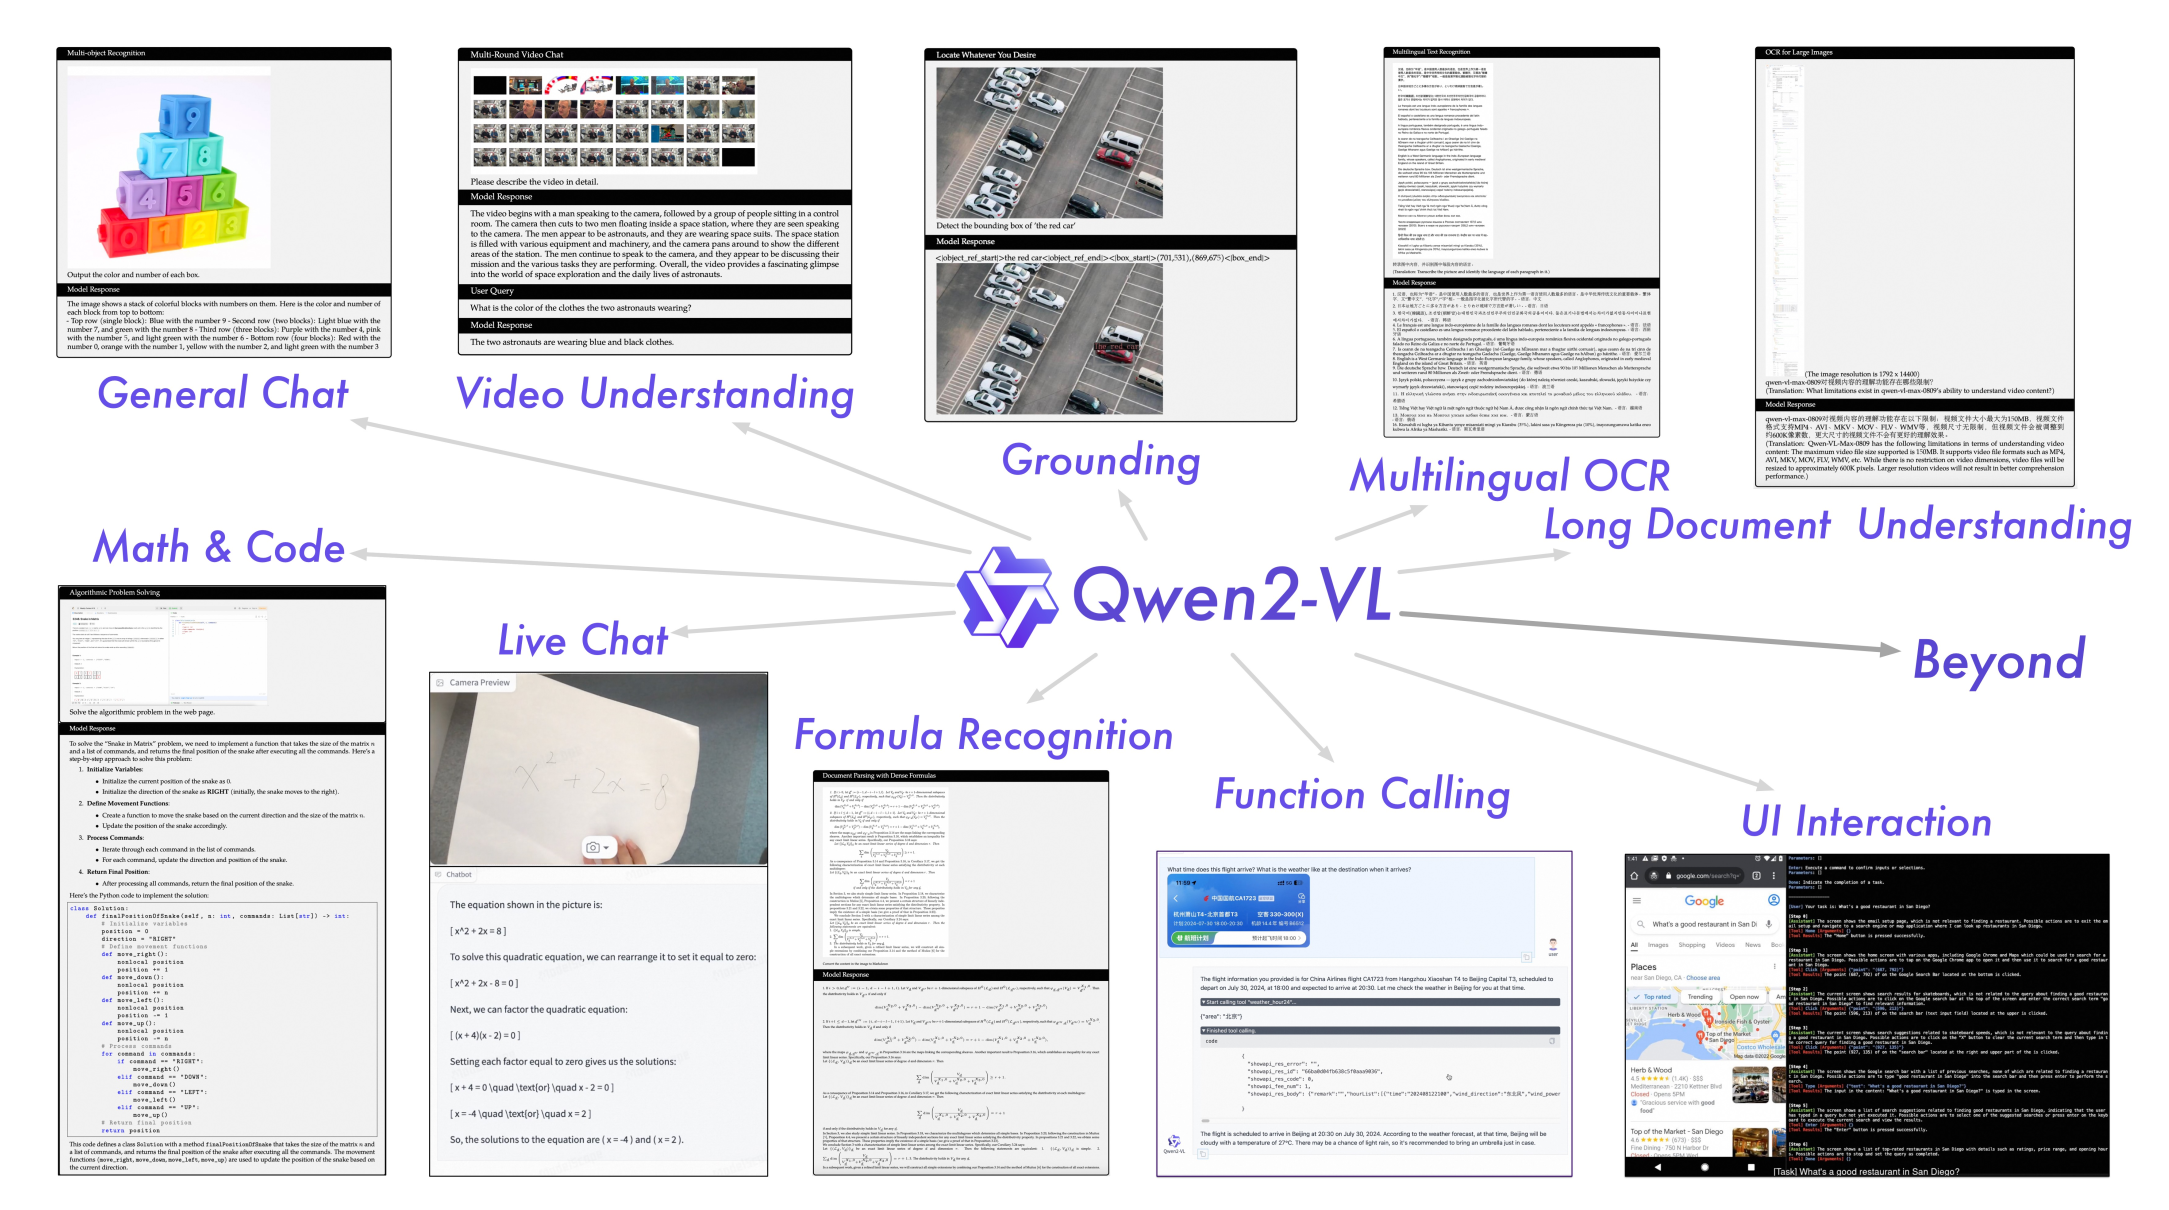
这张图值得记住,因为它标出了这类模型能力的边界已经推到哪里:多语言 OCR(希伯来文和中文混排)、超长文档理解(中文技术文档)、公式识别(手写 $x^2 + 2x = 8$ 的求解过程)、实时视频对话、函数调用(航班查询 API)、UI 交互(Google 地图订餐)——最后还画了个箭头指向 “Beyond”。
§8 Qwen3-VL:一个系统工程
Qwen3-VL(https://arxiv.org/abs/2511.21631 )是去年(相对讲义时间)的版本。Percy 的评价是:“我不认为这些是结构上的大改动,但它们大概都会影响模型质量。“而且——”这已经是一篇系统论文了"。
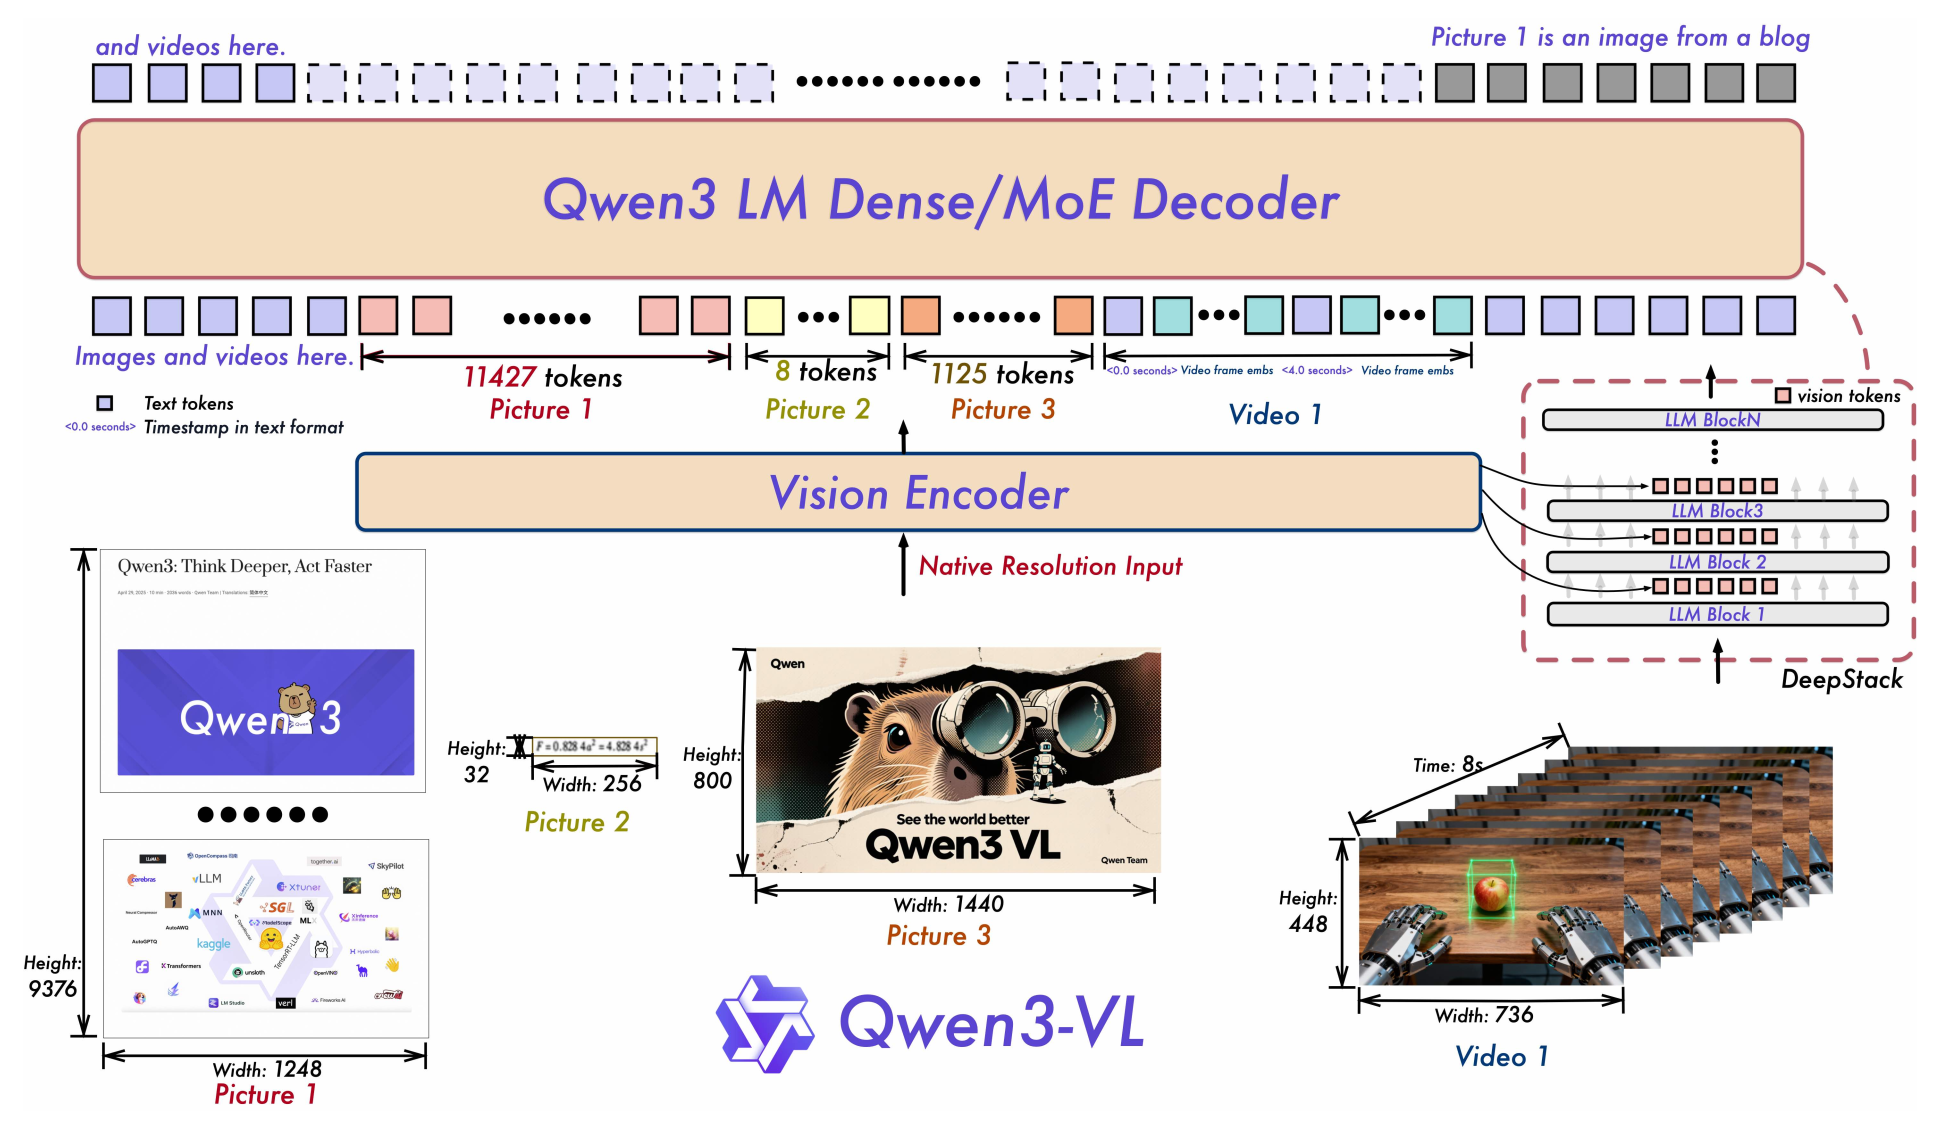
语言模型升级到 Qwen-3 系列,dense 和 MoE 都有,最大到 235B-A22B。Qwen-3 本身很强,这直接抬高了最终模型的质量。另一个重点投入方向是长上下文理解,上下文长度可以到 256K——做长视频时这是刚需。
视觉 encoder 换成 SigLIP-2(https://arxiv.org/pdf/2502.14786 ),它其实是 SigLIP 的改进版,架构完全相同、设计上向后兼容。
Interleaved MRoPE。这是对 Qwen2 那版 M-RoPE 的修正。原来的做法是把维度分块:前一段给时间、接着一段给宽度、最后一段给高度。问题在于 RoPE 的每个分量代表不同的频率——这样分块意味着所有时间维都是低频、所有高度维都是高频。Qwen3 意识到这一点后改成交织:
[t w h t w h t w h t w h] 而不是 [t t t t w w w w h h h h]这样每个轴都能同时暴露在低频和高频上。
显式时间戳。以前时间信息隐含在位置编码里——视频里每一帧天然占据不同位置,于是"有时间的概念"是位置编码的副产品。Qwen3 把时间显式化:直接插入代表时间的 token,比如 <0.0 seconds>、<4.0 seconds>(讲义图里画的就是这个)。Percy 推测这样做有用,是因为时间变成了可以直接引用的东西——你可以问"两秒之后发生了什么”。
sqrt 归一化的 per-token loss。问题在于样本长度极不均衡:视频样本非常长,单图样本非常短。默认做法是每个 token 权重相同,结果视频样本会压倒一切。Qwen3 的做法是把每个样本按长度的平方根归一化,以此压低超长样本的影响。Percy 说细节论文里讲得不清楚,但机制大概是这个。
DeepStack adaptor。回顾一下 adaptor 的演化史:LLaVA 是线性投影,然后是 MLP,然后是 cross-attention。DeepStack(https://arxiv.org/abs/2406.04334 ,DeepSeek 团队的论文)更进一步——它注意到视觉 encoder 本来就在每一层算出一叠视觉 embedding,于是把这些直接加进语言模型残差流的多个层里,图中画的是视觉 token 分别注入 LLM Block 1、Block 2、Block 3、…、Block N。Percy 的定性是:这比"视觉 encoder 是一个黑盒、只吐一个向量序列"要更深地融合。
训练流水线。现在有两段,预训练 4 个阶段 + 后训练 3 个阶段:
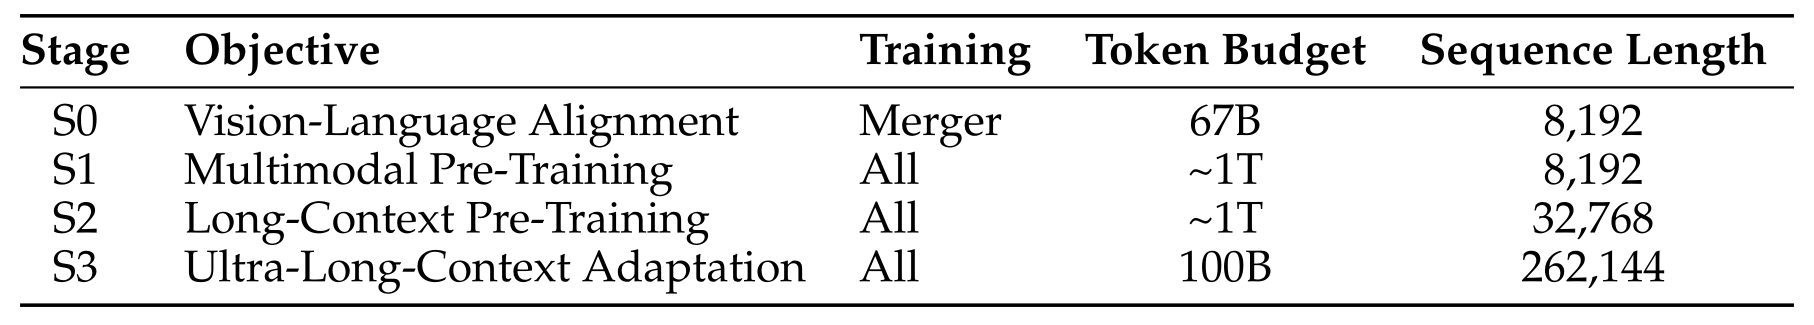
| Stage | 目标 | 训练范围 | token 预算 | 序列长度 |
|---|---|---|---|---|
| S0 | Vision-Language Alignment | 只训 Merger | 67B | 8,192 |
| S1 | Multimodal Pre-Training | 全部 | ~1T | 8,192 |
| S2 | Long-Context Pre-Training | 全部 | ~1T | 32,768 |
| S3 | Ultra-Long-Context Adaptation | 全部 | 100B | 262,144 |
这张表把 Percy 口述的几个点都对上了:S0 只用 67 billion token 做对齐(就是那个"没有自适应阈值,挑个 token 预算直接训"的阶段);S1 到 S3 序列长度从 8K 到 32K 再到 256K(精确值 262,144);token 的大头在中间两个阶段(各约 1T),最后那个超长上下文阶段只花 100B。后训练则是三个阶段:在长 CoT 数据上做 SFT、知识蒸馏、然后一些强化学习。
结果。Percy 说"如果看最终结果,这是个相当好的模型":
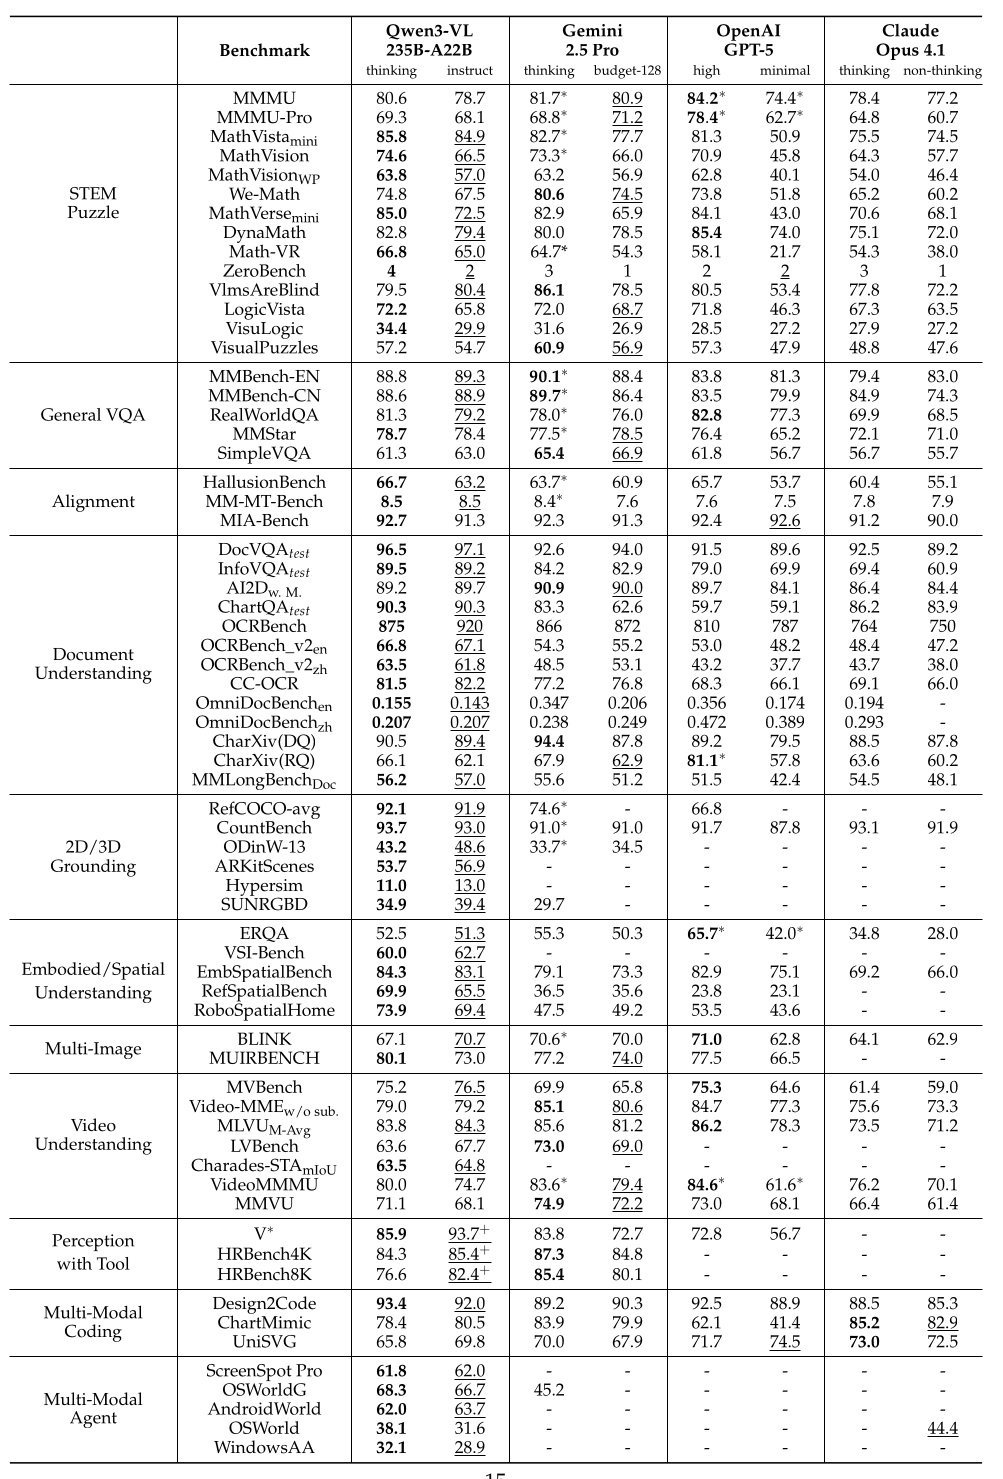
表里每一行加粗的是该行的最好成绩,可以看到 Qwen3-VL 在很多行上确实拿到了最好。挑几个数:MMMU 上 Qwen3-VL thinking 80.6 / instruct 78.7,Gemini 2.5 Pro thinking 81.7 / budget-128 80.9,GPT-5 high 84.2 / minimal 74.4,Opus 4.1 thinking 78.4 / non-thinking 77.2;DocVQA_test 上 Qwen3-VL 96.5 / 97.1;OCRBench 875 / 920;VLMsAreBlind 79.5。评测覆盖 STEM Puzzle、General VQA、Alignment、Document Understanding、2D/3D Grounding、Embodied/Spatial Understanding、Multi-Image、Video Understanding、Perception with Tool、Multi-Modal Coding、Multi-Modal Agent 十一个大类。
8.1 第五轮问答:会不会生成视频
有学生问:这些模型做视频生成吗?它怎么知道该输出视频还是文本?Percy 答得很干脆:这些模型不生成视频也不生成图像,所有多模态能力都在输入侧,输出永远是文本。而且除了 RL 那一步,其余所有阶段都是对每一个 token 做监督——没有 LLM-as-a-judge 去评价"这段描述好不好",监督信号就是你数据集里长什么样。只有到了 RL 阶段才可以去玩不同的 reward。
§9 第六到第八轮问答:多模态训练的系统侧代价
这一轮问答集中讲工程问题,信息密度很高。
第六轮:多模态训练从系统角度看更难吗? Percy 说"肯定不更容易"。他指出一个在语言模型课里被忽略的点:数据集更大,而视频数据的加载本身就可能成为瓶颈——讲语言模型时我们几乎不关心数据加载,因为它极其廉价;到了视频这里必须认真对待,所有"让数据加载异步于计算"的原则都要重新拿出来用。关于模态之间的 token 数失衡,他的回答是:视频和图像 token 更多,这正是那个 sqrt 归一化存在的原因;但反过来说,权重是可以调的——如果觉得多余你可以 down weight,这就是前两周讲的数据配比(data mixtures)在做的事。他还给了一个量级判断:模型是在 tens of trillions 的 token 上训练的,他不认为多模态 token 的数量会远远超过文本 token。
第七轮:对齐的时候,语言模型必须已经预训练过吗?怎么训? Percy 说必须预训练过,否则"对齐"这件事本身没有意义。做法是:语言模型冻结,只有 adaptor 在训练,任务是把这个给定的视觉 encoder 接到这个给定的语言模型上。训练方式就是挑一个 token 预算——他给的数字是 67 billion token——然后直接训,不存在什么自适应阈值。
第八轮:视觉 encoder 的参数量是不是远小于语言模型? Percy 说"是的,一般来说是这样",并且用 LLaVA 的具体数字做了说明:语言模型 72 billion 参数,而 projector 只有 72 million,ViT 一般不到 1 billion。他给出的原因是:视觉 encoder 在某种意义上做的是非常局部的操作——它看一个 patch,patch 非常小,它只是试图理解这些 patch,这里没有多少知识,也不需要推理。所以模型绝大部分能力仍然在语言模型里。他讲这段时还插了个小插曲:先念成"72 billion"然后发现图上写的是"72 million",当场纠正了过来。
§10 Chameleon:把图像也变成离散 token
讲完 Qwen3-VL,Percy 说这是最后一个视觉语言模型了,然后跳到一个"很不一样"的话题:Meta 2024 年的 Chameleon(https://arxiv.org/pdf/2405.09818 )。
10.1 动机:VLM 只能生成文本
前面所有 VLM 的共性缺陷是:它们把图像编码成向量注入语言模型,而因为它是语言模型,你只能生成文本,不能生成图像。要修这个问题有好几条路——比如拿一个 VLM 再挂一个 diffusion head。但 Chameleon 问的是另一个问题:如果我们把所有东西都映射成离散 token 呢?
Percy 说这条路"从美学上很吸引人",并坦承这可能反映了他是个"语言出身的人":现在你可以用完全相同的方式分析和生成图像,一切都是离散 token。想生成图像?给一段文本 prompt,然后生成一堆 token 就行。或者反过来:文本和图像可以交替出现。
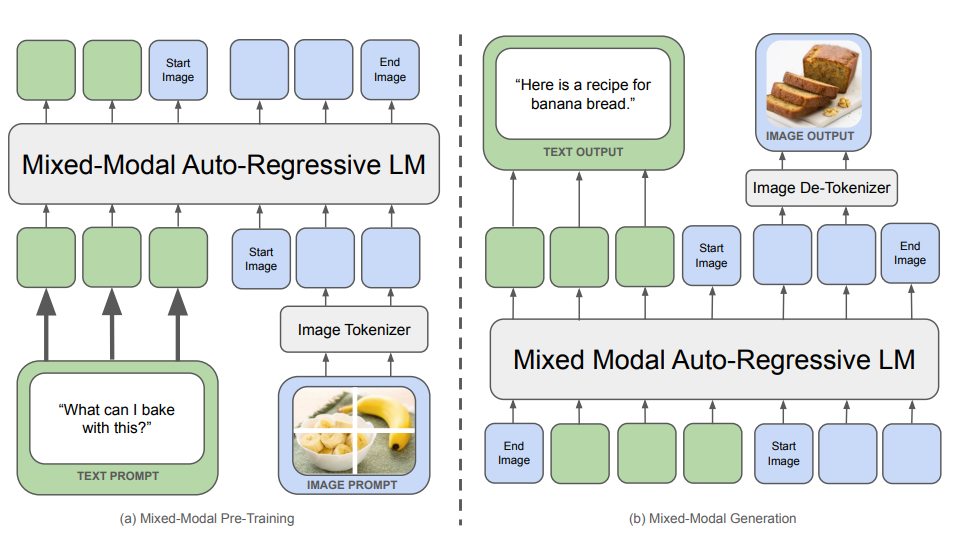
图的左半是预训练:一段文本 prompt(“What can I bake with this?")和一张图像 prompt(面粉、香蕉)分别编码,图像过 Image Tokenizer 变成 token,中间用 Start Image / End Image 这样的特殊 token 包起来,一起送进 Mixed-Modal Auto-Regressive LM。右半是生成:同一个 LM 吐出一串 token,文本部分直接解码成 “Here is a recipe for banana bread.",图像部分过 Image De-Tokenizer 还原成一张香蕉面包的照片。
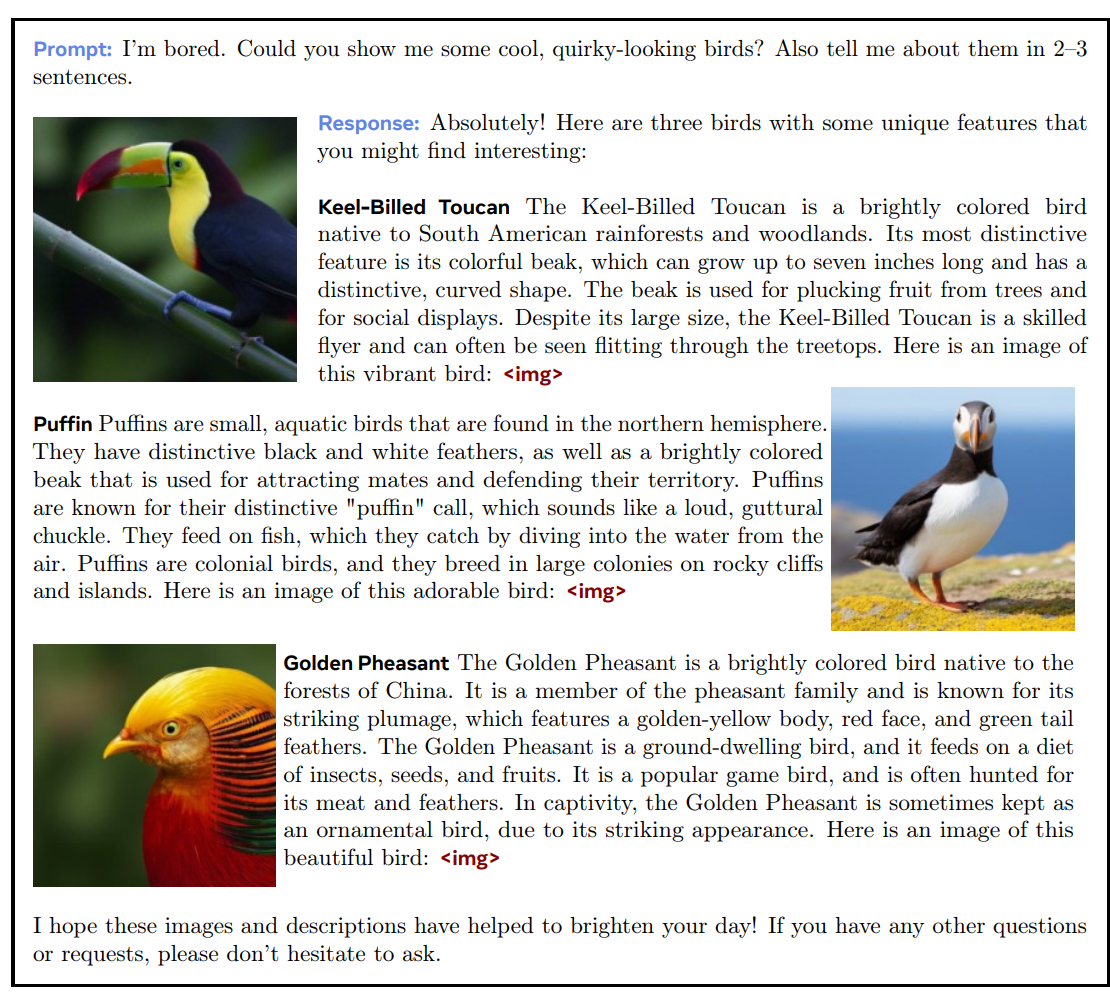
这张图很好地展示了"omni model"的愿景:文本和图像真的活在同一个空间里,靠"让一切都长得像文本"来实现。
10.2 VQ-VAE:怎么把图像变成离散 token
现在需要的是把图像映射成离散 token 的机制。Percy 提到一个相当老的想法,Oord 在 2017 年提出的 VQ-VAE(Vector Quantized Variational Autoencoder)。
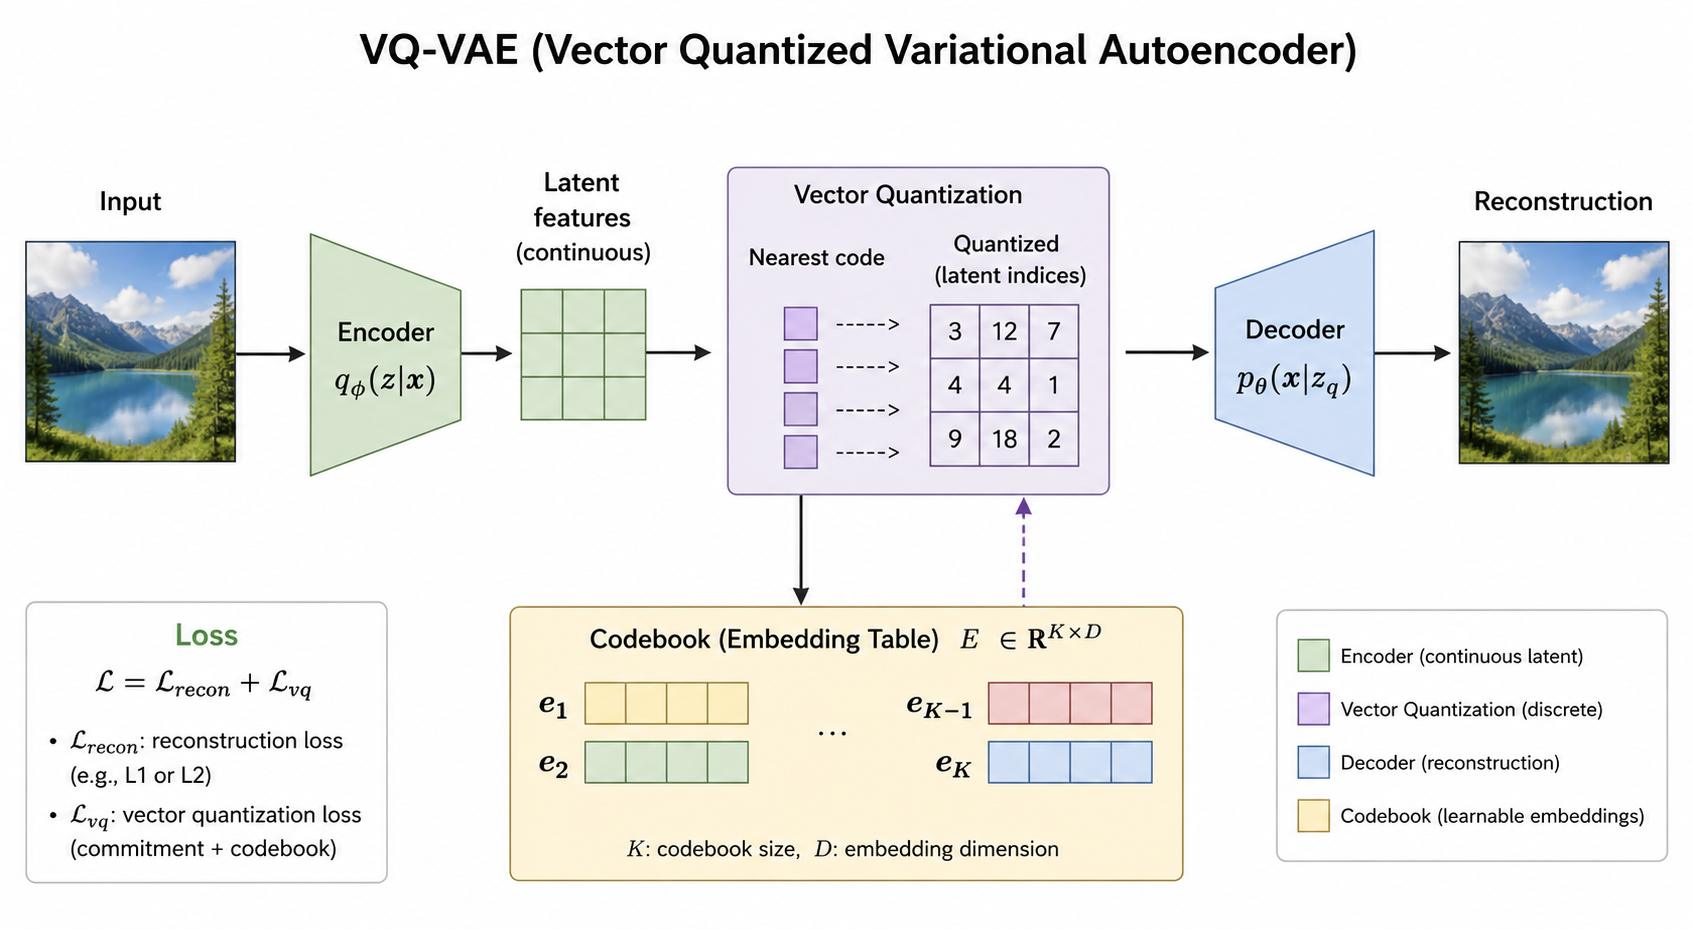
基本思路是:先把图像编码成一组连续向量,然后对每个向量在 codebook(码本) 里找最近的条目——Percy 口述的约数是 8,000 个码,讲义细节里是 8192——把它替换成那个码的索引。比如图中量化结果是 3 12 7 / 4 4 1 / 9 18 2 这样一个索引矩阵,码本 $E \in \mathbb{R}^{K \times D}$ 里的每个 $e_k$ 就是一块"原型 patch 长什么样"的模板。解码器拿到这个索引矩阵,查回对应的向量,重建出原图。训练方式是最小化重建损失(L1 或 L2);因为"取最近邻"这一步不可导,还要额外加一些项(图中写的是 $\mathcal{L} = \mathcal{L}_{recon} + \mathcal{L}_{vq}$,后者是 commitment + codebook 两部分),Percy 说时间关系就不展开了。
最终结果是:512 × 512 的图像被转成 1,024 个 token,每个 token 来自一个规模 8,000 的词表。既然现在数据的形态变了,Chameleon 还重新训练了一个新的 BPE tokenizer。
10.3 训练:简单,但会用不稳定报复你
一旦图像变成了 token,训练就变得极其直接——这就是普通的语言模型训练。没有 adaptor,没有视觉 encoder 要接,就只有一个语言模型。这是这条路最吸引人的地方。训练还是两个阶段(语言模型训练本身通常就有两个或更多阶段):第一阶段是训练的主体,基本是无监督的。
Stage 1 的具体配比是:2.9T 文本 token、1.5T 文本/图像 token、400B 交错(interleaved)token,合计占训练的 80%;Stage 2 占 20%,其中一半来自第一阶段数据、一半是高质量数据。
问题出在训练稳定性上。Percy 说他们发现训练不稳定,原因很根本:文本和图像虽然占据了同一个空间,行为却完全不同——把东西叫做"离散 token”,并不能掩盖那里真的住着一张图像。具体来说,预测下一个词是一个低熵任务,大多数词是可预测的;而图像 token 的熵非常高——“我根本不知道这个 token 会是哪一档的蓝色”。这两种熵混在一起,导致参数范数不断增长,进而产生 loss 不稳定(logit drift 问题)。他们的缓解手段是 QK norm 和 z-loss 正则化,用来控制范数增长。
10.4 结论:优雅但不划算
Percy 最后说,他"甚至不打算放结果了”,他讲这篇是为了它的优雅性——一个模型把真的所有模态一视同仁。但付出的代价有三个:
- 性能不如连续 encoder 的路线;
- 离散化确实丢信息,最典型的就是 OCR——把很小的印刷体离散化之后你就读不出来了;
- 多模态混合训练本身很难搞,在 Qwen 系列里已经见过要调权重的麻烦,这里被进一步放大。
他还补了一段历史脉络:VQ-VAE 曾经流行过一阵,很多人用它做图像生成——原因很实际,你手里有 transformer,而 transformer 怎么生成?只能生成离散的东西,于是把数据全塞进离散形式。但后来 diffusion 模型出现并变得可行,这条路就没那么流行了。
§11 收尾:没有万能的 encoder
最后 Percy 做了整体回顾。
前沿模型被期待是多模态的,甚至是更强的 “natively multimodal” 或 omni 模型。他评论说,Gemini 或 GPT 发布时都会被宣传成原生多模态、能处理所有这些模态,“事实上它们确实能”——但 怎么搭的完全没有细节。他的猜测是:连续的 encoder(因为你不希望丢信息)加上用于生成的 diffusion。他明确标注了这是推测。
根本挑战仍然是如何处理非文本模态。 然后他给出了这一讲最值得记住的一个观察:理解模态和生成模态之间存在不对称,而且不存在一个通用的 encoder。回到 CLIP——那里你只关心分类,只要抓住高层语义就行,所以向量可以相当小。但如果要做 OCR、或者要生成图像,你需要非常细粒度的信息——这也是 diffusion 表现好的原因,它能精细地优化从低频到高频的信息。
模态配比要小心。 视频的信息密度明显低于文本,你不能让视频压倒文本。
最后是方法论的落点:至少目前最好的方案是连续的 encoder——CLIP 已经五年了,即使是它和类似的思路,仍然是捕获图像语义的默认做法;transformer 还在那里;而生成侧要靠 diffusion,这一讲没有展开。
Percy 说这一讲就到这里,并且提了一句:这门课没有关于多模态的作业,“但如果你好奇,我鼓励你去玩玩训练一些这类模型”。
术语表
| 术语 | 说明 |
|---|---|
| omni model | 任意模态组合进、任意模态组合出的模型,是这一讲开头树立的目标 |
| CLIP | Contrastive Language-Image Pretraining,用 batch 内的对比目标把图像和文本对齐到同一向量空间 |
| SigLIP | Sigmoid Loss for Language Image Pre-Training,把 CLIP 的多分类换成逐对的二元分类 |
| ViT | Vision Transformer,把图像切成 patch、线性投影后过标准 Transformer encoder |
| attention pooling | CLIP 中做 QKV 时用所有激活的全局平均作为 query,得到与位置无关的全局表示 |
| zero-shot classification | 把类名套进模板变成文本、编码后与图像向量比相似度,类名从未参与训练 |
| AnyRes | LLaVA 1.5 引入的动态分辨率方案:图像切成 $a \times b$ 块分别编码再拼接,超量则双线性插值 |
| projector / adaptor | 连接视觉 encoder 与语言模型的模块,从线性投影 → MLP → cross-attention → DeepStack 逐步复杂化 |
| MRoPE | Multimodal Rotary Position Embedding,位置 id 变成 (time, height, width) 三元组,各维分别算 RoPE 再拼接 |
| DeepStack | 把视觉 encoder 多层算出的 embedding 直接注入语言模型残差流的多个层 |
| native resolution | 不再缩放裁剪到固定尺寸,直接按原图分辨率编码,token 数随图像尺寸变化 |
| VQ-VAE | Vector Quantized VAE,把图像编码成连续向量、再量化到码本得到离散 token,用重建损失训练 |
| codebook | VQ-VAE 里的原型向量表(Chameleon 用 8192 条),每个 patch 替换成最近的码的索引 |
| QK norm / z-loss | 用来抑制参数范数增长、稳定混合模态训练的两种正则化手段 |
拓展阅读
这一讲涉及的论文,按讲述顺序:
- CLIP — Learning Transferable Visual Models From Natural Language Supervision(2021)https://arxiv.org/abs/2103.00020
- ViT — An Image is Worth 16x16 Words(2020)https://arxiv.org/pdf/2010.11929
- OpenCLIP — Reproducible scaling laws for contrastive language-image learning(2022)https://arxiv.org/abs/2212.07143
- SigLIP — Sigmoid Loss for Language Image Pre-Training(2023)https://arxiv.org/abs/2303.15343
- WebLI — PaLI: A Jointly-Scaled Multilingual Language-Image Model(2022)https://arxiv.org/pdf/2209.06794
- LLaVA — Visual Instruction Tuning(2023)https://arxiv.org/abs/2304.08485
- LLaVA 1.5 — Improved Baselines with Visual Instruction Tuning https://static.hliu.cc/files/llava/improved_llava.pdf
- LLaVA OneVision — https://arxiv.org/pdf/2408.03326
- Vicuna — https://www.lmsys.org/blog/2023-03-30-vicuna/
- Qwen-VL — https://arxiv.org/abs/2308.12966
- Qwen2-VL — https://arxiv.org/abs/2409.12191
- DFN — Data Filtering Networks(2023)https://arxiv.org/abs/2309.17425
- Qwen3-VL — https://arxiv.org/abs/2511.21631
- SigLIP-2 — https://arxiv.org/pdf/2502.14786
- DeepStack — https://arxiv.org/abs/2406.04334
- Chameleon — Mixed-Modal Early-Fusion Foundation Models(2024)https://arxiv.org/pdf/2405.09818
- VQ-VAE — Neural Discrete Representation Learning(2017)https://arxiv.org/pdf/1711.00937
- Chameleon 的视觉 tokenizer 来源 — https://arxiv.org/pdf/2203.13131
讲义本身:
- 本讲可执行讲义:https://github.com/stanford-cs336/lectures/blob/main/lecture_17.py
- 讲义在课表上的渲染版本:https://cs336.stanford.edu/lectures/?trace=lecture_17
- 讲义引用图库:https://github.com/stanford-cs336/lectures/tree/main/images
外部资源
- CS336 课程主页:https://cs336.stanford.edu/
- 课程播放列表:https://www.youtube.com/playlist?list=PLoROMvodv4rMqXOcazWaTUHhq-yembLCV
- Stanford Online AI 项目:https://stanford.io/ai
关联主题
- 与 L16 的接续:L16 讲 RLVR——后训练最后一环;L17 换了个轴,从"文本进来文本出去"扩展到非文本模态的输入侧。两讲的共同结构是:把一个训练目标(reward / encoder)拆到"它到底在优化什么"这一层,然后指出这个选择带来的系统性偏差。
- 与 L7(并行化)的对照:SigLIP 的旋转文本方案是这一讲最"系统"的一段。它和 DDP 的差别正在于样本之间不可分解——语言模型训练里每个序列独立,而对比学习的每一项都耦合在全 batch 上。
- 与 L13/L14(数据)的对照:LLaVA OneVision 那张 1.6M 甜甜圈图是"数据配比"在视觉侧的翻版;Percy 说"这是近乎未经掩饰的 GPT-4 蒸馏",也直接连回数据来源那一讲的合成数据讨论。
- 与 L11(scaling case study)的对照:Qwen3-VL 的
S0 67B → S1 ~1T → S2 ~1T → S3 100B四阶段 token 预算表,是一个可以直接和语言模型预训练配比对照的工业级样本。 - 生成侧的另一条线:这一讲只讲输入(理解),输出(生成)被留给了 diffusion——收尾时 Percy 明确说这是他的推测而非讲义结论。
我的感想
(留空,待补充)
待深入 / 疑问
(留空,待补充)