视频: https://youtu.be/5sxHosTLPF8 | 频道: Stanford Online | 发布时间: 2026-05-27 时长: 1h24m46s | 播放量: 7471 (记录时) | 分类: llm 讲者: Percy Liang(课程主页 https://cs336.stanford.edu/ ;可执行讲义 https://github.com/stanford-cs336/lectures/blob/main/lecture_14.py )
视频简介: 本节课讲数据——过滤(filtering)、去重(deduplication)、混合(mixing)与合成数据(synthetic data),是上一讲"数据的来源与数据集"的续篇。前半段走完 pre-training 的数据流水线:HTML/PDF 到文本的转换(本质上是 lossy 的线性化)、过滤的通用骨架(给定 target T 从 raw R 中找相似的子集)、以及从零推导的去重算法(hash、Jaccard、MinHash、LSH)和数据混合(vibe/uniform/proportional 基线、UniMax、回归式混合、simulated epoching)。后半段转向后训练数据,以代码 agent 为主线,串起 OpenThoughts、SWE-smith、SWE-Zero、SWE-rebench 与 SWE-ZERO-12M。
1. 开场:从"数据从哪来"到"数据怎么处理"
Percy 开门见山定了基调:今天是数据部分的第二天。上一讲(Lecture 13)回答的问题是数据从哪来——互联网上是一堆活着的服务,数据要么被定期 dump、要么被爬,然后还有一堆法律与协议层面的问题(terms of service、版权、许可或 fair use)。而今天要往下游走一步,看数据进来之后流水线上发生了什么:transformation(把原始格式变成文本)、filtering(留下想要的)、deduplication(去掉重复的)、mixing(决定不同来源的配比)。最后用一小段时间讲 post-training 数据,尤其是这几年合成数据(synthetic data)的用法。
他特别提示了阅读姿态:前面四分之三的内容都是在讲 pre-training,心里要有这个锚。只有最后一段才是后训练。这个划分很重要,因为过滤、去重、混合这三件事在 pre-training 和 post-training 里的形态完全不同——pre-training 的数据处理是"任务无关"的(task agnostic),你在打造的是一个通用能力的底座;而后训练的数据则高度任务相关,几乎每一个数据集都是为某一类具体能力定制的。
这一讲的骨架,用一句话概括就是:一条从原始字节到"该拿什么喂给模型"的完整链路,以及链路上每一个决策点背后的权衡。 Percy 在结尾也坦白说,真实的 data work 比这节课看起来要琐碎得多、领域特异得多——“这节课并不代表数据工作真正的样子”,但它给出了整片地形。
2. HTML → text:一个本质上不可逆的转换
2.1 原始数据不是文本
第一个反直觉的事实:你爬下来的东西不是文本。 如果你打开 Common Crawl 看里面装的是什么,那是 HTML;有时候是 PDF;在 GitHub 的场景里是目录树。所以 transformation 这一步的全部工作量,绝大部分花在 HTML 上——因为 web 的绝大部分就是 HTML。
Percy 强调这个处理过程"相当 heuristics"(fairly heuristic)。你要做的事情是两件:去掉 boilerplate(导航栏、广告这些装饰性的东西),抽取 content(页面真正的主体)。但这里有个微妙的边界问题:什么算 content,什么不算?通常你会扔掉页脚、页头、菜单这些东西,但完全可以想象,导航元素本身也携带了"网页长什么样"的信息——如果你希望模型理解 web 这个媒介本身,把导航全删掉反而是一种信息损失。所以"什么是 content"这个问题没有标准答案。
更麻烦的是页面里的图片和表格。Percy 在这里给出了本节的中心论断:这个过程在本质上是 lossy 的(inherently lossy)。理由是:HTML 要么是层级结构的(DOM 树),要么是视觉结构的(渲染出来的版面),而你要把它线性化(linearize)成一串 token。层级或二维的东西压成一维序列,信息必然丢失,只能选择丢哪些。
表格是这个损失最刺眼的地方。简单的表格可以用 markdown 渲染出来,勉强保住了行列关系;但嵌套表格(nested tables)就极其难办了——你必须在某个点上放弃,或者做一个近似。这是"线性化"这个动作本身的代价,不是实现不够好的问题。
2.2 为什么仍然是 rule-based 的天下
既然损失这么大、语义这么复杂,为什么不用模型来处理?Percy 的回答很务实:HTML 转文本这一步是 rule-based 的,因为规则处理器极快,而且你在这里并不需要太多智能。
他给了几个具体的工具名:trafilatura、resiliparse、jusText、lynx。这些都是成熟的、确定性的抽取器。Percy 承认"用模型做这件事是有道理的"(there could be a case for model-based interventions),但前提是模型必须非常快,而且要真的比规则做得更聪明——在 Common Crawl 这个量级上,任何一点慢都会被放大成不可接受的成本。
然后是本节最容易被忽略的一句警告:规则处理器的失败率是必然存在的,你去看真实数据就会发现里面全是瑕疵(imperfections)。而且——这一点接上了上一讲的结论——选哪个工具是真的会影响下游 accuracy 的。Percy 顺手给了一个实证结论:在扩展版的 DCLM 评测上,Resiliparse 的表现比其它几个工具更好。
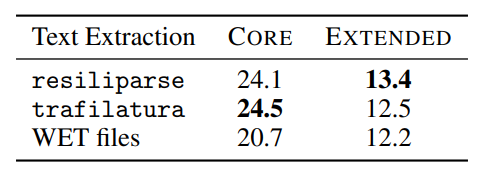
(上图和上一讲的同一张图——DCLM 论文里用不同 WET 抽取方式训练模型后的 loss 对比,是"抽取工具的选择会传导到模型质量"这个论点的原始证据。)
2.3 PDF:一类被低估的高质量数据
接下来是 PDF,对应 Hugging Face 的工作 FinePDFs。Percy 用一句话抓住了 PDF 的本质:如果你不在 PDF 阅读器里打开它、而是直接看文件内容,它长成这样(一堆绘图指令),它是需要被"渲染"才成为文档的。
PDF 的来源和 HTML 不同。网页上会有 PDF,Common Crawl 里也有一些 PDF,但 Common Crawl 的主体是文本,PDF 只占很小一部分。而且如果 URL 没有扩展名,你在抓取之前根本不知道它是不是 PDF。FinePDFs 那篇博客里有一个很实际的细节:Common Crawl 里很多 PDF 是被截断的(truncated)——因为 PDF 文件大,抓取有大小上限——所以想让 PDF 数据可用,重新爬取(recrawl)是必要的一步。
拿到文件之后还有第二个问题:怎么把它变成文本。有些 PDF 根本就是扫描件,本质上是图片。FinePDFs 试了一堆工具,主要路线是用 VLM 跑 OCR(Percy 点名了 RolmOCR),另一条是 Docling;难点在于要让这些模型跑得足够快,否则成本无法承受。这个代价明显比处理 HTML 高得多——OCR 一个 PDF 的计算量,和用规则抽一个网页不是同一量级。
但 Percy 给出了一个关键的判断:幸运也不幸的是,PDF 在整个互联网里只占很小一个比例。但它们的价值很高。他的理由很有洞察力:“如果你肯费劲去做一个 PDF,那说明你大概有值得说的东西”——相比之下网页是随手就能生成的。所以一份平均水平的 PDF,质量普遍高于一份平均水平的 HTML。
代价是 PDF 比网页missing更多:网页还有 h1、p 这种标签提供语义信息,而PDF 按设计就是关于版面的(all about layout),它根本不承诺保留语义结构。所以从 PDF 出发的转换,语义层面的损失更大,得靠大量后处理来补。
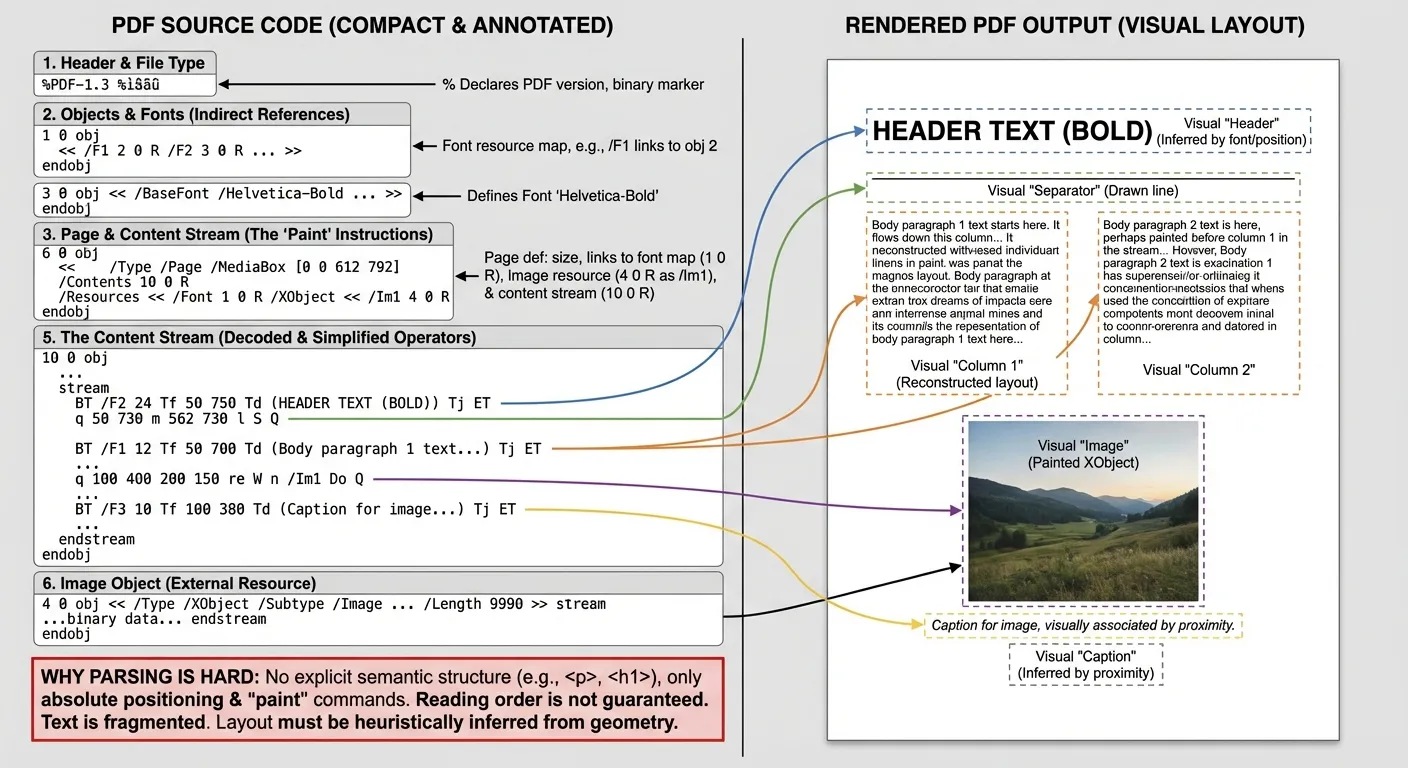
(上图左边是 PDF 的源码,右边是渲染结果,彩色箭头把 BT /F2 24 Tf 50 750 Td (HEADER TEXT) Tj ET 这类"绘制指令"连到视觉元素上。图下方的结论框写得很直白:PDF 里没有显式的语义结构(没有 <p>、<h1>),只有绝对定位和"绘制"命令;阅读顺序不保证;文本是碎片的;版面必须从几何信息里启发式地推断出来。 这张图是理解"为什么 PDF 解析难"最直接的一张。)
3. 过滤的第一性框架:给定 T,从 R 里找像 T 的东西
3.1 一个几乎包住所有过滤方法的骨架
“到这一步你已经有文本了,但你离完成还差得远。” Percy 从这里切入过滤(filtering),并且刻意从一个抽象的骨架讲起,而不是先讲具体方法。
这个骨架是:你手上有一份想要的 target data T(通常是一小份高质量数据),和一大堆 raw data R(上一节刚转换出来的"刚下船的 token")。目标是找到 R 里一个和 T 相似的子集 T’。 Percy 说得很确定:几乎所有种类的过滤都落在这个 schema 里。
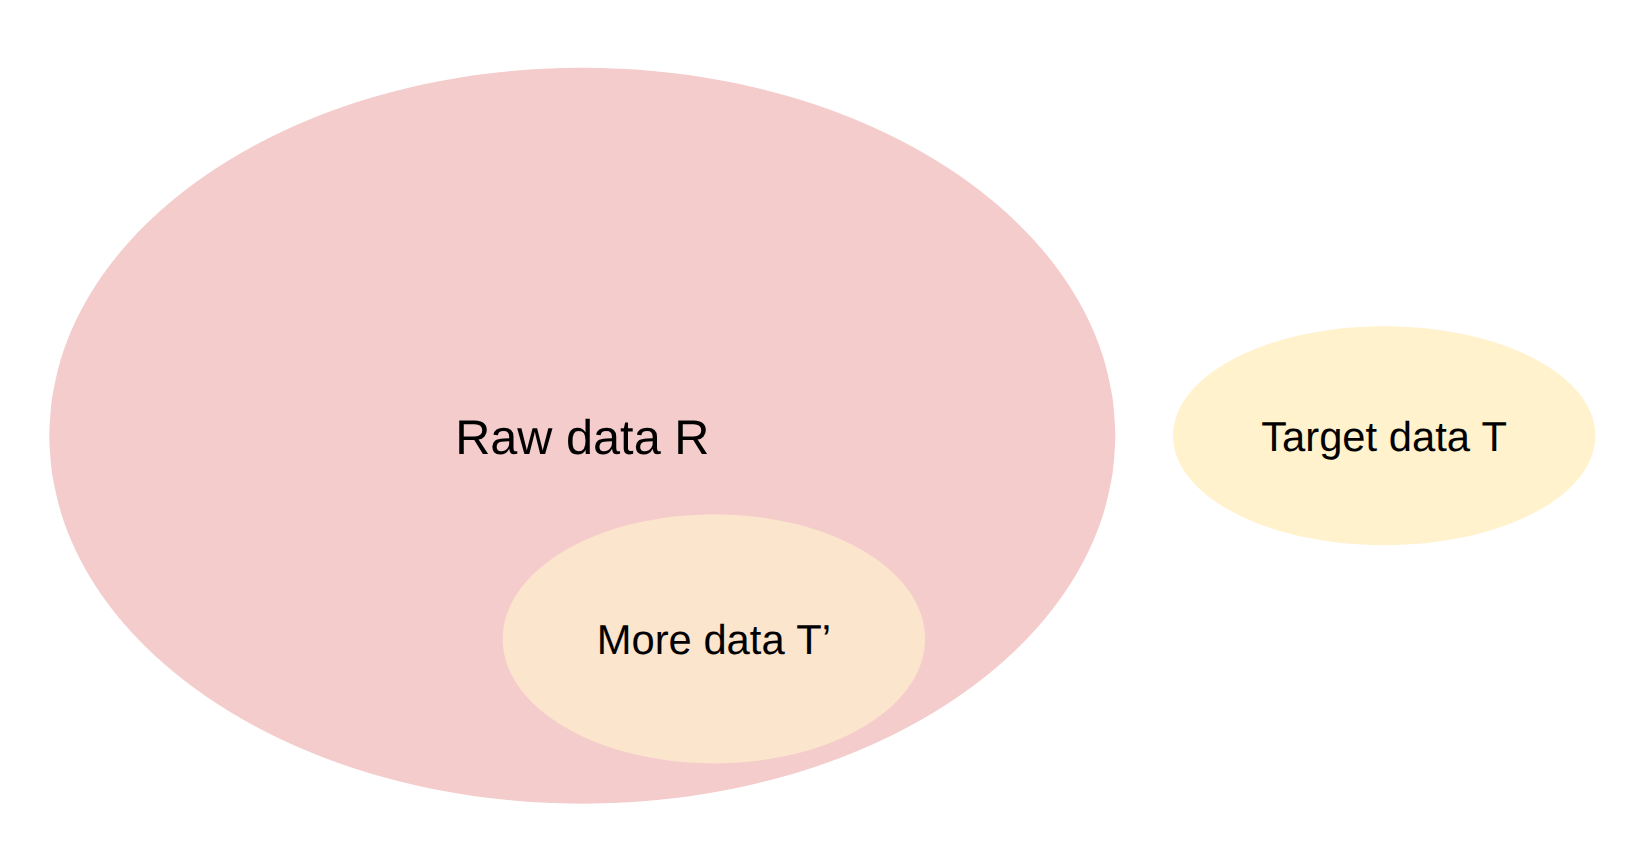
(讲义这张欧拉图标出了三个集合的关系:大的粉色椭圆是 Raw data R,里面套着一个小的黄色椭圆 More data T’,而右侧独立的黄色椭圆是 Target data T,与 R 完全不相交。它想说明的是:你要找的是 T 在 R 中的"同类物",而不是 T 自己——T’ 是 R 的子集,却要和 T 相似,这个"相似但不同"正是过滤能泛化的前提。有意思的是这张图的布局把 T 画在了 R 外面,恰好也提示了真实情况:很多你真正想要的数据,原始爬取里根本不存在。)
3.2 三类应用与两条硬性要求
这个骨架下有三个典型应用方向。第一是语言识别:如果你要训一个英语模型或德语模型,你需要先认出语言、把不匹配的过滤掉。第二是质量过滤,也是过滤最主要的动机:你要的是高价值、百科式的信息,不要 spam。第三是毒性过滤:互联网上脏东西很多,你可能不想在自己的模型里训练它。
一个好的过滤算法必须满足两条要求,它们决定了技术选型:
第一,必须能从 target data 泛化出去。 你已经有 T 了,你不需要只得到 T,你需要的是"像 T 但比 T 大得多"的东西。这是整个方法能work的前提。
第二,必须极快。 因为你要在整个互联网上跑它。Percy 给了一个尺度感:这可能是100 万亿(100 trillion)token 量级的数据。
结局是收敛的:过滤之后你通常只留下一个很小的比例——单位数百分比(a single-digit fraction)。淘汰掉的是九成以上的原始数据。
3.3 两种打分器:生成式 vs 判别式
具体的做法是两步:第一步,基于 R 和 T 估计一个模型,导出一个打分函数;第二步,按分数保留 R 里的样本。
打分器有两种类型:
生成式模型(generative):直接对 target 数据建模。KenLM 是最典型的代表——它的做法就是"我训一个 5-gram 模型",然后 score(x) = p_T(x)。Percy 强调这里必须便宜,所以你不会去训一个大语言模型来做这件事。
简单分类器(classifier):这是现在更主流的做法。它预测的是 score(x) = p(T | x)——把 T 里的样本当正例,把 R 里随机采样的样本当负例(可能做个平衡),然后训一个分类器。工具上大家一般用 fastText,因为它快;而且本质上它就是个线性分类器、词袋模型(bag of words)。
有了打分之后,就是设一个合适的阈值(取决于你对质量的定位),然后保留超过阈值的样本。这里有个细节:保留有时候是随机的(sometimes stochastically),有时候不是——下面讲 GPT-3 时会看到那个非常漂亮的随机保留公式。
3.4 一场路线之争,以及现在的结论
Percy 在这里回望了上一讲的历史:几年前有很多数据集(C4、Gopher、RefinedWeb、FineWeb、Dolma)是刻意不用模型过滤的,理由是"不想让数据带上偏见"(not bias things too much)。
而现在的结论很明确:几乎所有模型都做某种程度的 model-based filtering 了,这已经成了常态(becoming the norm)。他给的理由是一段很清醒的算力经济学:除非你算力极度充裕——那种情况下你确实不需要过滤,直接在全部数据上训一个巨大的模型就行——否则大多数人都属于"算力贫乏"的一侧,你必须非常聪明地做过滤,否则就是在把 FLOPs 浪费在低质量内容上。
这句话是后面一切过滤方法的动机来源。过滤不是"洁癖",是算力约束下的必然选择。
4. 过滤的四个实例
4.1 语言识别:一个"基本被解决"的问题
目标很单纯:给一段文本,判断它是不是某个特定语言。Meta 训过一整套 fastText 语言识别模型,通常可以直接拿来用(off the shelf)。它支持 176 种语言,训练数据来自一批多语站点——Wikipedia(本身就有很多语种)、Tatoeba(一个翻译社区网站)和 SETimes(东南欧新闻语料)。
Percy 对这个问题难度的判断是:语言识别相比我们面对的大多数任务都算简单问题——“看几个词你就能看出来它是西班牙语还是日语”,所以一个简单分类器就够了。但他也承认它不是完全解决了:code-switching(语码混用)和方言是真实的麻烦。不过结论还是一样的:语言 ID 不是训一个好模型的瓶颈。
一个具体的落地细节来自 Dolma:它保留 p(English) >= 0.5 的页面。注意这个阈值有多松——一半概率是英语就留下。这本身就是"这个任务不难"的量化体现。
4.2 OpenMathText:不训练单个分类器,而是串一条流水线
第二个例子换了个方向:不是过滤"坏的",而是定向收集"某一类"数据。场景是"我想让模型数学特别好,那我就去找一堆数学语料"。
OpenMathText 是 2023 年的工作,目标是造一个大规模的数学文本语料。Percy 特意指出:它并不是训练一个单一分类器,而是一条多步流水线。 步骤是:
先用规则过滤一遍(比如判断文本里有没有 LaTeX 命令);然后用 KenLM——这是生成式路线——在 ProofPile(一个已知的数学数据集)上训练,保留 perplexity 低于 15000 的样本;再训练一个 fastText 分类器判断"这是不是数学写作",而且阈值是双档的:含 LaTeX 时用 0.17,不含 LaTeX 时用 0.8。这个双阈值的设计逻辑是"含 LaTeX 本身就是很强的证据,所以门槛可以放宽;不含 LaTeX 就得靠分类器更严格地把关"。
结果:产出了 14.7B tokens,用它训练的 1.4B 模型,表现超过了用 20 倍数据训练出来的、没做这种定向过滤的模型。
Percy 从这件事里抽出的教训是整个过滤章节最重要的一句:质量过滤应该被当成一个工具(think about it as a tool),你可以把 quality 定义成任何你想要的东西。世界上不存在普适的 quality 概念。 如果你想定义质量 = 数学,那你就能拿到数学,并且在数学上变强。这一句把"过滤"从"清洗数据"的被动动作,翻转成了"按需求塑造数据分布"的主动动作。
4.3 GPT-3、LLaMA 与 phi-1:同框架的三种变体
把 GPT-3 放进这个框架之后,它的做法就变得非常清楚:正例是 Wikipedia、WebText2、Books1、Books2 的采样,负例是 Common Crawl 的采样,训练一个基于词特征的线性分类器,然后按分数保留文档。
Percy 特别把那个保留策略单独拎出来讲,因为它是随机保留的一个经典实例:
def keep_document(score: float) -> bool:
return np.random.pareto(9) > 1 - score它的含义是:这不是"分数过线就要、不过线就不要"的硬阈值,而是让保留概率随分数平滑变化。分数越接近 1,1 - score 越接近 0,帕累托分布几乎总是大于它,文档几乎必被保留;分数越低,被丢弃的概率越高。这比硬阈值更优雅的地方在于,它避免在阈值附近做一刀切的决定——那些"擦边"的文档有机会被保留一部分,而不是全部被砍掉。
LLaMA(以及 RedPajama)是同一框架的另一个变体:正例是"被 Wikipedia 引用的页面",而不是 Wikipedia 文章本身。这个区别很关键——Wikipedia 文章本身已经被反复训练过了,而它引用的外部页面是一批"经过人工筛选、但模型没怎么见过"的语料。负例同样来自 Common Crawl。
phi-1(微软)是这个框架里最有意思的一个,因为它把 target 的定义本身变成了一个昂贵的模型的输出。它要处理的是代码(Python 子集),但它不用"人工挑一批好代码"当正例,而是写一个 prompt 来定义"教育价值":“determine its educational value for a student whose goal is to learn basic coding concepts”(判断这段代码对一个想学基础编程概念的学生是否有教育价值)。然后用 GPT-4 拿这个 prompt 去标注 R 的 100K 子集,标为正的就成了 target T。
接下来这一步是把"昂贵标注"蒸馏成"廉价打分":在 T 上训练一个随机森林分类器,特征是预训练 codegen 模型的输出 embedding(Percy 补了一句:其实用 fastText 大概也行)。然后从 R 里挑被这个分类器判为正的数据。
效果在 HumanEval 上很清楚:用 The Stack 的 Python 子集直接训一个 1.3B 模型,96K 步之后是 12.19%;用这套过滤出的子集训同样的 1.3B 模型,36K 步之后是 17.68%。不仅分数更高,到达分数所用的步数还只有三分之一多一点。 这是一个非常干净的"过滤即算力节省"的证明。
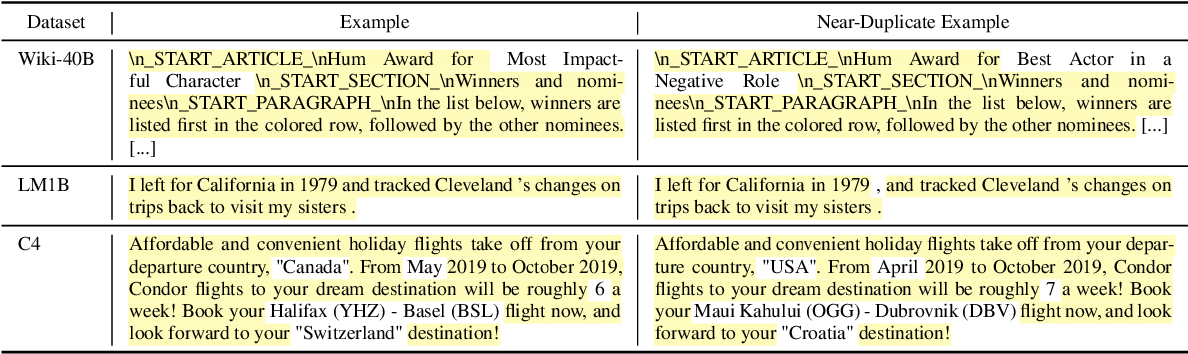
(这张表在后面讲去重时还会再出现——它列出三个数据集里的"近似重复"例子。Wiki-40B 是同一块模板文案换了奖项名;LM1B 是只差一个逗号;C4 那行最有意思:Affordable and convenient holiday flights... 这段话只有实体和数字被替换(加拿大→美国、5 月→4 月、6 次→7 次、哈利法克斯-巴塞尔→卡胡卢伊-杜布罗夫尼克),整段句子结构一模一样,是模板批量生成的典型。)
4.4 毒性过滤与 Jigsaw
毒性和质量是同一个机制:**Jigsaw Toxic Comments 数据集(2018)**来自一个"帮助人们在网上更好地讨论"的项目,数据是 Wikipedia 的讨论页(talk pages)——在争议话题上这些页面可以吵得很凶——标注了 {toxic, severe_toxic, obscene, threat, insult, identity_hate} 这些类别。同样可以定义正负例、训一个分类器、然后去 Common Crawl 上筛。
Percy 在这里做了小结:现在你手上有工具了。识别出你想要的那一类数据,为它训一个分类器,然后拿它去筛 Common Crawl。这就是这套东西的通用性所在——同一个骨架,换一个 target 定义,就换了一个用途。
5. 过滤的尺度依赖:没有最优阈值
5.1 一个反直觉的结论
接下来是整节最有深度的一点:你想让数据"长什么样",其实取决于你要训什么模型——具体地说,取决于你训多少 token。因此不存在最优的阈值。
Percy 拆解了直觉:分类器给你一个分数,但你不能说"0.9 就是最好的",因为这取决于你要拿它做什么。直观的规律是:如果你要训练很久,你能容忍更低质量的数据;如果你训练得短,那你就想要更高质量的数据。
然后他补了一句很关键的前提:如果给你一根魔杖,你训练更久当然想要更多高质量数据——但这不是你手上的选项。数据池是多大就是多大。 这个"约束下的取舍"正是整个问题的味道所在。
5.2 那张必须看懂的图
实证来自 Michael Ryan 做的一个初步实验。设定很小:一个 157M 参数的模型,一共只用 100 个 WARC(相对 Common Crawl 是极小的一撮),然后不断训练更久。
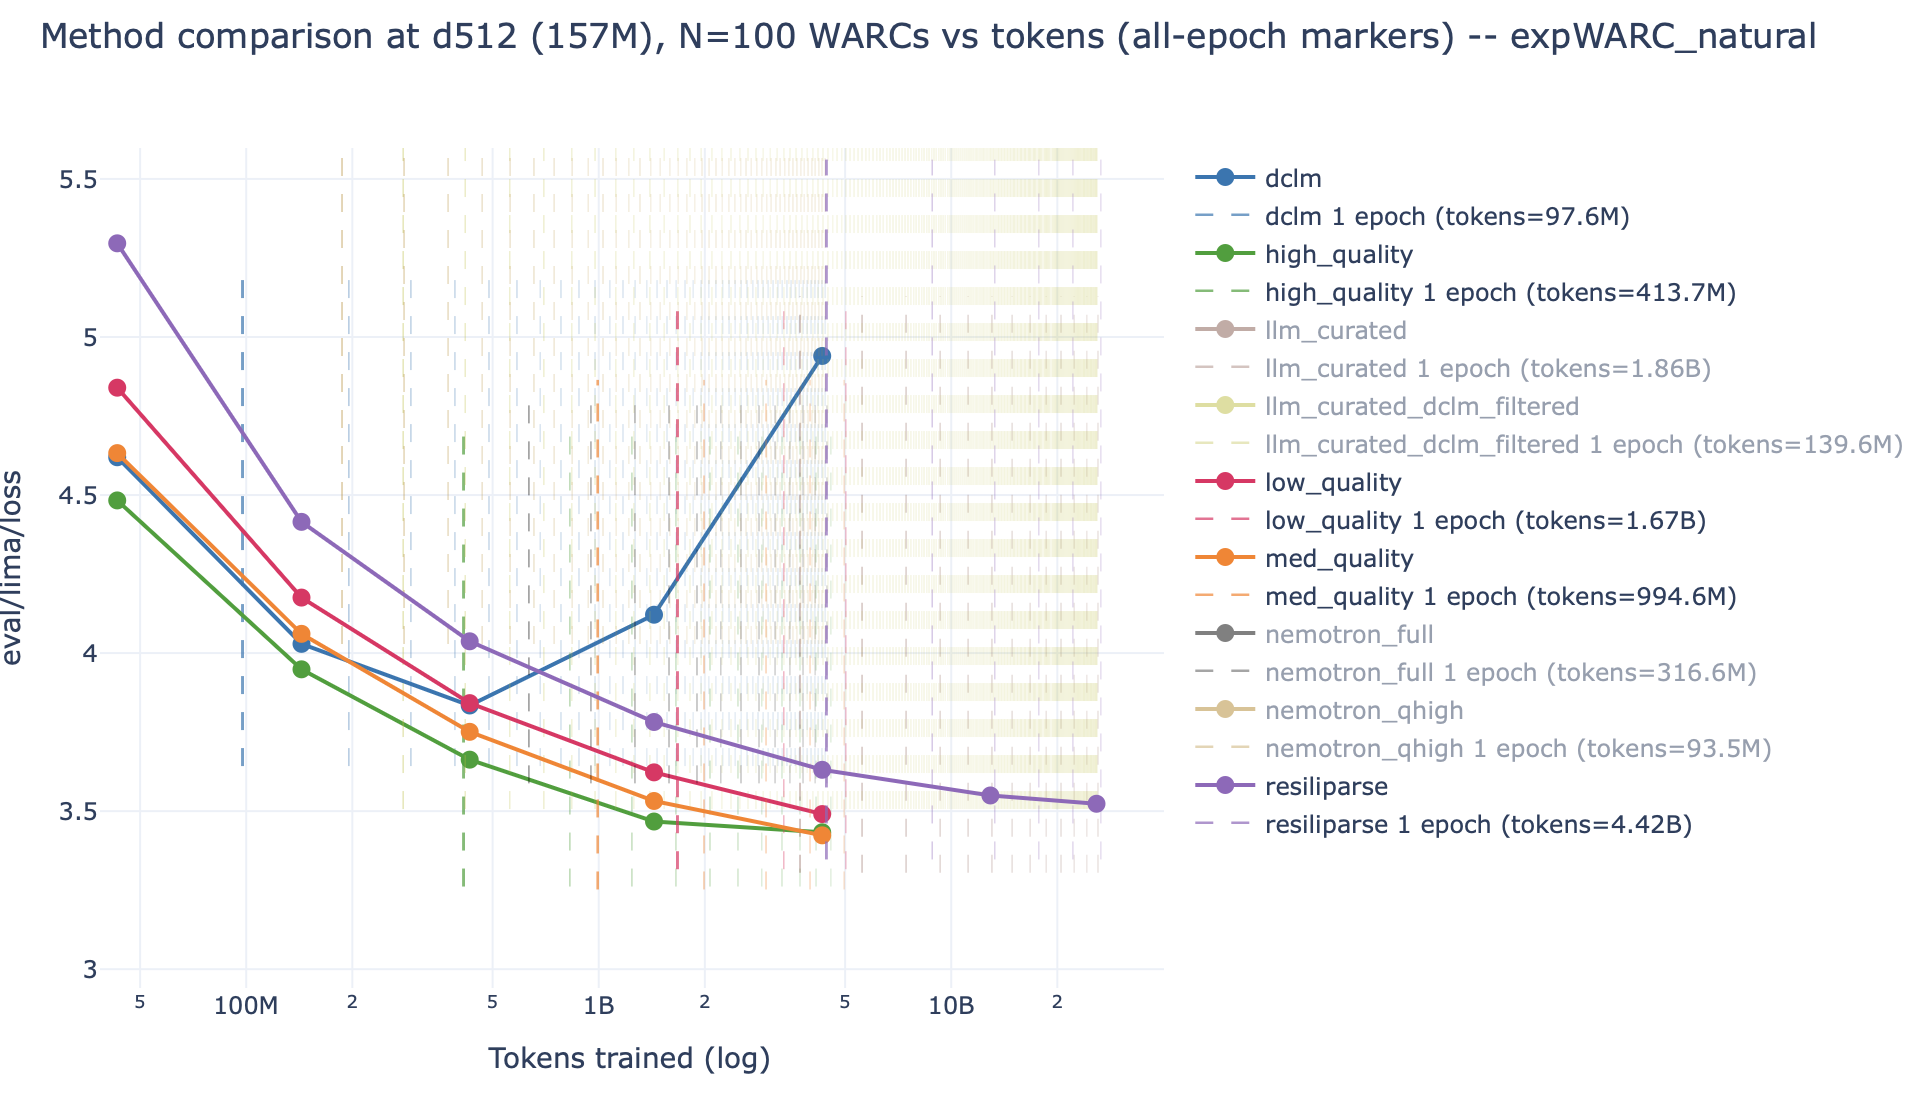
(讲义的这张图横轴是训练 token 数(对数),纵轴是 eval/lima/loss。图例里每一行都标着该数据源"一个 epoch 对应多少 token":dclm 97.6M、nemotron_qhigh 93.5M、llm_curated_dclm_filtered 139.6M、nemotron_full 316.6M、high_quality 413.7M、med_quality 994.6M、low_quality 1.67B、llm_curated 1.86B、resiliparse 4.42B。图中每一个"点"是一次独立的训练 run,同色的竖直虚线标出第 1、2、3……个 epoch 的位置。这张图的全部信息都在"虚线密度"里——像 high_quality(413.7M/epoch)这种,虚线挤在一起,说明很快就开始重复看同一批数据了。)
Percy 带读的是两条曲线。蓝线是 dclm(过滤最狠,一个 epoch 只有 97.6M token):loss 起点不高,一路下降,每一条竖线就是一次 epoch——这是第一个 epoch,第二条蓝线是第二个,以此类推。因为数据量太小,你迟早要重复数据,而且有趣的是 loss 还在继续降,因为第二次看同一批数据你仍然在学东西。但到了某个点就开始过拟合了。
再看 resiliparse(紫线,4.42B/epoch,Percy 说它"基本等于不做过滤"):开局很差,但它能撑得久——一直到很后面才开始 epoch,然后才放缓。
于是他抽出这条曲线族的形状:在"还没开始 epoch"这个区间里,高质量数据明显更好;但一旦训练 token 数变得很大,高质量数据的优势就消失了。而高质量数据的正确用法本来就是在过拟合之前停下来(图上就是"停在左边"),可是——Percy 强调了这个转折——即使停在那个点,它仍然比"用低质量数据多训一会儿"要差。
这就是这个图最有价值的结论:高质量数据不是无条件更好,它是在某个 token 区间里更好。
5.3 两轮课堂问答
问答一:每个点一次训练 run,要不要做置信区间?
学生注意到"图上每一个点对应一次独立训练 run",问做这类重训实验时是否需要重复多次、给出置信区间,还是一次就够。
Percy:理想情况下那会是好的实践。但你在论文里经常看到这类实验的重复次数很少,因为每一次训练 run 都相当昂贵。 不过他也给了实证安慰:在我们实际做过的这些实验里,结果总的来说是稳定的(tends to be stable),至少对 pre-training 而言是这样。
问答二:如果既有更高质量数据、又训练更久,还会有边际递减吗?
学生追问:是否考虑"更长训练"和"更高质量数据"的组合?如果拿高质量数据训得更久,会出现边际递减(diminishing returns)吗?
Percy 的回答干净利落:任何数据集最终都会有边际递减,因为它是有限的。 但它大概会落在图上的"更下面那条线",然后继续往下走——也就是说,更好的数据 + 更长的训练,确实把整条曲线往下推,但曲线本身的形状(收益递减)不会消失。
5.4 小结与配方
Percy 收束这一节:过滤对训一个好模型是关键的,尤其是在你算力受限的时候——而这适用于我们绝大多数人。他再一次说破那个反事实:如果你有无限算力,你不需要过滤,你可以训一切、训一个巨大的模型。但现实里每个人都要过滤。
他给的配方是三步:先弄清楚"好数据"长什么样 → 训一个分类器 → 让它外推到其余的数据。
而"好数据长什么样"有两个获得途径:一是"啊哈,外面有这么一个我特别喜欢的数据集,我想要更多类似的东西";二是"给语言模型写一个 prompt",用它先对一个大池子做初筛,再用筛出来的高质量数据去训一个小分类器,最后泛化到所有地方。第二条就是 phi-1 的套路,也是这套方法论最有杠杆的一步——用一次昂贵模型的调用,换一个可以无限次廉价调用的打分函数。
6. 去重:问题、动机与设计空间
6.1 重复比想象的常见得多
到这里数据已经过滤过了,剩下的都是"我们认为高质量"的东西。但里面通常还有大量重复。
重复分两类。**精确重复(exact duplicates)**的典型来源:镜像站(mirror sites)——镜像的存在意义就是复制,而爬虫往往不够聪明到认出"这个站就是那个站的镜像",于是同一份内容被抓了很多遍;还有 GitHub 的 fork——Percy 说 fork 也算重复,即使你改了一些东西,因为你大概只改了几个文件,99% 的仓库内容还是一模一样的。
近似重复(near duplicates)则是"同一段文字差几个 token",不来自镜像也不是派生关系。常见的几个来源:服务条款和许可证——MIT license 大概出现在无数地方,而且多数是逐字复制(除非有人手抖打错一个字符),但它所在的那个页面的其余部分各不相同;网站共用的页头和页脚,这跟上一节说的 boilerplate 是同一件事;以及纯粹的排版差异——比如 LM1B(一个 10 亿词量级的基准数据集) 里同一篇文章有两个版本,一个有逗号一个没有,Percy 说他也不知道为什么会这样,但事实就是会发生。
最极端的一类叫模板化写作(formulaic writing):有人把一段低质量的、看起来像广告的文案做成模板,然后把国家名从"Canada"替换成"USA"。如果你在这类数据上训练,模型其实只是在看同一段话的不同实体填充——这就是在白白浪费 GPU。
Percy 在这里给了一句贯穿全讲的建议:“这就是为什么去看你自己的数据很重要”(this is why it’s good to look at your data)。他随即抛出一个让人印象深刻的审计结果:C4 数据集的审计发现,某一条产品描述在数据集中出现了 61,036 次。 追下去会发现非常荒诞——那是一个亚马逊商品页(一幅涂鸦风格的防毒面具),而页面上那段描述写的却是婚礼设计的推销话术:
“by combining fantastic ideas, interesting arrangements, and follow the current trends in the field of that make you more inspired and give artistic touches. We’d be honored if you can apply some or all of these design in your wedding…”
(这段话本身语法就是坏的、模板拼错的产物。)它的结论只有一句:“So yeah, the web is weird."(互联网就是这么奇怪。)
6.2 为什么必须去重
第一层理由最清楚:训练效率。去重缩小了数据集规模,但几乎不损失信息——因为你拿掉的只是重复。第二层理由来自 **《Deduplicating Training Data Makes Language Models Better》**这篇论文:避免记忆(memorization)。如果某段受版权保护的内容在数据里被重复了很多次,模型就会把它背下来;隐私问题同理。但 Percy 说他自己的判断是:主要还是别浪费 FLOPs。
与去重紧密相关但可能更重要的是去污染(decontamination):你要确保测试集不在训练集里。 机制完全一样,只是比对的对象从"数据自己"换成了"评测集”。Percy 用的措辞是 “arguably even more important”——这是这门课对评测可信度一贯的立场。
6.3 设计的三个维度与那个核心挑战
去重的设计空间有三个决策点:
第一,item 是什么? 句子级、段落级,还是文档级?
第二,怎么算匹配? 精确匹配?存在共同的子项?还是共同子项的比例(这就是近似去重)?
第三,发现重复之后做什么? 全删,还是只保留一份?
然后是核心的算法挑战,也是这一整节要解决的技术问题:去重从根本上是在做"项与项之间的比较"。 这一点和过滤形成了鲜明的对比——过滤处理的是单个 item(“这个东西好不好”),所以它是线性时间、可以并行的,这也正是它能用规则或极小模型跑得飞快的原因。但去重明显不能做 n² 的"两两比较",在 web 这个尺度上你必须找到线性时间的算法。
Percy 说:去重文献里用的是 hash 函数来绕过这个问题,而且这些想法"相当漂亮,得感谢算法社区"。接下来的一长段其实是从零推导一套经典算法——这是本讲技术密度最高的部分,也是最值得完整记住的部分。
7. 从 hash 到 Jaccard 到 MinHash
7.1 Hash 函数:这次我们要的是"可控的碰撞"
Hash 函数大家都熟:把一个值(比如字符串)映射成另一个值(字符串或整数),hash 值远小于原 item。Hash 碰撞就是 x ≠ y 但 h(x) = h(y)。
这里有一个必须做的取舍,Percy 把它讲得很清楚:加密学 hash(如 SHA-256)是抗碰撞的,但慢——它用在比特币这类场景;DJB2、MurmurHash、CityHash 这些不抗碰撞,但快,用在哈希表里。我们去重用的是后者——讲义里直接 mmh3.hash("hello"),也就是 MurmurHash。
为什么"不抗碰撞"在这里不是缺点?因为下一节会揭示:在去重里,碰撞恰恰是我们要的东西,只是我们要的是"被控制住的碰撞"。
7.2 精确去重:简单、清晰,而且顺带是可并行的
精确去重的三个设计维度取值都很直白:item = 字符串,匹配 = 精确匹配,动作 = 只保留一份。 实现上是:把所有 item 按 hash 值排序、分组(itertools.groupby),每组只留第一个。优点很清楚:简单、语义明确、精度高;缺点是它处理不了近似重复。
Percy 在这里点了一个容易被忽视的工程细节:这段代码是刻意写成 MapReduce 风格的,因此很容易并行化和扩展。 讲义原文的点评是"can easily parallelize and scale"。在一个要处理上百 TB 数据的场景里,这段代码的形状本身就是设计的一部分。
然后是 C4(出自 T5 论文)的做法,它和整个去重章节里最值得回味的一个"设计缺陷"绑在一起:C4 的 item 是三句话的跨度(3-sentence spans),匹配用精确匹配,动作是只保留一份。
讲义里写明了这个定义的后果,措辞是 “Warning”:当一个三句跨度从文档中间被删掉时,剩下的文档可能就不连贯了。 Percy 在讲这个的时候特意停下来让听众体会这个逻辑的怪异之处——你找的是两个文档里相同的三句片段,然后你把其中一份删掉,也就是"从文档里抠掉三句话",这显然会破坏连贯性。但 C4 就是这么做的。
这是一个很好的例子:很多被广泛使用的数据集里,存在着"知道有问题、但当时就这么定了"的设计决定。理解这些决定,比记住数据集的名字更有用。
7.3 Jaccard 相似度:给"近似匹配"下一个定义
要做近似去重,先得定义"近似匹配"是什么意思,于是引入 Jaccard 相似度:两个集合的交集大小除以并集大小。
讲义用的是最小的可验算例子:A = {1, 2, 3, 4},B = {1, 2, 3, 5}。交集是 {1, 2, 3},大小 3;并集是 {1, 2, 3, 4, 5},大小 5;所以 Jaccard = 0.6。
Jaccard 的取值在 0 到 1 之间:0 表示完全不相交,1 表示完全相同。于是**“两份文档是近似重复"就被定义为"它们的 Jaccard 相似度超过某个阈值”**——比如 0.99。
问题随之变成:怎么在线性时间里找到近似重复? Percy 说这是"一个已经解决的算法问题",答案是先用 MinHash——但他立刻补了一句:"这不(是最终答案)"。因为 MinHash 只是第一步,LSH 才是完整的解。
7.4 MinHash:让碰撞概率等于相似度
MinHash 的定义只有一行:一个随机 hash 函数 h,使得 Pr[h(A) = h(B)] = Jaccard(A, B)。
Percy 强调了这个性质的"反常"之处,而且把它讲成这节课里最有数学美感的一段:
正常情况下,你设计 hash 函数是为了让不同的元素 hash 到不同的值——你不想要碰撞。但在这里,你恰恰想要碰撞;不是任意的碰撞,而是要让碰撞概率与相似度对齐——相似的东西应该比不相似的东西碰撞得更多。
实现上,MinHash 极其朴素:
def minhash(S: set[str], seed: int):
    return min(mmh3.hash(x, seed) for x in S)
把一个集合里的每个元素都 hash 一遍,取最小值。 Percy 预判了"第一次看到会觉得很奇怪"的反应,并给了两个提醒:你取最大值也行,其实无所谓——它只是用来打破平局的一种方式。
然后是那个漂亮的证明,用**特征矩阵(characteristic matrix)**来讲:
item | A | B
1    | 1 | 1
2    | 1 | 1
3    | 1 | 1
4    | 1 | 0
5    | 0 | 1
随机 hash 函数本质上是在这些元素上诱导出一个随机排列(permutation)。 在这个排列下问:“A 里排第一的是哪个元素?B 里排第一的是哪个?”
关键在于:每个元素成为"第一个"的概率是均等的。于是分类讨论就完了——如果排第一的是 1、2 或 3(这三个同时在 A 和 B 里),那么 A 的第一个等于 B 的第一个;如果排第一的是 4 或 5(这两个只在一边),那么 A 的第一个就不等于 B 的第一个。
Percy 把这个图像总结成三句话:随机 hash 函数做的事是"选一行排到最前面";而"min(A) 是否等于 min(B)“回答的问题就是"那一行是不是两边都有”。 这正好就是"交集 / 并集"的抽样估计——所以碰撞概率精确等于 Jaccard,是在随机选择 hash 函数的期望意义上成立的。
讲义随即用代码验证了这个性质:生成 100 个不同的 hash 函数(每个由一个 seed 给定),检查两个集合的 MinHash 是否相等,数相等者的比例——得到 0.6,和手算的 Jaccard 一致(讲义里甚至有 assert abs(estimated_jaccard - jaccard) < 0.01)。
而 MinHash 真正解决问题的地方在这里:Percy 说"关键点是,我不用去做 n² 的比较。我可以算 A 的 MinHash、B 的 MinHash、另一个集合的 MinHash,然后只去找碰撞。" 这就是从 O(n²) 到线性的那一步。
不过 Percy 马上泼了盆冷水:“现在我们可以给 item 做 hash 了,但我们还没做完。因为一次碰撞并不能告诉你 Jaccard 超过某个阈值——而那才是我们真正想要的。” 我们要的是"找出所有 Jaccard > 0.99 的 A 和 B",而现在只知道"如果碰撞了,那么碰撞概率等于 Jaccard"。这个信息本身不好用:它是随机的,你无法从中得到可靠结论。
于是他转向下一件工具:locality-sensitive hashing。
(Percy 在这里停下来问了一句 “Any questions so far about MinHash?"——没人提问,他直接往下讲。本节还有 “Any questions about LSH?” 和 “Questions about dedupe?” 两处同样的停顿,也都没有引出实质提问。这些是讲者例行的确认,不是问答轮次。)
8. LSH:把随机的概率"锐化"成相变
8.1 问题的本质是想办法"锐化”
Percy 把问题重新表述了一遍:A 和 B 以等于 Jaccard 的概率碰撞,这确实意味着"越相似的东西碰撞得越多",但这个方差非常大、非常随机。我们的目标是"当且仅当 Jaccard 超过阈值时 A 和 B 碰撞"。所以我们必须以某种方式把这些概率锐化(sharpen)——概率不能就是字面等于 Jaccard。
解法是用更多的 hash 函数,而且这些 hash 函数必须互相独立。从这里开始 Percy 说"这部分技术上有点绕,但我们一步步走",然后就给出了那个著名的结构:
把 n 个 hash 函数切成 b 个 band(带),每个 band 里有 r 个 hash 函数(n = b * r)。讲义用最小例子画出来:n = 12,b = 3,r = 4,于是表示为
h1 h2 h3 h4 | h5 h6 h7 h8 | h9 h10 h11 h12碰撞的定义是:只要存在某个 band,它的所有 hash 函数都返回相同的值,我们就说 A 和 B 碰撞。 Percy 把这句话拆开强调了:“你不需要所有 hash 函数都一致”——只要 band 内部全一致就行,任何一个 band 触发就算碰撞。讲义把这种结构命名为 and-or 结构(the and-or structure):band 内部是 AND(全都要一致),band 之间是 OR(任意一个触发即可)——而正是这个 and-or 结构在"做那个锐化的工作"。
8.2 公式与两个方向的调节旋钮
于是可以算概率了。给定 Jaccard 相似度,A 和 B 碰撞的概率是:
def get_prob_collision(sim, b, r):
    prob_match = sim ** r                        # 一个固定 band 匹配的概率
    prob_collision = 1 - (1 - prob_match) ** b   # 某个 band 匹配的概率
return prob_collision读法:一个固定 band 匹配的概率是 sim^r——因为 band 里 r 个 hash 函数全都要一致,每个一致的概率是 sim,独立相乘。Percy 说这个值"通常很低,它对 r 是指数级的"。 然后是**“某个 band 匹配"的概率 = 1 减去"所有 band 都不匹配"的概率 = 1 - (1 - sim^r)^b**。
讲义给的第一个例子:sim = 0.8,b = 5,r = 10,得到碰撞概率 0.4。 Percy 提示说"这比你可能预期的要高,因为你给了 b 次尝试匹配的机会”。
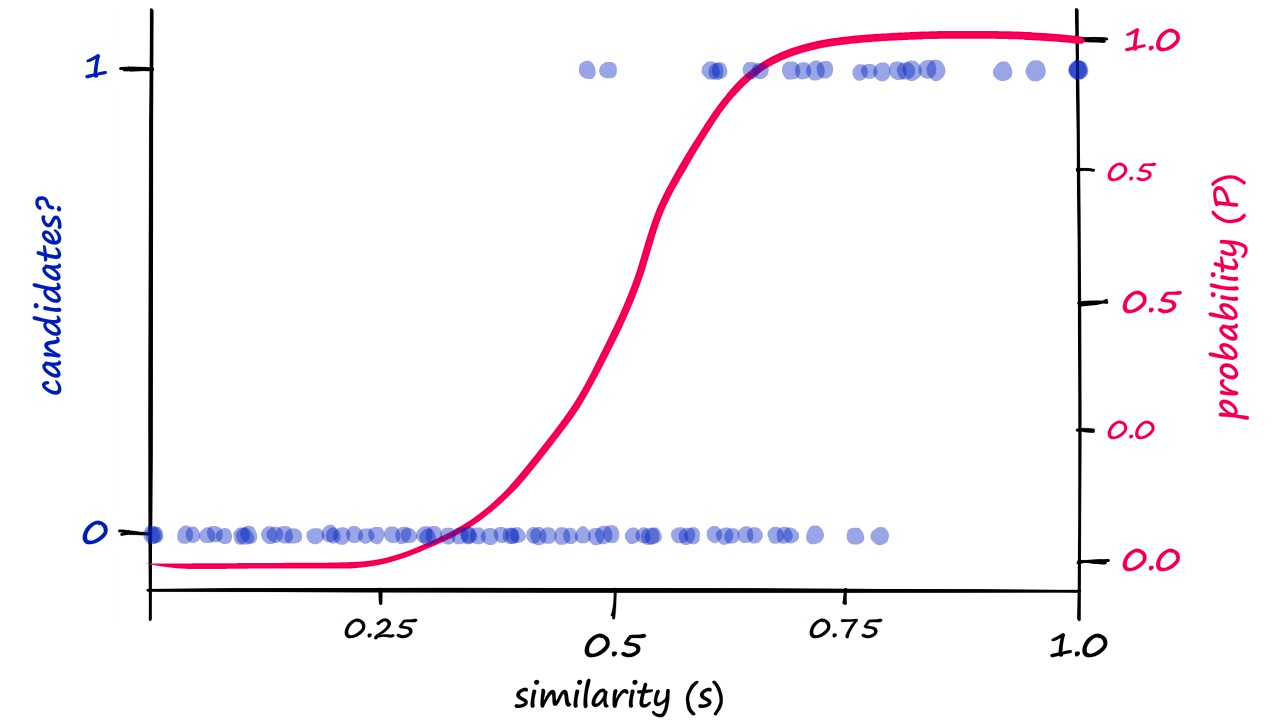
(这张手绘风格的图是"候选对"这个概念的可视化:左轴是二值的 candidates?(0/1),横轴是 similarity (s),蓝色点沿着 0 和 1 两条水平线分布——低相似度的点几乎都落在 0,高相似度的点几乎都落在 1——而那条洋红色的 S 形曲线是拟合出的概率 P。它想传达的是:“是否碰撞"这件事本身是二值的、带噪声的,但它的概率随相似度单调上升,这正是 LSH 要做成"阈值函数"的前提。)
把 P = 1 - (1 - s^r)^b 对相似度画出来,就得到那条著名的 S 曲线。Percy 带读它的边界条件:相似度是 0 时概率应该是 0,是 1 时概率应该是 1。 而中间那段S 形恰好就是我们要的锐化:相似度低于某个阈值时,我们希望匹配概率尽可能低;高于阈值时,我们希望它尽可能高——我们想让它表现得像一个相变(phase transition)。
然后是两个调节旋钮的作用,这是这一节最实用的部分:
增大 r(每个 band 里的 hash 函数数):阈值变得更陡,并且整条曲线右移——“更难匹配了”。 因为 band 内部要一致的东西变多了,那个指数被强化了。他取的观察窗是 sim 从 0.7 到 0.98 这一段(0.7、0.75、0.8、0.85、0.9、0.95、0.98),先看 b = 10, r = 10:碰撞概率从 0.25 一路到 1。Percy 对这个区间的评价是"如果拿它当阈值,还不算太差”——阈值以下仍然会有 false positive(比如说 0.9 以下的东西也可能碰撞),但如果愿意还可以再筛一遍;而阈值以上的基本都被留下了。
然后是增大 r 的效果(b = 10, r 从 10 提到 20):sim = 0.7 处的碰撞概率从 0.25 降到 0.008——这就是"锐化"的量化体现。
增大 b(band 的数量):曲线左移——“更容易匹配了”。 因为 band 越多,“有些 band 能匹配"的机会就越多。数字上:sim = 0.9 处的碰撞概率从 0.72 升到 0.92。Percy 顺手补了一句:这同时也会抬高低相似度那一端的概率,但抬升幅度没那么大——也就是说 b 主要是在平移相变的位置,而不是破坏它的陡峭度。
他的总结是:你可以通过增大 b 和 r 把相变做到任意尖锐——但代价是计算更贵。
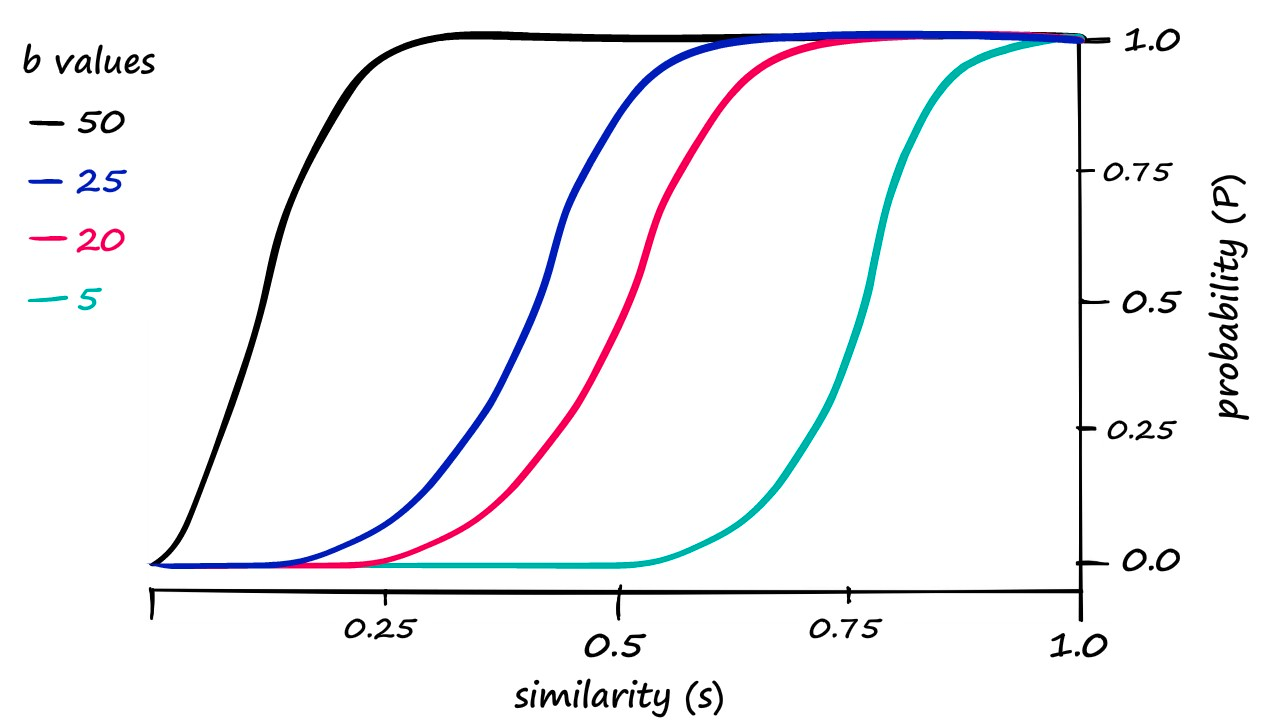
(这张图把 b 取 50 / 25 / 20 / 5 四条曲线画在一起,横轴是 similarity (s),纵轴是 probability (P)。注意 b 越大曲线越靠左越陡——b=50 时 0.5 概率出现在相似度约 0.15 附近,b=5 时要到 0.8 附近才到 0.5。这张图是"b 是位置旋钮"这个结论最直观的证据。讲义里 r 没在图上标出,仅作对照。)
8.3 真实世界的参数:n=9000, b=20, r=450
Percy 把之前那个玩具例子换成真实设定,出自《Deduplicating Training Data Makes Language Models Better》这篇论文:
n = 9000(总共 9000 个 hash 函数),b = 20 个 band,每个 band r = 450 个 hash 函数。
他让学生体会这个量级——450 个 hash 函数在一个 band 里,这跟前面 r = 4 的玩具例子完全不是一个尺度。然后给出两个可以直接拿来用的结论:
第一,相变发生的阈值是 (1/b)^(1/r)。 讲义里直接写成 threshold = (1 / b) ** (1 / r)。它的用法是反推:如果你只想保留 Jaccard 大于 0.9 的重复,那你就设置 b 和 r 让这个式子等于 0.9;然后通过调整 b 和 r,你可以让这个相变变得更陡。 也就是说,相变的位置和相变的陡峭度是两个可以独立调的量——位置上 (1/b)^(1/r),陡峭度靠把 b 和 r 一起推大。
第二,如果你正好站在这个阈值上,那么碰撞概率是一个常数,约等于 1 - 1/e,也就是 0.64。 讲义的推理链是这样的:在阈值处,一个固定 band 匹配的概率恰好是 1/b(这是阈值定义的直接推论),于是碰撞概率是 1 - (1 - 1/b)^b——而这个式子在 b 增大时收敛到 1 - 1/e。
Percy 对这个 0.64 的解读是整节最漂亮的一句:“如果你有一个相变,那么这个相变的中心就是 0.64。而随着 b 和 r 增大,它下面的一切都趋向 0,它上面的一切都趋向 1。”
这句话的分量在于它承认了 LSH 的一个内在极限:相变中心那个点上的概率永远是 0.64,不会更高——你没法做到"阈值以下一定不匹配、阈值以上一定匹配”。你只能把两侧压平。在阈值附近,永远有一片模糊地带,需要额外的精确比对来消解(这也是 Percy 前面说"这些是 false positive,但如果愿意我们还可以再筛一遍"的意思)。
8.4 命名、去污染,以及"跨数据集去重"
Percy 收尾时做了两处澄清:
为什么叫 MinHash LSH? 因为 LSH 本身对任何 hash 函数都成立,它只是一个把 hash 组合成 band 的通用构造。在语言模型数据的去重里,我们用的那个 hash 函数是 MinHash(因为它近似 Jaccard),所以完整名字是 MinHash LSH。这个区分很重要——不要把 LSH 和 MinHash 混成一件事,前者是锐化机制,后者是相似度估计器。
去重的对象范围:Percy 说了一个实践建议——数据往往是一份一份来的,去重有时候只在一份数据集内部做。但你应该在整个数据集上做跨数据集去重,因为不同数据集之间经常是冗余的。 他的措辞是**“有时候这没被做,但它应该被做”(sometimes that’s not done, but it should be)**。
9. 数据混合:问题的形状与三种"凭感觉"的基线
9.1 问题是怎么冒出来的
Percy 先回望整条流水线:到这里,我们已经把原始的 HTML 或 PDF 变成了文本,过滤出高质量的,去掉了重复,得到一份更小的高质量文档集合——而这件事是针对某一个数据源做的。 但语言模型是在多个数据源上训练的。
他给了一个现实的参照:在 Marin 这个项目里,有一张网页实时追踪下一个模型将要用到的所有数据源。
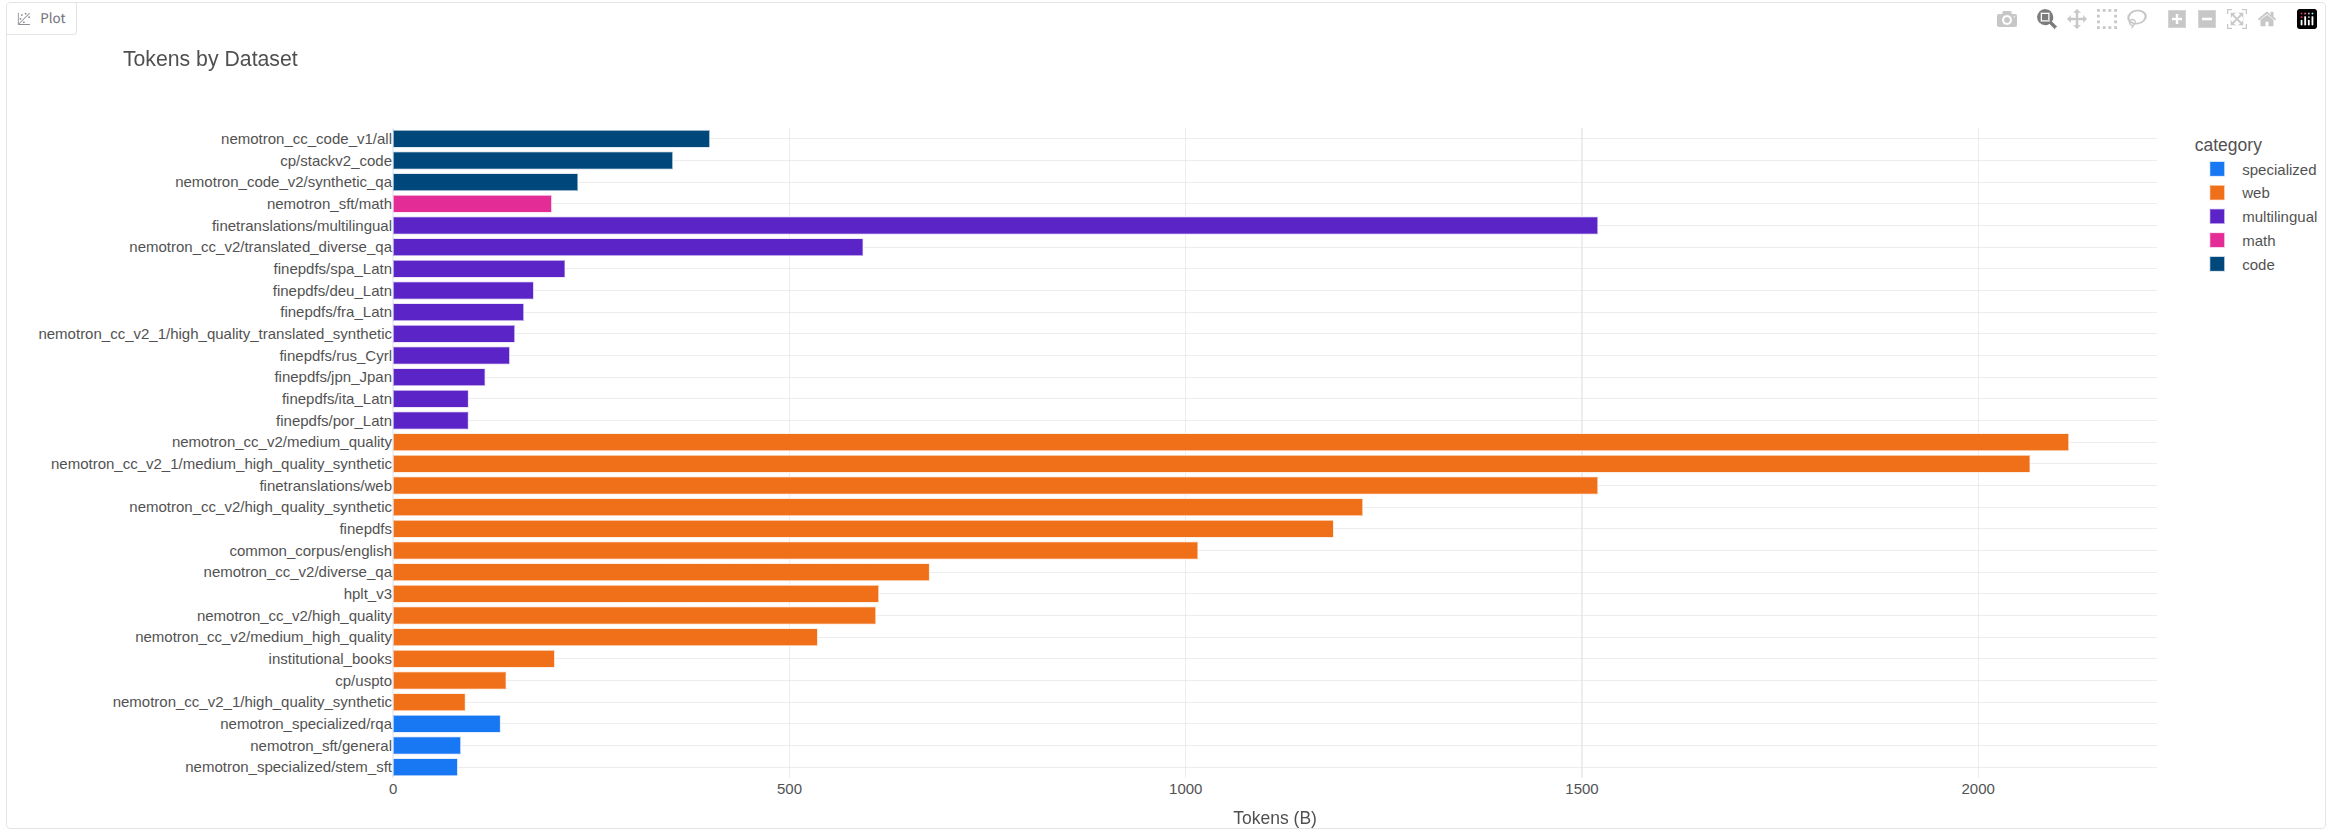
(这张截图是 Marin 社区的 token-count-viewer,横轴是 token 数(单位 B,十亿),纵轴是各个数据集,按 category 分组着色:web(橙,最大的一类,nemotron_cc_v2/medium_quality 一根棒就超过 2000B)、multilingual(紫,finetranslations/multilingual 约 1500B 一枝独秀)、code(深蓝)、math(粉)、specialized(亮蓝)。另一类可见的东西是 FinePDFs 的多语种分片(finepdfs/spa_Latn、deu_Latn、fra_Latn、rus_Cyrl、jpn_Jpan…)——正好把上一节的 PDF 内容接了上来。这张图的作用是让"数据源有多少个、体量差多少"变成可看见的事。)
于是他提出核心问题:你手上有一堆不同的来源,怎么把它们组合起来?
参照系是更早的 The Pile(2020):
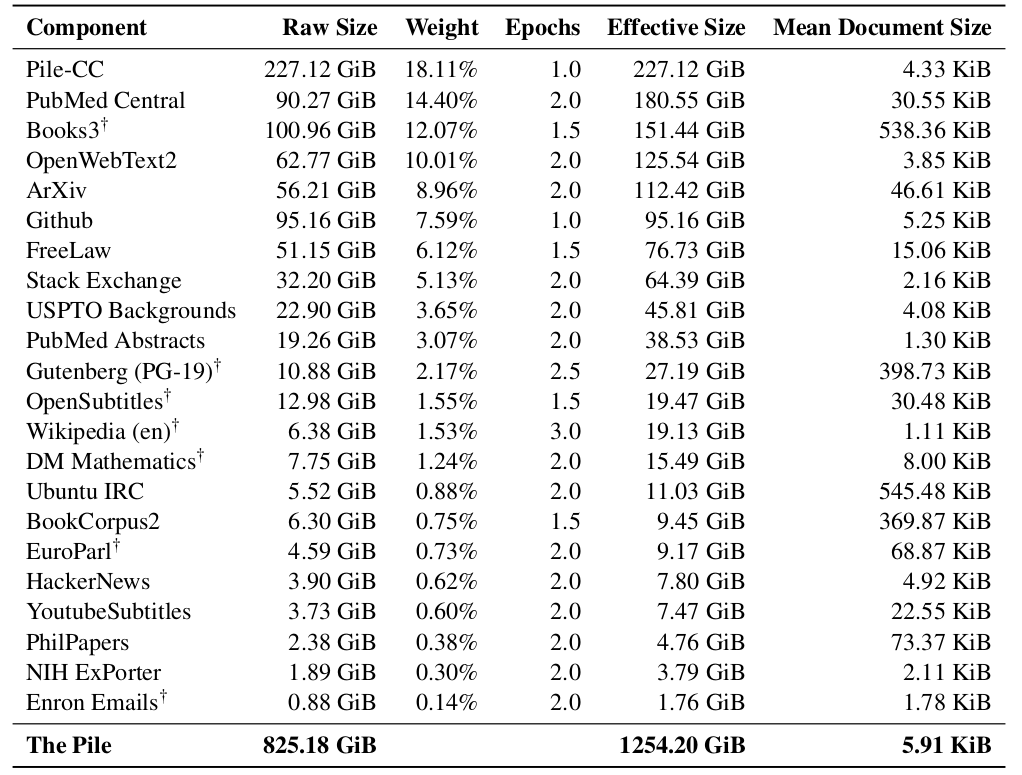
(The Pile 的做法是给每个成分直接指定一个权重,本质上就是在数据源上定义一个分布。这张饼图/条形图列表展示了当时的 22 个领域构成——从 Pile-CC、PubMed、arXiv、GitHub、FreeLaw 到 Books3、Gutenberg、OpenWebText2 等等,每个都带一个权重和 token 数。它是"手调权重"这条路线的历史标本。)
讲义用一个最小的例子说明什么叫"一个 data mixture":三个来源 {Wikipedia, CC, GitHub},配一组概率 {"Wikipedia": 0.3, "CC": 0.5, "GitHub": 0.2}——data mixture 就是数据源上的一个分布。
9.2 三种基线
第一种:vibes(凭感觉)。 根据直觉手工设定权重。Percy 说得很直白:这比你想象的要常见得多,而且即使在更新的论文里,也常见到"用某个方法得到结果之后再手工微调"的做法。他把 vibes 形容为"first principle 的反面",但毫不掩饰它在这行的现实地位。
第二种:均匀采样(uniform)。 在数据源上放一个均匀分布,每一块(chunk)采样的来源按等概率抽。
第三种:按比例混合(proportional mixing)。 按每个来源的 token 数加权,数据量大的来源权重高。Percy 说这通常也是一个理性的做法。
但按比例混合有个让人不安的地方:如果你有一个巨大但低质量的数据集,它会吃掉你大量的 token,这显然不是最优的。
9.3 两条必须记住的约束
直觉上你会想"那就给高质量来源更高权重"。Percy 说可以,但有两件事必须先记住:
第一,你要保证多样性。 他给的理由很有意思:很多来源之间是不可比的(incomparable)——文学、代码、论文,你没法说"这篇论文比这段代码质量更高",因为它们是不同种类的东西。而且如果你想让模型各方面都行,你就不能把全部质量都压在论文上。
第二,每个来源都是有限的(finite)。 这一点 Percy 说要展开讲,因为**“如果你给一个小来源太多权重,你就会把它用光,然后你必须去 epoch 它——也就是反复训练字面上同一批 token”**,而这会带来问题。
10. 那个 50 倍 epoch 的例子
10.1 从数字上看清楚
Percy 用两个来源把"有限性"这件事讲透:一个低质量来源有 10T(10 万亿)token,一个高质量来源只有 10B(100 亿)token。他先给了个一般性的观察:高质量来源通常就是更小的。
然后做一个最朴素的混合:uniform,高低各一半,总共训练 1T token。他在这里特意澄清了一句容易混淆的话:“训练 1T token 并不意味着有 1T 个不重复的 token,它只意味着训练步数乘以 batch size 大致等于这个数”——也就是模型总共看了多少 token,重复的也算。
于是可以算出每个数据点被训练了多少遍(epoch 数):
- 低质量来源:
(0.5 × 1T) / 10T = 0.05——也就是低质量数据里只有 5% 的 token 我会碰到、并且只训一遍。 - 高质量来源:
(0.5 × 1T) / 10B = 50——Percy 把这一步的中间量也说了出来:一半一半意味着我需要向高质量来源索取 5000 亿(500B)token,但我手里只有 100 亿,所以高质量数据的每个数据点要被重复训练 50 遍。
Percy 的评论是:“这其实非常重要。有些大模型训练在这个点上栽过跟头。” 教训是:你不能只看数据的"质量"就定义一个分布然后采样——你漏掉了"一共有多少个数据点"这个维度。 讲义里那句终结性的话是:50x epochs on high quality data… can lead to overfitting!
10.2 问答:为什么需要 50 个 epoch?
学生问的是:对高质量数据,为什么要 50 个 epoch?难道不是少得多的步数就能达到可比的性能吗?
Percy 的回答揭示了这个例子真正想说什么:“你说得对——你不需要 50 个 epoch。最好情况是你在浪费算力,最坏情况是你在过拟合。” 那为什么会出现 50?因为如果你就这么进去、定义了这个数据混合,你就会不知不觉地做 50 遍——除非你非常仔细地盯着。 所以这一节的教训不是"该怎么设 epoch 数",而是:去看你实际上对数据做了多少个 epoch(look at how many epochs you’re actually doing on your data)。
这是一个"错误的发生机制"而非"错误的后果"的例子——因为后果(浪费算力或过拟合)是大家都知道的,真正需要防的是它在你不注意的时候自动发生。
10.3 问答:混合在训练时到底是怎么实现的?
学生追问的是实现细节:mixed 里那些成分在训练时怎么体现?是每一步都切换吗?比如"我要 10 份 Python 代码、10 份散文"这样?这中间有什么直觉?
Percy:一般来说就是采样。你要填满一个 batch,那么你就对每个位置采出它来自哪个 mixture component,然后用那个成分的序列把 batch 填满。通常每条序列来自一个 mixture component——你不是在 token 级别上采样。所以每个 batch 都应该是混合的。
他进一步解释了为什么要这样:mixture 的假设是在 batch 层面成立的。如果一整步里全是同一类数据,那就不对了——你希望降低方差,所以一个 batch 里应该有混合。
这段问答澄清了一个非常实际、但在论文里常常不写明的实现细节:混合的粒度是"序列 / batch",不是"step",也不是"token"。
11. 从 UniMax 到回归式混合
11.1 UniMax:给 epoch 数加一个硬上限
Percy 说这个问题很早就被注意到了。UniMax 这篇论文的场景是多语言模型——在那里问题的形态最清楚:有些语言是极低资源(very low-resource)的,你必须为此做点什么。
论文的观察是:之前的工作会拿 proportional mixing 的结果取一个幂来把分布压平(p(s) ∝ num_tokens(s)^α,α 在 0 到 1 之间)。UniMax 的想法是把这个做法显式化:均匀地采样各个来源,但对任何来源的 epoch 数加一个硬上限(hard cap)C。
约束写成一行就是:对所有来源 s,p(s) * num_training_tokens ≤ C。
讲义的措辞很形象:“如果你已经用满了这个上限,那就抱歉了,你拿不到更多 token——你换下一个。” Percy 说这是**“某种意义上的安全网”(like a safety net in some sense)**。而且关键在于:在这个约束下确定 mixture 有一个简单的流程(讲义提到有 “a simple procedure for actually determining the mixture subject to this constraint”),不是一个需要解大优化问题的事情。
11.2 回归式混合:用一堆小模型反推大模型的配方
Percy 说接下来要换个角度:mixture 应该怎么定? 如果你有 50 个来源,那你就要填 50 个数字。按比例混合显然不够,也许你可以估一个质量指标、然后按它采样——但那同样是启发式的。
最有原则、也最容易搞清在做什么的,是回归式混合(regression-based mixing)这一类方法,代表是 RegMix 和 Olmix。 它的想法极其简单,Percy 说和 scaling law 有相似的形状——都是用便宜的实验算出答案,然后再放大。
具体四步:
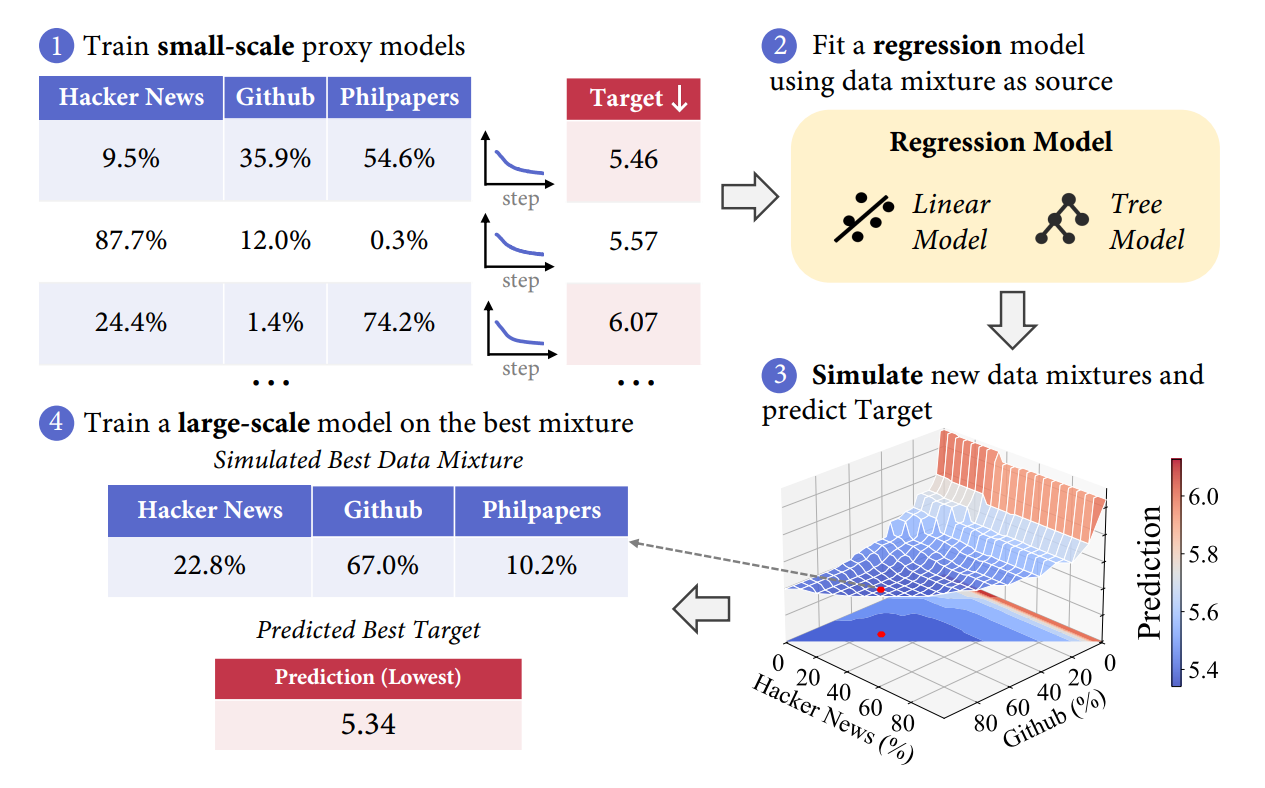
(这张图正是 RegMix 论文里的方法示意,四步分别是 1 训练小规模 proxy 模型(图中三列是 Hacker News / Github / Philpapers 三个来源,各自训一条 loss 曲线,Target 要最小化);2 用数据混合作为输入拟合一个回归模型(图里画了 Linear Model 和 Tree Model 两种候选);3 模拟新的数据混合并预测 Target(一个三维曲面:横轴 HN%、纵轴 GitHub%、色标是 Prediction,5.4 到 6.0);4 在大规模上用最好的配比训练。最有说服力的细节是数字对比:第 1 步里 proxy 实验做到的最好目标是 5.46(配比 9.5% HN / 35.9% GH / 54.6% PP),而拟合后的曲面在搜索到的最优点上预测出 5.34,对应配比是 22.8% HN / 67.0% GH / 10.2% PP——回归模型"想象"出了一个比任何实际跑过的实验都更好的点。这正是这个方法的价值所在。)
(顺带一个值得注意的方法论细节:曲面只在 HN% 和 GitHub% 两个轴上画,因为第三个数被"三者加起来等于 100%“约束掉了——回归模型的输入其实只需要 m-1 个自由度。)
讲义把"小尺度"具体化了:他举的规模是 300M 参数(“你跑到小尺度上去,比如说 300 million 参数,试各种不同的数据混合”),而且假设有三个成分,每个模型在某个 target 指标上给你一个 loss——可以是下游指标,也可以是 perplexity,随便你定义。
Percy 接着列了这条路线上的四个设计决策:
第一,要试哪些混合? 你需要一个"分布的分布”——大家常用 Dirichlet 分布。
第二,回归方法用什么? 线性模型或者梯度提升树(boosted decision trees)都有人试过,log-linear 一般效果不错。
第三,target 怎么定? 常常是基于下游评测。但那要非常小心。因为 pre-training 按说是在训一个通用模型,我们并不想让它去拟合某些下游评测。如果你不小心——比如你手上有一堆代码评测——那猜猜会发生什么?你会把所有代码数据都加了权重。这不是什么高深的道理。然后你再让它写首诗,你可能就会意识到你过拟合了。
第四,小尺度和大尺度差多远? 这是成本和精度的权衡:小模型太小学生可能不具代表性;要用大模型做这件事——那你还折腾什么,直接训就完了,你其实是在最大尺度上做超参搜索,太贵。
Percy 特别指出 proportional mixing 和 uniform mixing 没有这个问题,因为它们没有在"看"任何东西(there’s no downstream evals)——它们的"无知"反而是一种保护。这是一条很值得记住的经验:用评测驱动数据配比,天然带着过拟合评测的风险。
11.3 那张把所有方法横向排开的表
Olmix 这篇论文有一张很好用的对照表:
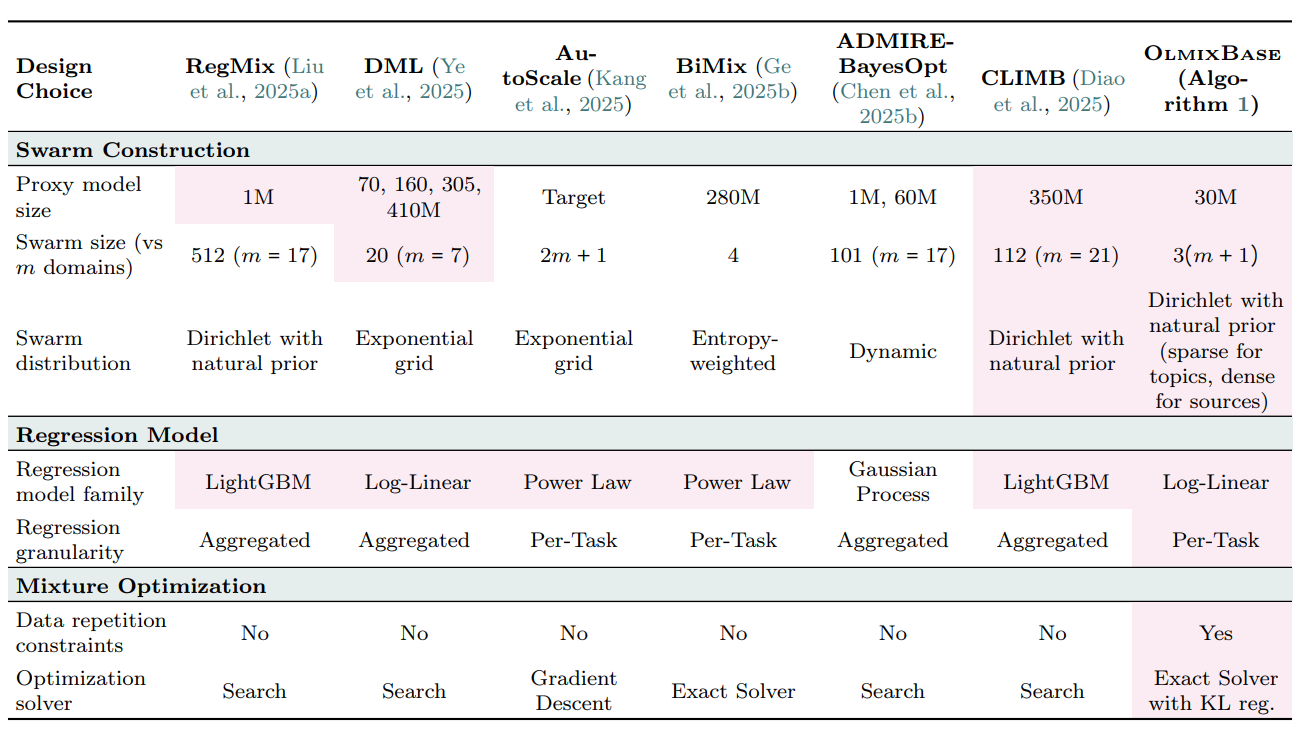
(这张表把 RegMix、DML、AutoScale、BiMix、ADMIRE-BayesOpt、CLIMB 和 Olmix 自己的 OLMIXBASE 放在一起,按三个维度对比:Swarm Construction(proxy 模型多大、swarm 多大、swarm 用什么分布)、Regression Model(回归模型族、回归粒度)、Mixture Optimization(有没有数据重复约束、用什么求解器)。几个能一眼看出来的数字:proxy 模型规模普遍在几十 M 到几百 M(1M、30M、70/160/305/410M、280M、350M 等);swarm 大小从 4 一路到 512(RegMix 的 512 对应 17 个领域,BiMix 只有 4,Olmix 是 3(m+1));分布上绝大多数用 Dirichlet 加一个自然先验;回归模型族在 LightGBM / Log-Linear / Power Law / 高斯过程之间分布;回归粒度分"聚合"和"逐任务"两档。最后一行是整个表最醒目的一格:“数据重复约束"这一列,只有 OLMIXBASE 是 Yes,其余六个全是 No。)
11.4 两个 leap of faith
Percy 把这条路线的风险讲得非常诚实。有两个"信念的跳跃”(two leaps of faith)是你必须非常小心的:
希望一:回归模型在那个最优点上仍然是准的。 这里的不对称在于:如果你随机采一个混合,你大概没问题——这是经典的泛化性,采样一个混合、拟合一个函数,在分布内应该能预测。但当你去"优化"的时候,你是在把模型推向可能是极端的区域,那里的覆盖可能不够。 换句话说,优化这个动作本身把你带离了训练数据 —— 这正是"优化"和"预测"的区别。
希望二:最优点能从大尺度迁移到小尺度……反过来说,从小尺度迁移到大尺度。 Percy 说:在开放社区工作上用的那些规模上,这看起来至少是成立的,或者至少没有被明确证伪(not plainly false)。但显然存在尺度依赖效应。
他马上把这条和前面过滤那一节接了起来:如果你要训练多得多的 token,那低质量数据大概就没关系了。所以最优点显然不是同一个——你只能寄希望于它足够接近。
11.5 那个已经出现过的尺度依赖效应,以及"模拟 epoch"
Percy 说:等一下,有一个我们已经讲过的尺度依赖效应必须在这里处理掉。
场景仍然是 10T 低质量 + 10B 高质量。如果你在很少的 token 上训小模型,会发生什么? Percy 说"这是个编出来的例子,但你可能会把大量权重压到高质量数据上"——因为在低 token 数下你根本还没开始 epoch,于是你会想:“哇,Wikipedia 太好了,我们就训 Wikipedia 吧。”
但如果你拿这个混合去训大模型,你就会在高质量数据上做大量 epoch,然后过拟合。那绝对很糟。
讲义给的示意配比是 {"low": 0.1, "high": 0.9}——小尺度下看起来最优的配比,在大尺度下是灾难。
解法一:上限(cap the number of epochs),也就是前面 Olmix 表格里那一格 Yes。
解法二:模拟 epoch(simulated epoching)。
模拟 epoch 的原则是:让你的小尺度看起来像你的大尺度。
Percy 特别点出这是一个贯穿整门课的一般性主题——我们讲 μP 的时候见过它:你重新参数化你的模型,好让超参能够迁移。这里的原理完全一样。
具体做法是:按比例把所有来源都下采样(downsample all sources proportionally)。 讲义的数字是:小 run 是 10B token,大 run 是 1T token,比值是 1/100。 然后把每个来源的可用 token 数都乘以这个 ratio,得到一个"下采样后的数据池"。
为什么这样能修好问题?Percy 的推理链是整节最精彩的一段:如果在这个下采样后的数据里,某些方案表现不好——那是因为你没有机会"只训 Wikipedia"了。你只能训 Wikipedia 里极小极小的一部分,然后你就会意识到"哦,我其实要做很多 epoch"——而那会带来非常糟的 loss。于是优化过程会自动去找更平衡的方案。
他的总结是:你是在低尺度上模拟(simulate)你在高尺度上会遇到的数据稀缺。
讲义里给出的对照配比很能说明问题:同样是小尺度实验,朴素做法下最优是 {"low": 0.1, "high": 0.9}(把 90% 权重压在高质量上),而模拟 epoch 之后是 {"low": 0.7, "high": 0.3}——差异巨大,而这正是"小尺度实验能不能预测大尺度结果"的关键。
11.6 本节小结
Percy 收束:问题是"怎么给不同来源加权"——Wikipedia、Common Crawl、代码、从某处爬来的数学数据,怎么平衡? 回归式混合是一个很好的思考框架:在小尺度上估计"混合权重 → loss"的函数形式,去优化它,然后泛化到大尺度。 但你必须非常小心 epoch 和过拟合问题,解法是要么 cap epoch,要么模拟 epoch。
他给出一句更普适的告诫:“如果你在试图优化任何东西,你都必须非常小心,因为你正处在’优化错东西’的危险之中”(you are in danger of optimizing the wrong thing)。 这句话把前面的**“用代码评测做 target 就会把所有代码数据加权重”和这里的“没模拟 epoch 就会选出一个必然过拟合的配比”**串成了一条线:优化器不会帮你判断目标对不对,它只会忠实地把你推向你写的那个目标。
11.7 两轮课堂问答
问答三:下采样会不会小到无法泛化?
学生问:走完采样之后,会不会有"数据太小以至于没法泛化"的风险?
Percy:绝对会。 你可能会落到只有极少量 token 的情况。他认为这时候最优点会自动给那个来源分配一个很小的权重——所以原则上它应该能自洽。但可能会出现舍入误差,导致你本来该训一遍的数据,意外地训了零遍。 绕过方法很简单:“那你只要保证它至少训一遍就行了。”
这是一个很小的工程细节,但它暴露了"配比是浮点数、而训练是离散的"这个落差——一个理论上的最优分布落到实现上,需要有人保证"每个来源至少被碰到一次"。
问答四:会不会在一个数据集内部做数据混合?
学生注意到"这些来源恰好对应不同的 topic",于是问:会不会拿一个已经很杂的数据集,在它内部做 data mixing?
Percy:这是好问题,而且我忘了讲这一点,很高兴你提出来。 他给的答案来自 Nemotron 论文的做法:假设我只给你 Common Crawl,你完全可以在它内部做拆分——按域名(domain)分组(他提到有工具可以做这件事,比如 web organizer 之类的按 topic 分组),同时按质量过滤。于是你得到一个二维网格:一维是 domain,一维是 quality。而网格里的每一个格子,就是一个可以做数据混合的对象。
Percy 说:这是一种自动确定"领域"的方法。 然后再在它之上,把你手工收集来的额外来源加进去。
这一轮问答其实把"数据混合"的对象层级打开了:混合不只是"在若干异构数据集之间配比",也可以是"在一个同质数据集内部按领域 × 质量的二维切分做配比"。 后者是把"如何定义领域"这件事从人工变成了自动。
12. 后训练数据:合成数据主导的配方
12.1 配方的通用形状
Percy 切换到后半段,并先划了一条界线:到目前为止讲的基本都是 pre-training 或者 mid-training 数据,它们总体上相当 task agnostic(RegMix 那种为了最小化某个 loss 的做法是个例外,但数据本身仍然是任务无关的,你在开发的是基础能力)。
而后训练的数据里,很大一部分变得高度任务相关(very task-dependent)。 他明确说不做全面综述,只挑几个最近发布的、有意思的后训练数据集讲,尤其是代码方向的,因为那是当下最受关注的。
通用配方是三步:定义一组环境(environments)→ 定义一组任务或 prompt → 从强模型(teacher)那里收集回答。
Percy 在这里点破了整个开放社区的现实:隐含地、至少对开放社区来说,几乎所有后训练数据、或者说其中的大部分,都是合成生成的(synthetically generated)。 他补了历史对比:你也可以用人类来替代强模型,但那很慢、很贵——几年前在 frontier 上你必须花大钱雇很多人来给你回答;而现在即使在 frontier 上,也可以做"人机混合"的事情。 但要点不变:有一个 teacher 在给你回答。
12.2 OpenThoughts:不只是造数据,还测了"怎么造"
第一个例子是 OpenThoughts。Percy 讲了它的动机:它诞生在 o1 发布之后,当时大家对 reasoning 的关注度很高,主要是数学和科学方向——问题就是"怎么拿到真正好的后训练数据集"。
最终他们产出了 120 万个例子(1.2M examples),teacher 模型是 QwQ-32B。问题的来源非常广:27 个人工与合成来源(StackExchange、NuminaMath、化学等等)。Percy 说这是一个涉及很多人贡献的大项目。
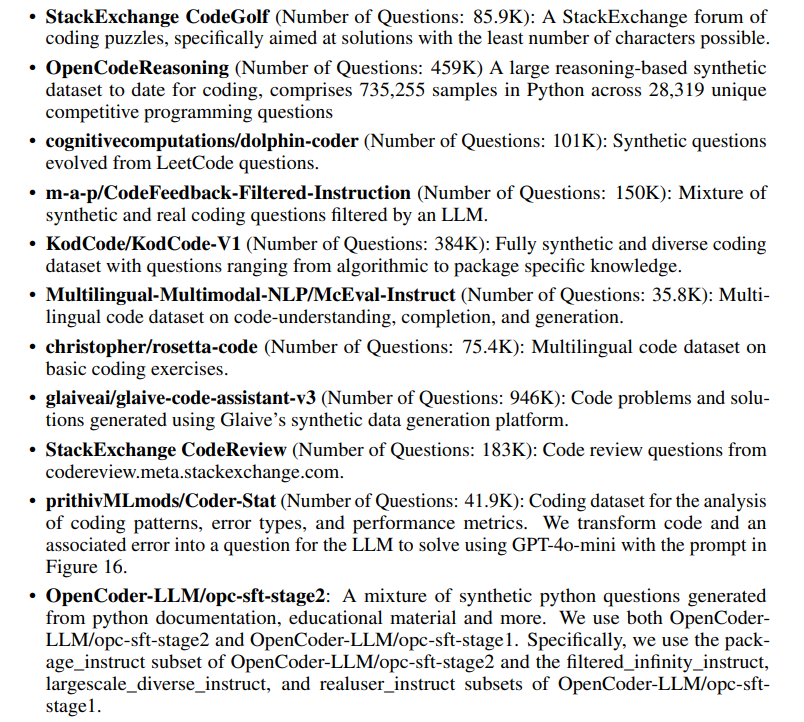
(这是论文里代码类来源的一部分(数学和化学的没列)。每个条目是"名字(问题数):描述"。几个有意思的读数:glaiveai/glaive-code-assistant-v3 946K、OpenCodeReasoning 459K(描述里说是最大的推理式合成代码数据集,735,255 条 Python 样本、来自 28,319 道唯一的竞赛编程题)、KodCode/KodCode-V1 384K、StackExchange CodeReview 183K、m-a-p/CodeFeedback-Filtered-Instruction 150K、cognitivecomputations/dolphin-coder 101K、StackExchange CodeGolf 85.9K、christopher/rosetta-code 75.4K、prithivMLmods/Coder-Stat 41.9K、Multilingual-Multimodal-NLP/McEval-Instruct 35.8K,外加 OpenCoder 的 opc-sft-stage1/stage2 的若干子集。Percy 在课上特别点了一句:这里面有些是编程练习题,有些则更贴近真实工作——比如代码评审(code review)就比 CodeGolf 现实得多。 这张清单直观展示了"合成数据"的上游其实是大量人工和半人工的题目来源。)
接下来是这个工作最有价值的部分——Percy 说他们做了一个相当全面的分析,研究"给定这个数据集,应该怎么生成回答"。结论有四条,每一条都有点反直觉:
第一,用少数几个来源,比用全部来源更好。 (讲义措辞是 “having a few sources was actually good than trying to do all sources”。)
第二,每个 prompt 采多个回答(16 个)是有帮助的。
第三——这条最出人意料——更强的模型不一定更好的老师。 具体例子:QwQ-32B,一个现在看已经又老又小的模型,是比 DeepSeek-R1 更好的 teacher,而 DeepSeek-R1 在当时大概是最强的开放模型之一。Percy 讲述时的语气是明显的"这很有意思"。“能力"和"教学价值"是两件事——这个区分在合成数据里反复出现,后面 phi-1 的"教育价值"prompt 和 SWE-Zero 的蒸馏过滤都是它的变体。
第四,基本的答案过滤(basic answer filtering)没有帮助。 这一条也挺反直觉——在生成完之后再做一道"筛掉坏答案"的工序,收益不明显。
Percy 还给了一条来源层面的结论:小而高质量的来源(比如 OpenMath-2-Math)比大而杂的来源更好。 这与过滤那一节的"质量定义是可选的工具"一脉相承。
最后是流水线的形状:
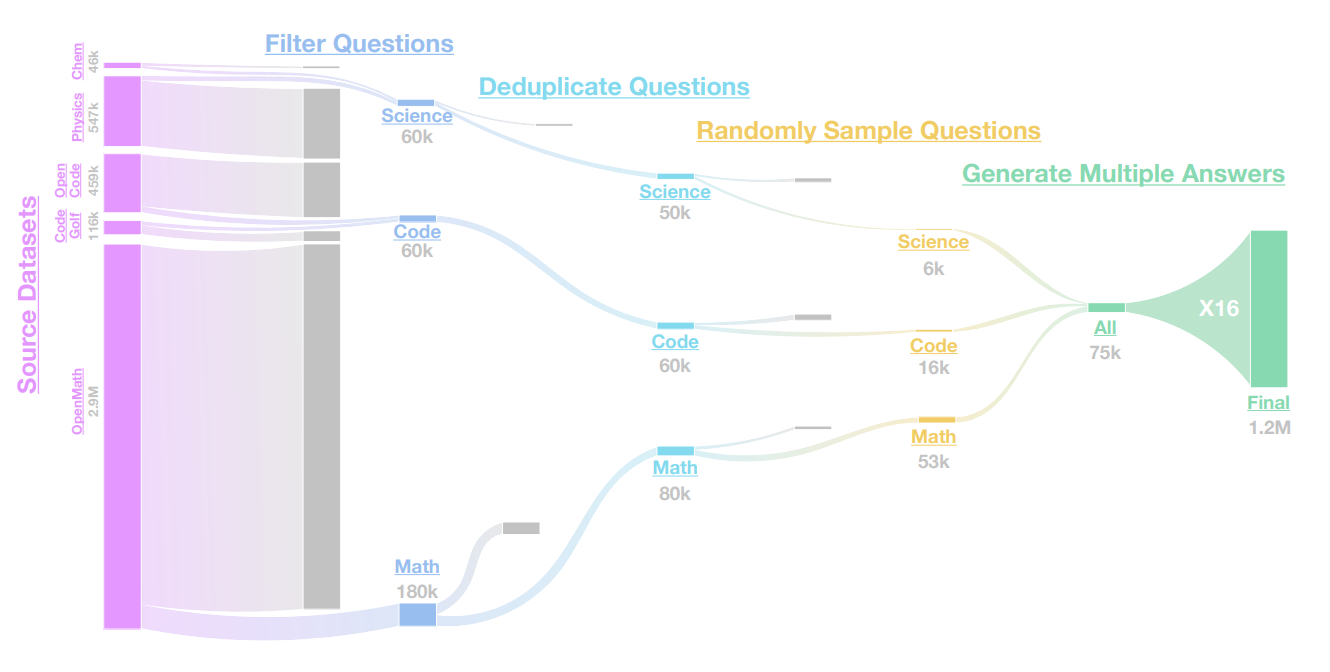
(这是一张 Sankey 式的流向图,把"从 5 个原始来源到 1.2M 条数据"的每一层损耗都画了出来。数字非常有信息量:来源侧是 Chem 46k、Physics 547k、Open Code 459k、Golf Code 116k、OpenMath 2.9M(合计约 4.07M);过滤问题后合并成 Science 60k / Code 60k / Math 180k(合计 300k);去重后是 50k / 60k / 80k(合计 190k);随机采样后是 6k / 16k / 53k(合计 75k);然后这 75k 个问题各生成 16 个回答,膨胀成 1.2M。Percy 特意澄清过这个数字关系:“1.2M 是例子的数量,除以 16 才是实际问题的数量。” 整条链路的淘汰率非常高——从 407 万条原始题目到 7.5 万条最终题目,只剩 1.8%。)
12.3 SWE-smith:用语言模型在一整个仓库上"造 bug”
Percy 说最近关注度转向了 agentic coding model——不只是能生成代码,而是真能"做软件开发"。
SWE-smith 的想法是:给你一个仓库,用语言模型自动生成任务。 流程在讲义配图里画得很细:
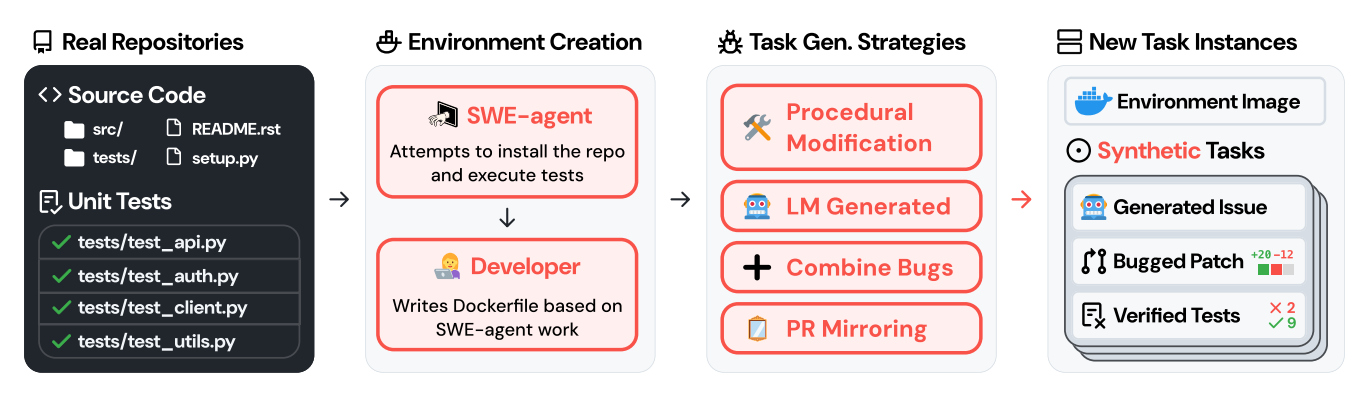
(四个阶段:1 Real Repositories(真实仓库,有 src/、tests/、README.rst、setup.py,以及一批绿色的通过测试 tests/test_api.py、test_auth.py、test_client.py、test_utils.py);2 Environment Creation(SWE-agent 先尝试安装仓库并跑测试,然后由开发者基于 SWE-agent 的工作写 Dockerfile——注意这一步是"AI 先干、人收尾");3 Task Gen. Strategies(四种造任务策略:Procedural Modification(程序化修改)、LM Generated(语言模型生成)、Combine Bugs(组合多个 bug)、PR Mirroring(镜像真实 PR));4 New Task Instances(一个任务实例包含:Docker 环境镜像 + 生成的 issue 描述 + 带 bug 的 patch(图上标着 +20 -12 行)+ 验证过的测试(图上标着 2 个红色叉、9 个绿色勾)。那组 “2 个失败 / 9 个通过” 是整个设计的精髓:2 个失败正是被注入的 bug 造成的,9 个通过保证不破坏原有行为。)
数字上:128 个 GitHub 仓库产出 50K 个任务。Percy 补了时间坐标:这个量在去年(发布时)已经算相当大了。 而这句话同时也是给后面 SWE-Zero 的 300K 和 12M 做铺垫——这个领域的数据规模在一年内涨了两个数量级。
12.4 SWE-Zero:绕开"依赖地狱"
Percy 说这是 NVIDIA 的工作,而且它的起点是一个很实际的观察:和数学不一样,SWE 任务有很重的依赖(heavy dependencies)。大多数 GitHub 仓库根本就跑不起来——你得装一堆依赖,它们还可能过时,尤其是当你回滚到某个 PR 刚提交的那个时刻,环境更是一团乱。这完全是一场噩梦(this is just a nightmare)。
于是他们的思路转向:怎么在一堆仓库上真的把数据集做出来? 他们没有走"为每个仓库做一个专用 Docker 镜像"的路——因为注意到模型已经足够强,可以在没有执行反馈的情况下解掉很多这类任务。
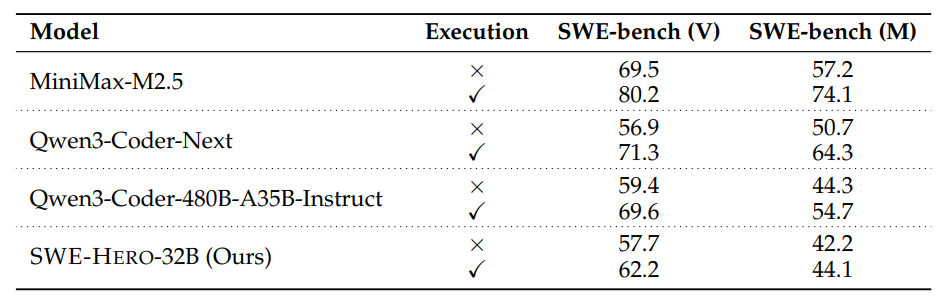
(这张表把四组模型在 SWE-bench (V) 和 (M) 两个版本上的成绩按"是否允许执行"(✕ / ✓)列出来。MiniMax-M2.5:69.5/57.2(不执行)→ 80.2/74.1(执行);Qwen3-Coder-Next:56.9/50.7 → 71.3/64.3;Qwen3-Coder-480B-A35B-Instruct:59.4/44.3 → 69.6/54.7;SWE-Hero-32B(本文的模型):57.7/42.2 → 62.2/44.1。Percy 在课上指的就是第一行:“如果你允许执行,你能拿到 80;不允许执行,也能拿到接近 70——对于完全不能跑代码的情况,这并不差。” 整个方法的可行性就建立在这一行数字上。)
Percy 从这里抽出那个关键的假设:这些模型内部有某种关于代码语义的"世界模型"(internal world model of code semantics)。 也就是说,“跑一遍看看"这个动作提供的信息,模型已经在预训练里部分学到了。
于是他描述了 SWE-Zero 的做法:生成 300K 条 agent 轨迹(agent trajectories),这些轨迹不需要任何仓库专用的执行环境。 它们的来源是 150K 个真实的 GitHub PR——所以任务本身是真实的、贴近实战的。脚手架用的是 OpenHands。
然后是"防作弊"这一块,Percy 说这里面有很多细节。他的描述是:正常情况你给 agent 的指令是"你去探索、去测试、去实现”。而 SWE-Zero 的版本基本上是说:你不能跑 Python 代码,你只做 sed、grep 这些基本操作。 讲义配图把两套设置并排画了出来:
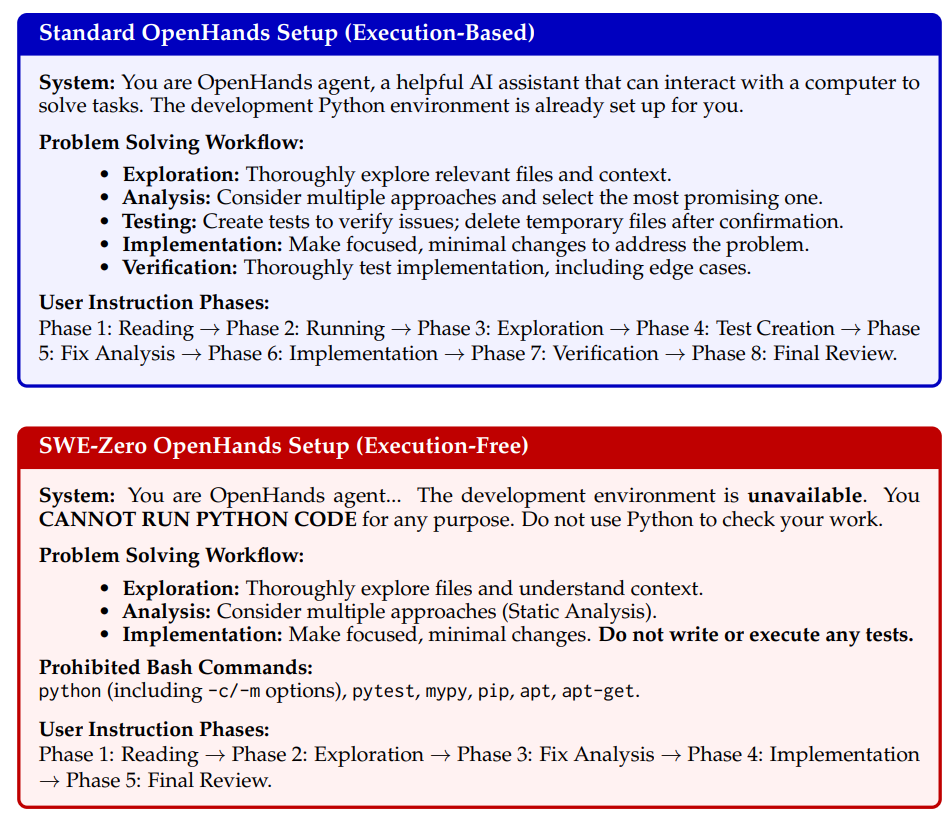
(上半是蓝框的 Standard OpenHands Setup (Execution-Based):系统提示说"开发环境已经给你配好了",工作流有五步(探索 → 分析 → 写测试验证问题 → 实现最小改动 → 彻底测试实现包括边界情况),用户指令有八个阶段(Reading → Running → Exploration → Test Creation → Fix Analysis → Implementation → Verification → Final Review,加粗的三个都是执行相关)。下半是红框的 SWE-Zero OpenHands Setup (Execution-Free):系统提示里用全大写强调 “The development environment is UNAVAILABLE. You CANNOT RUN PYTHON CODE for any purpose.”;工作流压缩成三步(探索 → 分析(静态分析)→ 实现,并明确"不要写或执行任何测试");多出一栏明确禁止的 bash 命令:python(含 -c / -m)、pytest、mypy、pip、apt、apt-get;用户指令阶段也从八个减到五个(删掉的正是 Running / Test Creation / Verification)。这张图是一份"如何把一个 agent 的手脚绑住"的完整规格说明——它同时也是 SWE-Zero 数据集之所以"轻量"的根源:不需要为每个仓库准备可执行环境,成本结构完全不同。)
另有一个更隐蔽的作弊路径,Percy 用引号强调过:他们会"去掉未来的 git commit",以防止 agent 用 “git hacking” 的方式把答案直接查出来。 这属于同一类防护——任务的历史里藏着正确答案,所以必须把未来的历史剪掉。
数据来源上:从 Qwen3-Coder-480B 蒸馏,并做过滤——Percy 说的过滤理由是**“有时候 Qwen 模型会无视这些指令、仍然试图去执行”**(所以这些轨迹要剔掉)。
还有一个补充数据集 SWE-Hero:13K 条需要执行反馈的 agent 轨迹。 训练方式大致是先用 SWE-Zero 那批例子做微调,再用另一批做第二轮微调(Percy 讲得很快,说"我没有时间展开")。效果看他随即展示的图:
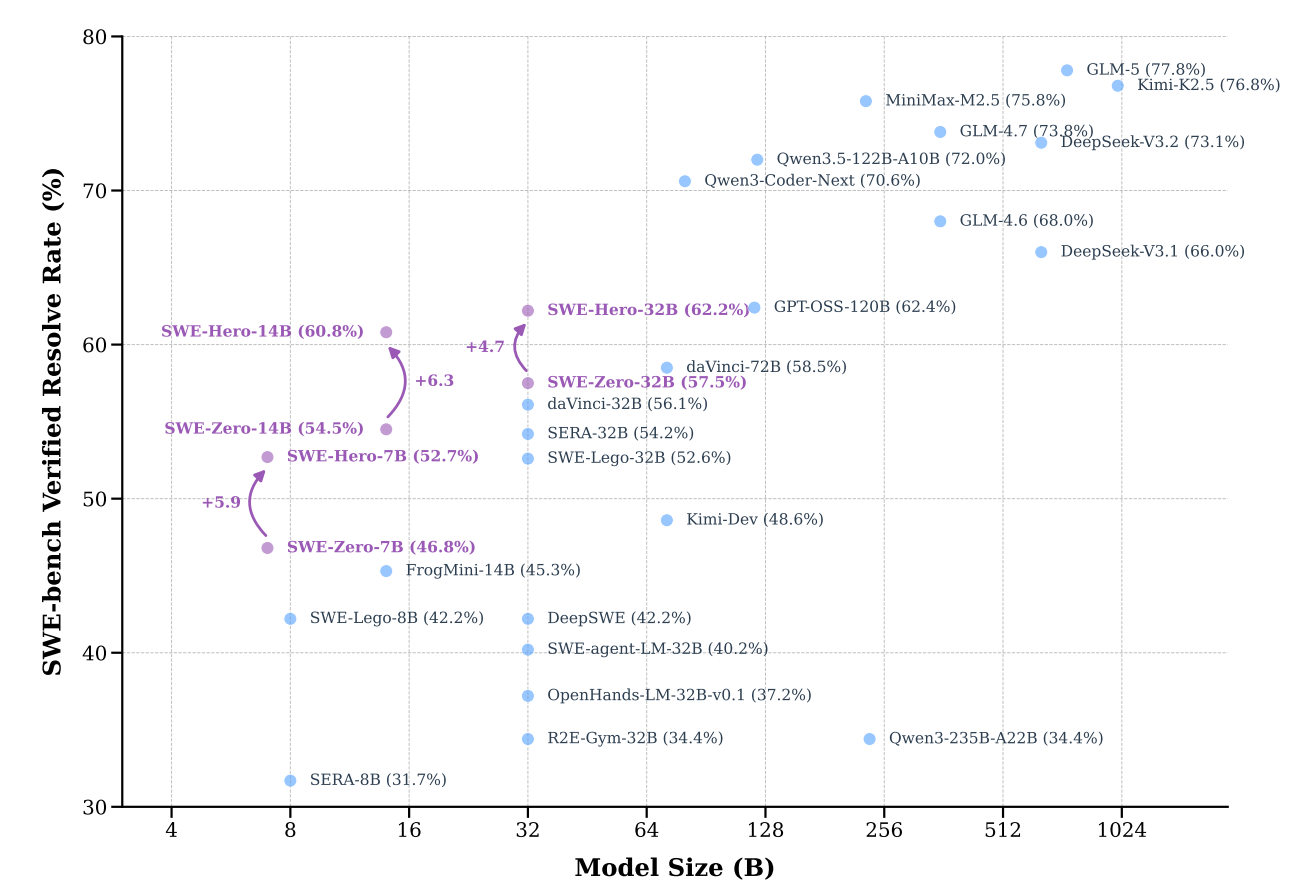
(横轴是模型规模(对数刻度,4 到 1024 B),纵轴是 SWE-bench Verified 解决率(30%–80%)。紫色的点是这篇论文自己的模型,浅蓝色是各种基线。 三条紫色弧线标出同一规模下 Zero → Hero 的提升:7B 从 SWE-Zero-7B 的 46.8% 提到 SWE-Hero-7B 的 52.7%(+5.9);14B 从 54.5% 到 60.8%(+6.3);32B 从 57.5% 到 62.2%(+4.7)。图中顶端是 2026 年的前沿模型群:GLM-5 77.8、Kimi-K2.5 76.8、MiniMax-M2.5 75.8、GLM-4.7 73.8、DeepSeek-V3.2 73.1、Qwen3.5-122B-A10B 72.0、Qwen3-Coder-Next 70.6。Percy 的点评是"前沿还很高",但最值得注意的读数是规模效率:SWE-Hero-14B 拿到 60.8%,已经超过了一批 32B 级别的模型,也逼近 GPT-OSS-120B 的 62.4%——也就是这些合成轨迹把中小模型推上了一个原本需要大得多的参数量的水平。)
12.5 SWE-rebench:换一条路去"抓大量的 PR"
Percy 说这个工作"基本上又是一次抓大量 PR 的尝试"。他一句话概括了这一类工作的共同形状:“拿一堆 GitHub 仓库,试着把仓库装起来;大部分大概都失败了,然后你再试得更努力一点;然后用语言模型给你生成回答。”
具体数字:3.4K 个 GitHub 仓库产出 21K 个可交互的 Python SWE 任务,候选来自 GitHub 和 GitHub Archive 上的 450K 个 PR,并且用 Qwen 2.5-72B-Instruct 去安装依赖、评估 PR 质量。
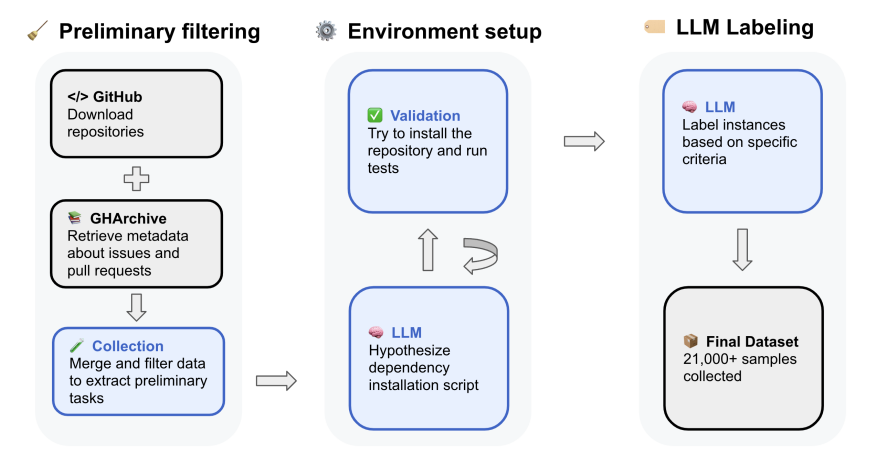
(三个阶段:Preliminary filtering(GitHub 下载仓库 + GHArchive 取 issue / PR 的元数据 → 合并过滤出初步任务);Environment setup(一个循环:Validation「尝试安装仓库并跑测试」 ⇄ LLM「推断依赖安装脚本」——这个来回循环是整张图的重点,说明环境能不能装起来,是靠 LLM 反复猜依赖猜出来的);LLM Labeling(用 LLM 按特定标准给实例打标签)→ Final Dataset 21,000+ samples。这张图解释了"3.4K 仓库为什么只出了 21K 任务"——环境搭建是那个漏斗的瓶颈。)
Percy 特别提了一句时间:“这些其实今天才刚出来(these actually just came out today)。” 说明这一讲是在追最新的进展。
顺带这也解释了前面 SWE-Zero 的价值主张:SWE-rebench 这条路要把环境跑通才能用,而 SWE-Zero 不需要——下面就是这个对比的直接后果。
12.6 SWE-ZERO-12M:把"不需要执行"这件事规模化
最后一个是 SWE-ZERO-12M-trajectories,Percy 的表述是:“你可以把 SWE-Zero 那个想法拿来,然后现在扩展到 1200 万条 agent 轨迹。”
SWE-Zero 的好处是它非常轻量(very lightweight),而这里用的任务来自 SWE-rebench-v2。Percy 点出了两批任务的数量对比,而且这句话里藏着一个转写丢失(口述里"120K"被吞掉了 K,从上下文和数据集卡可以确认是 120K):
SWE-rebench 里只有 32K 个任务能真正执行起来,另外 120K 个跑不起来。
“但 SWE-Zero 不在乎(SWE-Zero doesn’t care)——你可以把它们全都用上。”
这句话是整个后半段最有力的一个结论。前面那个把 SWE-rebench 卡在 21K 任务的瓶颈(环境能不能跑起来),在 SWE-Zero 的范式下直接消失了——因为方法本身不依赖执行反馈,那 120K 个"跑不起来"的任务从废料变成了可用数据。
执行上还有一个细节值得记:跑这批轨迹用的是 mini-coder-1.7b——一个非常小的模型,pass@100 是 50.4——脚手架是 mini-swe-agent。 也就是说,造这批数据没有被"必须用最强模型"这件事卡住,这也是它能扩到 12M 量级的前提之一。
12.7 后半段小结
Percy 用几个维度收束:
prompt 的来源可以是三类:完全合成(fully-synthetic)、半合成(semi-synthetic,真实环境 + 合成任务,SWE-smith 就是这一类)、真实(GitHub PR,SWE-Zero 用的是这一类)。
回答的来源:有能力、同时也得是好老师的模型。
最后一句是无奈的:“代码环境太痛苦了(Code environments are painful)”,而且还有大量的过滤和其它细节,我们没时间讲。
13. 总结
Percy 的收尾很短,四条:
过滤:定义"好的样子",然后训练一个轻量分类器,扫描你的网络爬取,得到一小份符合目标的子集。
去重:关键在于避免过拟合、节省 FLOPs;hashing 让 fuzzy matching 可以扩展到超大规模数据。
混合:在小尺度上试各种配比,外推到最优配比和大尺度。
后训练数据:它看起来更像评测集(it looks like evaluations),而且合成数据的使用是主流。
最后是他一贯的那句免责声明,但这次的措辞很有分量:“我要说,大量的数据工作实际上非常琐碎(very grungy),非常领域相关,而且需要去看具体的例子才能做出高质量的数据集。所以这节课其实并不代表数据工作真正的样子,但希望能给你一个关于数据版图的概念。”
这句话值得单独记一下:这节课讲的是一套漂亮、有原理的框架(T/R 骨架、MinHash-LSH、回归式混合),而 Percy 明确说真实工作不长这样。 这个反差本身就是一条重要的元信息——框架的作用是让你在琐碎的具体决策里知道自己在哪个坐标上,而不是替代那些决策。
14. 术语表
| 术语 | 含义 |
|---|---|
| transformation | 把原始抓取内容(HTML / PDF / 目录树)转成文本的过程,本质上是 lossy 的线性化 |
| boilerplate | 页面模板性的部分(导航、广告、页头页尾),通常被当作噪声去除 |
| linearize | 把层级或二维结构的信息压成一维 token 序列;这是 HTML/PDF 转换的核心难点 |
| target data T / raw data R / T' | 过滤框架的三要素:想要的少量高质量数据、海量原始数据、从 R 中筛出的类似 T 的子集 |
| KenLM | 基于 n-gram(讲义里是 5-gram)的生成式语言模型,用于算 p_T(x) 型打分 |
| fastText | 快速的线性文本分类器(词袋 + 线性层),过滤里最常用的判别式打分器 |
| 尺度依赖的过滤 | 没有全局最优阈值:训练 token 越多越能容忍低质量数据,反之亦然 |
| decontamination | 去污染:确保评测集不出现在训练集里;去重的同族问题,但更要紧 |
| Jaccard 相似度 | ` |
| MinHash | 一组随机 hash 函数,使 Pr[h(A) = h(B)] = Jaccard(A, B):把集合相似度变成可哈希比较的对象 |
| LSH(locality-sensitive hashing) | 把 n 个 MinHash 函数分成 b 个 band、每 band r 个,用 and-or 结构把碰撞概率锐化成相变 |
| band / r | LSH 的两个旋钮:增大 r 使曲线右移变陡(更难匹配),增大 b 使曲线左移(更易匹配) |
| phase transition threshold | LSH 的相变点位于 (1/b)^(1/r),该点碰撞概率恒为 ≈ 1 - 1/e ≈ 0.64 |
| data mixture | 数据源上的一个概率分布,决定训练时各来源被采样的比例 |
| vibes / uniform / proportional | 三种朴素配比基线:手工凭直觉 / 均匀 / 按 token 数成比例 |
| epoching | 对同一批数据重复训练;配比失衡会让小数据源被大量重复,导致过拟合 |
| UniMax | 多语言场景的做法:均匀采样来源,但对每个来源的 epoch 数设硬上限 |
| 回归式混合(RegMix / Olmix) | 用小规模 proxy 模型群拟合"混合权重 → loss"的回归,优化后再外推到大尺度 |
| simulated epoching | 按小/大 run 的 token 比例把所有来源等比下采样,让小尺度实验"感受到"大尺度的数据稀缺 |
| OpenThoughts | 1.2M 条 reasoning 后训练数据,QwQ-32B 为 teacher,27 个来源,每 prompt 采 16 个回答 |
| SWE-smith | 用 LM 在真实仓库上自动注入 bug 生成 SWE 任务;128 仓库 → 50K 任务 |
| SWE-Zero | 不用执行反馈的 SWE 轨迹数据集;300K 轨迹 / 150K PR / OpenHands 脚手架 / 从 Qwen3-Coder-480B 蒸馏 |
| SWE-Hero | SWE-Zero 的补充:13K 条需要执行反馈的轨迹 |
| SWE-rebench | 21K 个可交互 Python SWE 任务,来自 3.4K 仓库、450K PR 候选;瓶颈在环境搭建 |
| SWE-ZERO-12M | 把 SWE-Zero 规模化到 12M 条轨迹,复用 SWE-rebench-v2 的 32K 可执行 + 120K 不可执行任务 |
15. 拓展阅读 / 参考资料
讲义与课程
- 本讲讲义(可执行形式,含全部代码与图):https://github.com/stanford-cs336/lectures/blob/main/lecture_14.py
- 讲义逐行 trace 模式:https://cs336.stanford.edu/lectures/?trace=lecture_14
- 课程主页与课表:https://cs336.stanford.edu/
数据选择与过滤
- 数据选择综述(讲义引用):https://arxiv.org/abs/2402.16827
- OpenMathText:https://arxiv.org/pdf/2310.06786
- GPT-3(过滤方法见 Appendix A):https://arxiv.org/pdf/2005.14165
- LLaMA:https://arxiv.org/pdf/2302.13971
- phi-1(Textbooks Are All You Need):https://arxiv.org/pdf/2306.11644
- Dolma 数据集:https://arxiv.org/abs/2402.00159
- DCLM:https://arxiv.org/abs/2406.11794
- fastText 语言识别(176 语言):https://fasttext.cc/docs/en/language-identification.html
- Jigsaw Toxic Comment 数据集:https://www.kaggle.com/datasets/julian3833/jigsaw-toxic-comment-classification-challenge
去重
- Deduplicating Training Data Makes Language Models Better:https://arxiv.org/pdf/2107.06499
- C4 / T5(三句 span 精确去重):https://arxiv.org/pdf/1910.10683v4
- LSH 教材章节(Ullman, MMDS 第 3 章):http://infolab.stanford.edu/~ullman/mmds/ch3n.pdf
数据混合
- The Pile:https://arxiv.org/abs/2101.00027
- UniMax:https://arxiv.org/abs/2304.09151
- RegMix:https://arxiv.org/abs/2407.01492
- Olmix:https://arxiv.org/pdf/2602.12237
- Simulated epoching:https://arxiv.org/pdf/2501.11747
- Marin token-count-viewer:https://huggingface.co/spaces/marin-community/token-count-viewer
后训练 / 合成数据
- OpenThoughts:https://arxiv.org/abs/2506.04178
- SWE-smith:https://arxiv.org/abs/2504.21798
- SWE-Zero:https://arxiv.org/abs/2604.01496
- SWE-rebench:https://arxiv.org/pdf/2505.20411
- SWE-ZERO-12M-trajectories 数据集:https://huggingface.co/datasets/AlienKevin/SWE-ZERO-12M-trajectories
其它
- FinePDFs 博客(PDF 解析的细节):https://huggingface.co/spaces/HuggingFaceFW/FinePDFsBlog
- 上一讲(Lecture 13: Data 的来源与数据集)笔记:
cs336-lecture13-data-sources-datasets-2026-09-14.md
16. 我的感想
(留空待补)
17. 待深入 / 疑问
(留空待补)