视频: https://youtu.be/-qm0ln33G24 | 频道: Stanford Online | 发布时间: 2026-05-19 时长: 1h22m2s | 播放量: 7867 (记录时) | 分类: llm 讲者: Percy Liang(课程主页 https://cs336.stanford.edu/ ;可执行讲义 https://github.com/stanford-cs336/lectures/blob/main/lecture_13.py )
视频简介: CS336 第十三讲,由 Percy Liang 主讲数据的来源与数据集。上一讲讲了评估,回答了"什么是一个好模型";这一讲开始回答"我们到底该在什么数据上训练"。Percy 的主张是:数据是语言模型里最该做对的一件事。前半节课从零开始拆"数据从哪来"——活的服务器、爬虫、robots.txt、ToS、Cloudflare、影子图书馆,以及由此展开的整块版权法(许可、fair use 四要素、近期判例)。后半节课按时间线走过 2018 到 2025 年的数据集编年史:BERT 的 Wikipedia+BooksCorpus、GPT-2 的 Reddit 外链、CCNet、C4、GPT-3、The Pile、Gopher、LLaMA、RefinedWeb、FineWeb、Dolma、DCLM、Nemotron-CC、The Stack v1/v2,最后落到只用宽松许可数据训练的 Common Pile。
1. 开场:数据是语言模型里最该做对的一件事
Percy 用一句话定了这一讲的调子:data is the most important thing to get right in language models。他给出的第一条证据不是技术论证,而是一个观察:去看公司实际披露了什么。以 Llama 3 论文为例,Meta 对架构是完全透明的(毕竟是开放权重模型),他们甚至把训练流程也交代了——但是关于数据,几乎什么都没说。
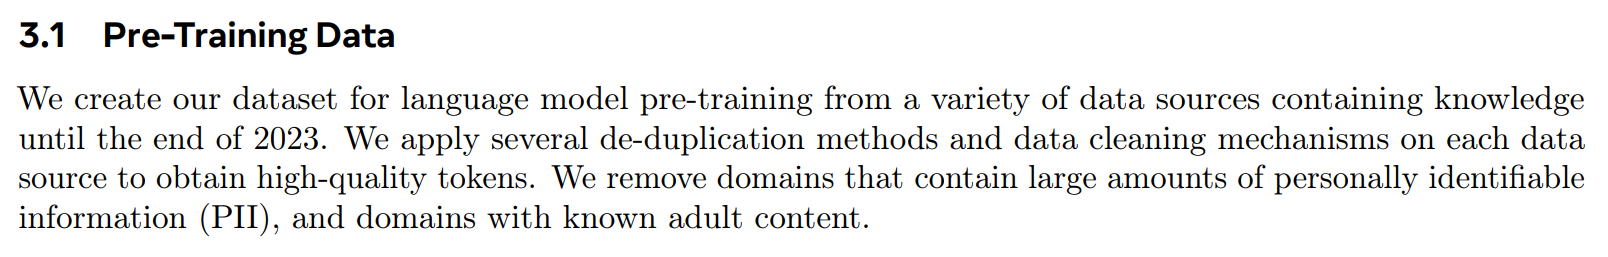
这张图就是全文。你没有看错:Llama 3 的"数据章节"就只有这一段话。Percy 说这种保密有两个理由。第一个是竞争动态(competitive dynamics)——数据是你的秘方,你不想让竞争对手知道你在干什么。第二个,也是这节课要花大量篇幅讨论的,是版权责任(copyright liability)——你不想因为告诉大家自己训练在某些数据上而被起诉。
接着他做了一次历史定位。在 foundation model 之前,“数据工作"指的是你为监督学习标注(annotate)数据。如今手工标注少了很多,至少预训练阶段是这样,但仍存在大量的整理(curation)和清洗(cleaning)。而且从根本上说,这件事没有变过:数据一直是瓶颈,也永远会是瓶颈,因为它在某种意义上是长尾问题(long-tail problem),其规模随人力线性增长。你可以让很多人去做架构和系统,但能投在这两件事上的人数是有限的;而数据——尤其是你要训练一个想做所有事情的 foundation model 时——投入的人力可以轻易地规模化。这就是为什么数据团队和模型开发者的人数实际上相当可观。
2. 训练的三段式,以及 base model 的消失
Percy 给出了数据在流水线中出现的三个阶段。预训练(pre-training):拿原始数据训练,比如来自网页的文档。中训练(mid-training):在更高质量的数据上继续训练,以增强特定能力、把上下文拉长等等。后训练(post-training):训练在聊天记录上,如果做强化学习,就是在各种环境里训练。这条线在实践中是模糊的,也可能不止三个阶段,但基本模板是:随着训练推进,我们从"大量低质量数据"走向"少量高质量数据”。
术语上,base model 通常指预训练加中训练之后的模型,instruct / chat model 指后训练之后的模型。但 Percy 加了一句:这条线已经模糊到"什么还算 base model"其实说不清楚了。而且更近的趋势是,最大的那些模型干脆不再发布 base model 了——你看到的就只有 Qwen3.5-397B-A17B 这么一个 instruct 模型,中间检查点你看不到。像 AI2 的 OLMo 这种开源模型是例外,全过程都看得到,所以这节课会拿它当解剖样本。
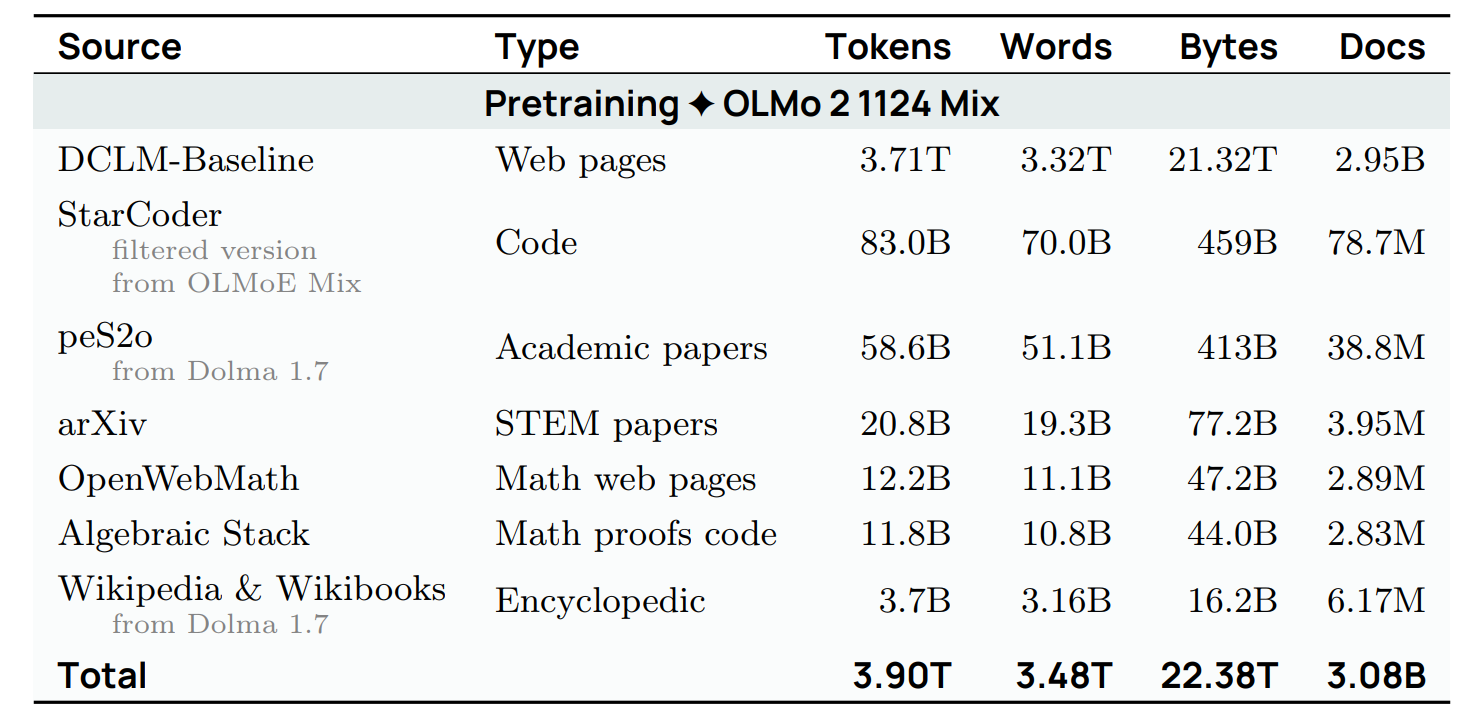
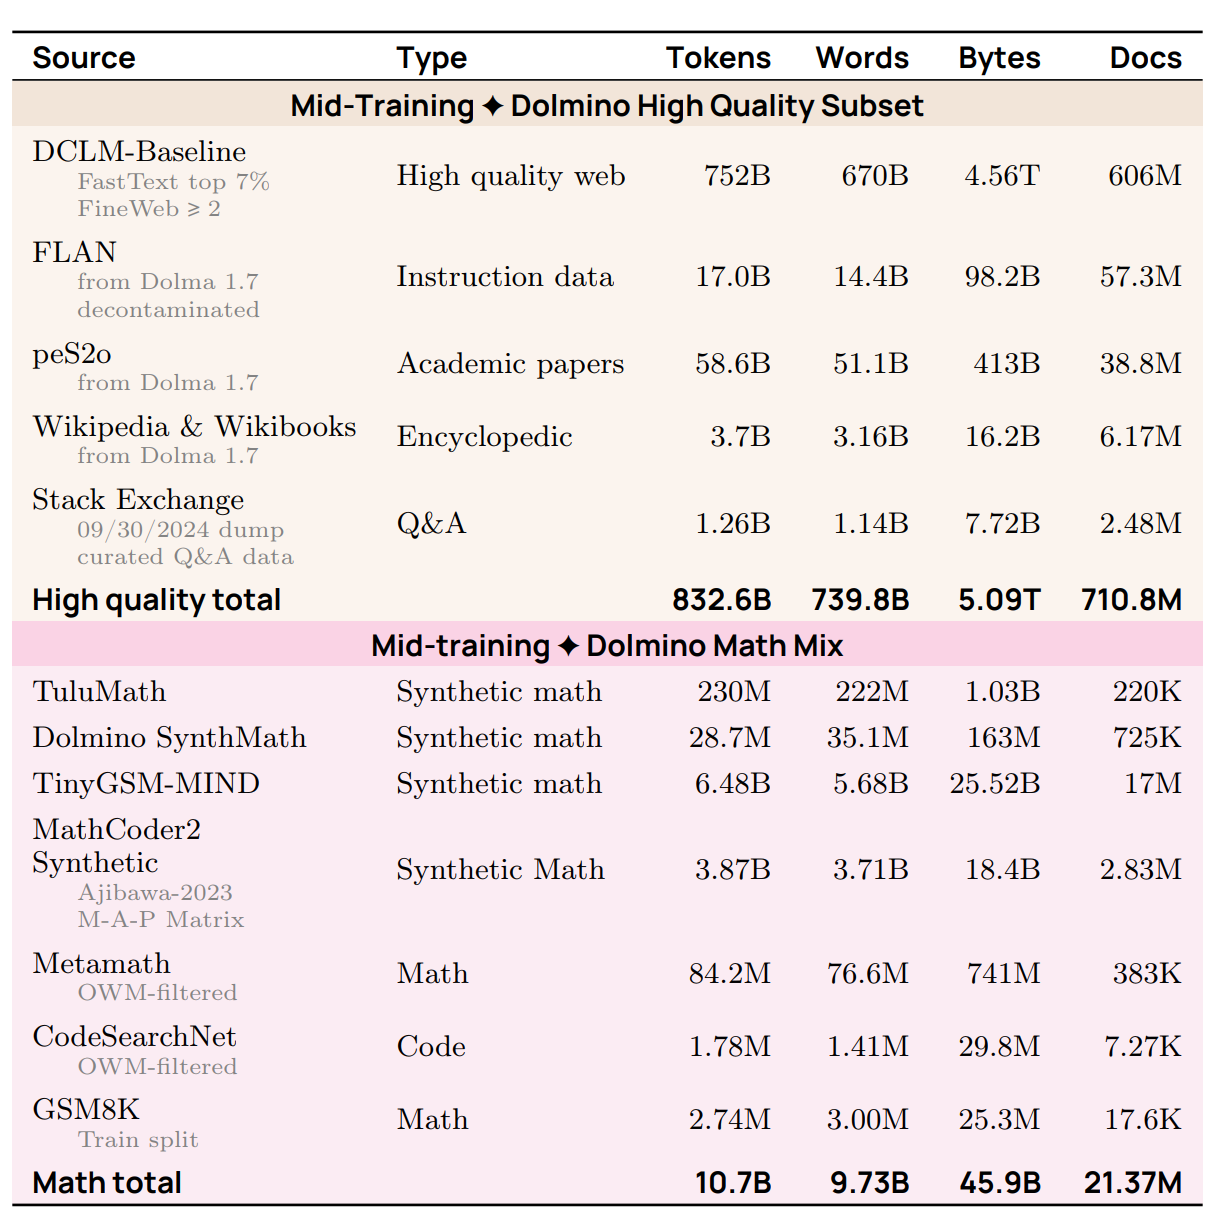
这两张表把"三段式"里前两段的量级差摆得很清楚:预训练 3.90T tokens,中训练的高质量子集只有 832.6B,数学混料更是只有 10.7B。至于后训练,Percy 指向的是 Tulu 3(arXiv 2411.15124 ),那里是聊天记录、指令数据和安全数据的地盘。
落到具体来源上:预训练用的是网页、学术论文、数学页与证明等等;中训练是更高质量的网页数据、指令数据,以及大量合成数据;后训练则是聊天日志,加上更多数学与推理、代码,安全性也在这个阶段处理。那么问题来了——这些数据集到底是什么?怎么选它们?怎么处理它们? 这就是本讲的主问题。
3. “语言模型是在整个互联网上训练的”——这句话错在哪
Percy 说,你可能在走廊里听人说过"语言模型是在整个互联网上训练的"。第一,这句话在类型上就不对(doesn’t quite type-check):真要成立,模型得是一个联网的 RL agent 到处跑,而预训练根本不是这么工作的。稍微准确一点的版本是"在公开的万维网上训练",但这也并不准确,原因他接下来逐条展开。
首先,web 本身是一堆活着的服务器(live servers),你可以连上去,请求一个 URL、拿回一个响应。你不能直接在活服务器上训练,除非你在训 RL agent。所以通常的做法是有一个爬虫(crawler)——不一定是你自己造的——它从种子集(seed set)出发去发现有哪些网页,并在爬行过程中下载发现的网页。
但你还是不能"把整个互联网爬下来",原因有好几层。第一层是动态内容:现在很多站点本质上是应用,URL 甚至不再是内容的完整规格说明,它只是一个你与之交互的 app,要点击按钮、提交表单才能拿到内容。Discord 就是典型——你不可能爬 Discord 拿到里面所有内容。大量内容属于所谓深网(deep web),靠传统的"跟着超链接走"的爬取模型触及不到。
第二层是认证(authentication):有些页面需要登录、需要账号,通常还需要付费。Facebook、X、LinkedIn、纽约时报都是如此。这些是巨大的围墙花园(walled gardens),内容技术上在 web 上,但你没法造个爬虫进去爬。Percy 补了一句略酸的观察:如果你是 Facebook,你不需要爬 Facebook,数据本来就在你手里;如果你是 xAI,你可以训练在 X 上;但对其他任何人,这些内容就是拿不到。
第三层是技术限制,即使没有认证问题也依然存在。robots.txt 是放在站点根目录下(比如 nytimes.com)的一个文件,用来告诉你哪些允许爬、哪些不允许。里面很多东西是 disallowed:OAI-SearchBot、PerplexityBot、QuoraBot,基本上 ChatGPT-User、ClaudeBot 这一串都在列。Percy 特意强调:这不是技术限制,也不是法律限制,而是"你应该做个好公民"的约定——你的名字在名单上,你就不该爬它。这连合同都算不上,只是一个你被期待遵守的东西。此外还有 Cloudflare 这类检测并阻断 bot 流量的服务(你看到的 CAPTCHA 就是某个算法判断你可能是个 bot),还有封 IP、封国家、限速(rate limits)。
第四层是法律限制:网站的服务条款(terms of service, ToS)会说"如果你是 bot 就请离开"“你不能把本站内容用于 AI 训练"之类的话。而且即便 ToS 什么都没说,网页内容本身可能带许可证,或者你根本没有训练它的许可。
这套约束本身还在随时间收紧。Percy 引用了 Shane Longpre 等人的论文 Consent in Crisis(arXiv 2407.14933 ):他们考察了常见数据集(C4、RefinedWeb、Dolma)里各个 URL 的技术限制(robots.txt)和法律限制(ToS),结论是限制逐年增加。
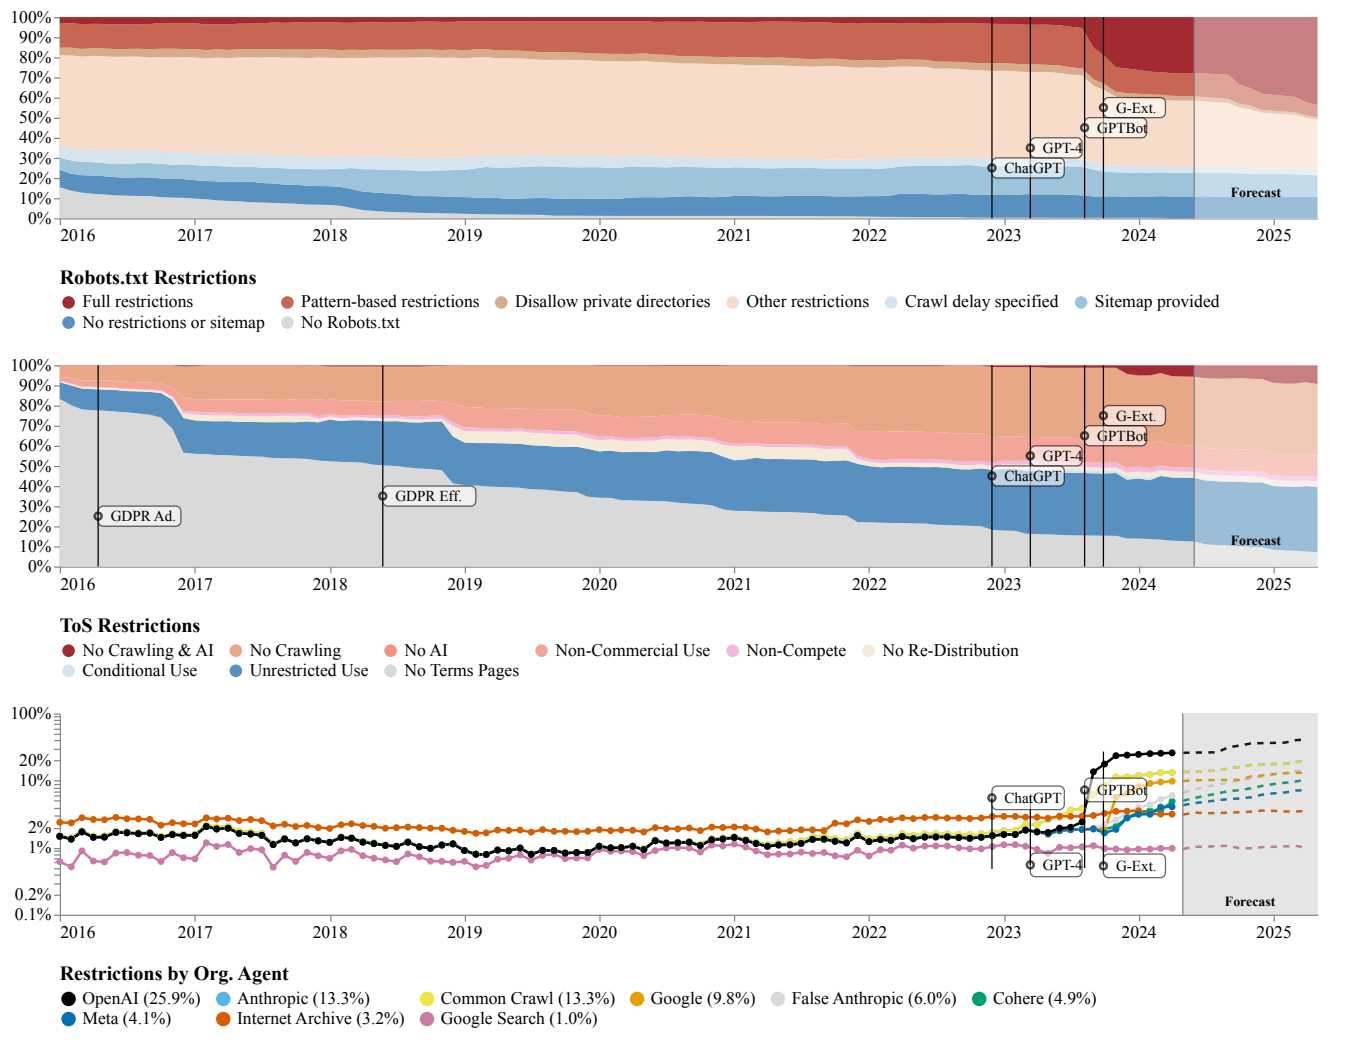
Percy 指着图中的红色区域说:robots.txt 这一栏,一直到 2023 年都相当平稳,然后在 2023 年中突然之间,有完全限制的网站比例涨到了接近 50%。ToS 那边趋势类似:2016 年基本没人往页面上放条款,现在绝大多数页面都放,而且大多数条款写着不能用于 AI。所以结论是——即便 2020 年你能爬整个互联网,今天"你能合法爬的互联网"实际上小得多。
4. 爬虫不是好公民时,以及影子图书馆
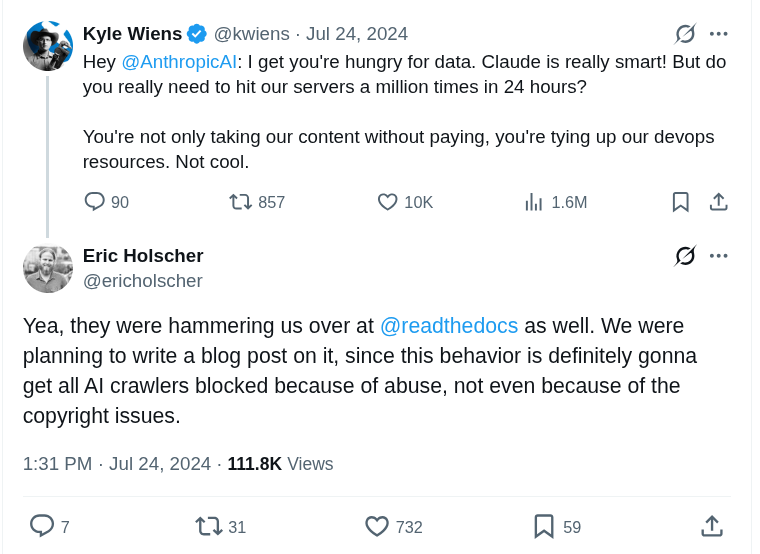
当然,这些只是准则(guidelines),有意或无意地违反它们是会发生的。Percy 举了一个具体事件:有一条推文在抱怨 Anthropic 的爬虫 24 小时内打他们的服务器一百万次;Read the Docs 也发文说被同样地反复捶打。他指出这里有意思的地方在于——在讨论版权之前就已经有问题了:违反 ToS、违反 robots.txt,或者仅仅是产生巨大的服务器负载。负载是要花钱的(hosting 的人出钱),而且会拉低所有其他用户的服务质量。
再往后才是版权,Percy 说这是"另一整罐复杂的虫子”。而在版权之前,还有一类东西必须提:影子图书馆(shadow libraries)。它们技术上也是 web 的一部分,例子包括 Library Genesis(LibGen)、Z-Library、Anna’s Archive、Sci-Hub。它们完全无视版权、绕过付费墙:有人把海量通常受版权保护、需要付费的书籍和论文收集起来免费提供。围绕它们有过很多下架令和诉讼,在某些国家被封,但通常会被绕过——服务器开在别的国家就行。支持者辩称这是把本就该自由获取的东西变为自由获取;但从法律角度看,这就是盗版和版权侵权。规模上:LibGen 在 2019 年约有 400 万本书,Sci-Hub 在 2022 年约有 8800 万篇论文。
这一段的总结是:互联网是个巨大、混乱、还有点吓人的地方,你不可能真的拿到全部;技术上和法律上都有对"你能访问什么数据"的限制。Percy 开玩笑说,下次再有人跟你说"我在整个互联网上训练",你就可以把这些都讲给他听。
5. 版权法的基础:什么可版权、保护多久
现在进入第二个问题:什么数据是你能合法使用的。Percy 说这个问题至今没有完全解决,但过去一年有不少进展。
法律框架是知识产权法(intellectual property law),它的立法精神是激励(incentivize)智力产品的创造。他提醒要记住这一点:法律的精神不是技术上对一切说不,而是激励创造。知识产权的形式包括 copyright(版权)、patents(专利)、trademarks(商标)、trade secrets(商业秘密)。和语言模型数据最相关的是版权。
版权法的历史可以回溯到 1709 年的英国(Statute of Anne),那是政府和法院第一次为了"激励创新与创作"这个目标去规制版权。美国的现代版权主要由 **1976 年版权法(Copyright Act of 1976)**定义。保护对象是"以任何有形表达媒介固定下来的原创作品(original works of authorship fixed in any tangible medium of expression)"。
Percy 挑了几个容易被忽略的要点。不是所有东西都能被版权保护:合集(collections)不可版权,比如电话簿,除非在挑选或编排上有创造性。而且版权保护的是表达(expression)而非思想(idea)——你不能对快速排序算法本身主张版权,只能对快排的某个实现主张。1976 年还有一件重要的事:取得版权的门槛被大幅放松,从 1909 年的"发表(published)“改成了"固定(fixed)"。这意味着版权保护不需要注册,这和专利截然相反——专利要花大钱去申请。你往网站上放个东西,它就自动受版权保护了。真要起诉别人时才需要去注册,而注册只要 65 美元,相对于律师费可以忽略,所以门槛依然极低。
另一个关键数字是期限:版权持续 75 年,之后过期,内容进入公有领域(public domain),任何人都能自由使用。所以历史上很多人的伟大作品都在公有领域里。背后的逻辑是:创作者创作时你要保护他一段时间,但 75 年后,大概已经不值得保护了,或者作者本人已经不在了,继续保留版权就没有意义。
于是得到一句总结:互联网上几乎所有东西都受版权保护。那是不是意味着训练任何数据都构成侵权?不一定。
6. Fair use 四要素,与 Google Books 判例
使用受版权保护的作品有两条路:(一)取得许可(license),或者 (二)援引合理使用(fair use)。
许可来自合同法,是许可方(licensor)授予被许可方(licensee)的一个承诺——用 Percy 的话说,“一个许可本质上就是一句’我不告你’"。最值得一提的许可是 Creative Commons,它让受版权保护的作品表现得像是处于公有领域,实现受版权作品的自由分发。例子包括 Wikipedia、Open Courseware、Khan Academy、Free Music Archive、Flickr 上的 3.07 亿张图、MusicBrainz 的 3900 万张图、YouTube 上的 1000 万个视频等等。CC 由 Lessig 和 Eldred 在 2001 年创建,目的就是在公有领域与现行版权之间搭桥——否则创作者想让人自由使用,也只有一个"等 75 年"的选项。
另一条路是付费买许可。Percy 指出模型开发者和内容平台之间已经有大量这类交易:Google 与 Reddit、OpenAI 与 Shutterstock(六年协议)、OpenAI 与 Stack Exchange。
如果你不想付钱,那就只能援引 fair use(版权法第 107 条),这就复杂了。Fair use 有四个判断因素,而且都不是硬规则,只是倾向,真打起来要在法庭上权衡:
- 使用的目的与性质(purpose and character)。用于教育比用于商业更容易被认定为合理使用;做了转化(transformative)比原样复制更容易被认定。
- 原作的性质(nature of the work)。事实性作品比虚构作品更容易被认定——你写一页二战史实,受到的版权保护就远小于一首高度创造性的诗。
- 使用部分的数量与实质性(amount and substantiality)。用片段好过用整部。
- 对原作市场(或潜在市场)的影响。如果你提供一个替代品、减少了原作者本可获得的收益,这被视为不利;但如果你做了转化、进入了一个新市场,就更有利。
Fair use 的经典例子:你看了一部电影然后写一篇摘要;你重新实现一个算法(思想)而不是复制代码(表达)。还有一个著名判例是 Authors Guild v. Google:Google Books 让你看到受版权书籍的片段,这件事争议极大,因为你在再分发他人的版权作品——这场官司打了 11 年(2002–2013),最终判 Google 胜诉,这也是 Google Books 今天能存在的原因。Percy 说这个判决为此后"语言模型训练是否属于 fair use"的思考设下了先例。
他特别点出一个对 ML 听众比较新的要点:版权不只是关于逐字记忆(verbatim memorization)。很多论文聚焦在逐字记忆上,但那只是侵权的一种方式,不是唯一方式。例如情节和角色本身可以是受版权保护的——你可以对"哈利·波特"这个角色主张版权,而不只是某一本书。当然有例外:戏仿(parody)——你造出一个看起来像衍生品的东西,但只要是在拿它开玩笑,反而更容易被认定为合理使用。所以,版权是关于语义的,绝不是关于 n-gram 重叠的,同时也关于经济。
7. 从复制到训练:语言模型的处境,以及 ToS 这一叠加层
把版权法落到语言模型上,Percy 列了四点。
第一,复制数据这件事本身——甚至还没谈训练——就已经可能是侵权了,因为 copyright 这个词里就写着 copy。第二,训练一个模型直觉上带有转化色彩(transformative flavor),它显然不同于把另一部作品重新托管一遍,而是在做某种转化。第三,模型训练在某种意义上是在把数据当作手段去提取一般性的想法——学习世界如何运作,而不是复制具体的表达(他要的是"巫师"这个概念,不是《哈利·波特》这本书)。第四,无论版权如何,语言模型确实可以影响市场——这会打击 fair use 的第四条(Percy 说这一条本来就比较滑)。
然后他补上一个容易被忽略的层次:即便你有许可、或者能援引 fair use,还有 ToS 挡在前面。例如 YouTube 上的视频有很多是 CC 授权的,但 YouTube 的服务条款禁止用 bot 去下载、也就是禁止抓取。所以限制是多层叠加的。
8. 诉讼全景:NYT、Anthropic 的 15 亿美元、Meta
Percy 快速扫了一遍法律版图。2023 年,纽约时报起诉 OpenAI,主张对方用他们的新闻文章做了训练,并给出了证据——他们能提示 ChatGPT 生成一篇几乎逐字相同的新闻文章。他不认为这个案子已经了结。
针对 Anthropic 的案子(Bartz、Graeber 等人诉 Anthropic,2024)指控其盗版了数百万本书并在这批书上训练 Claude。2025 年的简易判决给出一个标志性结论:就这一具体情形而言,训练原告的作品属于 fair use。但是——Anthropic,你仍然有麻烦,因为你盗版了所有这些书,这是不行的。Percy 特意点出这里的关键:这跟训练毫无关系,仅仅是盗版这个事实(本身也不是什么新鲜事)就是违法的。
有意思的是,Anthropic 其实也买了书并扫描了。法院说扫描是允许的:你买一堆书、把装订拆掉、扫描、数字化自用,这是 fair use。但这不能洗刷你此前盗版的罪——你不能先盗版、再买下来、然后说"刚才那件事就当没发生过”。结果是 Anthropic 付了 15 亿美元与作者和解,换算下来大约每本书 3000 美元。
针对 Meta 的案子(Kadrey、Silverman 等人诉 Meta)指控其用原告的书训练——而且如我们后面会看到的,这件事其实是被 Llama 论文自己暴露的。判决紧跟在 Anthropic 之后,结论是:是的,训练属于 fair use;但他们还 torrent 了一些书,那部分仍在审理中。Percy 判断,如果先例成立,这对 Meta 也不会是好消息。
他给出三条小结:到目前为止,训练这件事被认定为 fair use,或者至少没有被认定为非 fair use;但这些判决都相当窄,不等于"在任何版权内容上训练都是 fair use”,只是在这些具体案件里没问题。盗版书则明确违法(他说这个我们本来就知道)。而这仍然是一个高度活跃、不断演变的领域。
课堂问答(第一轮)
第一个问题问的是语音数据和 ElevenLabs。Percy 答:他对这个不太了解,可以课下聊。(这条没有信息量。)
第二个问题更有意思:如果我拥有一份资产,我原本给的是 CC 许可,我能不能后来改得更严格、禁止某些用途?时间在其中的角色是什么?我能训练在许可更宽松的旧版本上吗? Percy 先声明自己不是律师,然后回答:第一个许可下你仍然是被允许训练的。但许可证通常不只适用于一份固定的文档集合——以 Reddit 为例,内容在持续产生,改许可意味着此后新增的内容你不能训了。这是一个"随时间二分"的答案:已经释放出去的宽松授权收不回来,但授权变更之后的增量受新条款约束。
9. 原始原料:Common Crawl 与它的三种形态
版权这一大块讲完,Percy 转向"实际被用在模型里的数据集",并说他会一路回溯到 2019 年。但在此之前,得先把最底层的原料讲清楚。
大多数模型开发者都有自己的爬虫,因为他们要对数据有完全的掌控。不过对剩下的人来说有个好消息:Common Crawl 这个非营利组织从 2007 年就开始干这件事了。它大约每月跑一次全网爬取,每次新增 30 到 50 亿个网页;各次爬取之间有一定重叠,但他们会努力做多样化、去拿新的页面。网站上写着"至今累计 3000 亿个页面"——Percy 当场对这条数据提了个疑:把每次的 30-50 亿乘上 20 也到不了 3000 亿,但这就是他们官网的说法。至于全网到底有多少 URL,那很难估计,量级在数十亿以上;按 Google 自己的说法,Google 的搜索索引至少是 100 PB。单次 dump 的规模可以看得很具体:2026 年 4 月的这次爬取有 21.9 亿个网页,372.2 TB(注意这还不含图片,主要是文本)。
爬取在概念上很直白,魔鬼全在实现里。Common Crawl 用的是 Apache Nutch。流程就是图遍历:从一堆 URL 出发,从队列里弹出一个、下载它、把页面里所有超链接加回队列,一般是在多台机器上并行做。
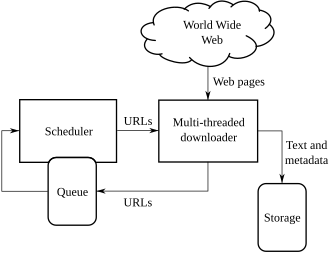
Percy 说这里有大量设计决策要考虑。选择策略(selection policy):哪些页面该下载。礼貌策略(politeness policy):遵守 robots.txt、别把服务器压垮。重访策略(re-visit policy):多久去检查一次页面有没有变——你需要一个能频繁检查高变化页面、又不把时间浪费在从不变化的页面上的策略。还有两个结构性难点:URL 是动态的,同一个 URL 可能因为浏览器状态不同而给出不同内容;同时大量不同的 URL 会指向基本相同的页面,不谨慎的话会产生巨量重复(镜像站就是显式地做重复)。
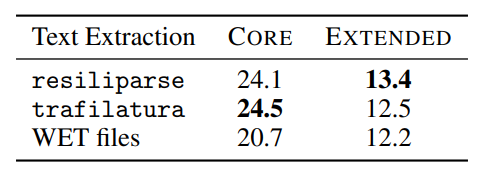
Common Crawl 的 dump 有两种格式。WARC 是原始的 HTTP 响应(你发一个 GET、带一个 URL,回来的那个响应就是它)。WET 是转换成纯文本之后的版本,而这是个有损过程。Percy 强调:这个转换过程本身就会影响下游任务的准确率。做 HTML→text 有很多工具,包括 trafilatura 和 resiliparse;DCLM 论文做过一个消融,比较"直接用 Common Crawl 发布的 WET 文件"和"用这些工具自己转",结论是工具更好:
Percy 还提醒一件常被忽略的事:依赖通用网页爬取,等于假设"web 是一个均匀的地方,你随机取到它的一部分就是你的数据集"。但事实不是这样——web 上存在一些特定的、质量极高的内容口袋。他挑了三处来讲:Wikipedia、GitHub、arXiv。
10. 三个高价值的口袋:Wikipedia、GitHub、arXiv
Wikipedia 创立于 2001 年,截至 2026 年 5 月有 6700 万篇文章、361 个语言版本(英语、西班牙语、德语、法语最常见)。它并不包含所有内容:不允许原创思想,不能有个人观点、推广内容、个人网页;同时有条目是基于**关注度(notability)**的——需要有可靠来源的重要报道,不是谁都能有个维基条目。所以在某种意义上你可以说 Wikipedia 不含任何"网上还没有的东西"——但 Percy 说这其实不成立,因为它可以引用书籍,而那些书你并不容易拿到。“Wikipedia 真好。”
写内容的是谁?任何能上网的人都可以编辑,破坏行为(vandalism)由管理员回退——Percy 说这件事在他眼里至今仍像个奇迹。和其他同伴生产(peer production)系统一样,少数维基人贡献了大部分工作,比如 Steven Pruitt 有 500 万次编辑。另一个对训练至关重要的性质是:Wikipedia 每隔几周做一次定期 dump,把整个 Wikipedia 打包成漂亮的 TAR 文件供下载。这意味着你不需要爬 Wikipedia——事实上他们不希望你爬,希望你去下载。这比爬好得多。
然后是本节课最漂亮的一个反面案例:Wikipedia 是可以被投毒的。你可能会想,破坏行为会被回滚,攻击者做点手脚马上就被撤销。但 Carlini 等人(Poisoning Web-Scale Training Datasets is Practical ,2023)意识到:dump 是有固定节奏的。所以你可以在 dump 即将发生之前进去编辑,dump 照常产出,之后你的编辑被回滚——但 dump 里已经留下了恶意内容。而一旦你能往网页里注入东西,就有工作表明(Concealed Data Poisoning Attacks on NLP Models ,2020)你能让模型对任意触发短语(比如 iPhone)赋予负面情感。Percy 的结论是:只要你考虑对手的存在,即便是所谓的高质量内容也可能含有坏东西。他说这个问题后来已经被修掉了。
GitHub 则是代码的宝库,而代码不只为编程能力服务,也为通用推理服务(讲义里标注这是 folklore,即经验之谈)。GitHub 是 2008 年创立的代码托管活服务(2018 年被微软收购),截至 2026 年 5 月有 4.2 亿个以上仓库,其中 2800 万个是公开的。每个仓库不是一个文件,而是一个带提交历史、issue、pull request、评论的目录。代码里重复极多——抄代码、fork 都会带来重复。GitHub 的立场是:你可以训练在任何带宽松许可(如 MIT、Apache)的公开仓库上。
这里有个重要的二分:GitHub 上有两类数据。一类是仓库本身,你可以通过 git 协议下载——Percy 特别强调,你不该去爬 GitHub 网站,而该直接下载仓库。另一类是元数据:issue、pull request、评论等等,这些通过 GitHub Archive 提供,它是这条事件流的每小时快照——Percy 说这数据非常有意思,基本上是 GitHub 上每一条评论、每一个 star、每一个动作都被记录了下来。此外还有一个非营利组织 Software Heritage(2016 年成立),专注于保存仓库而非元数据,并把 GitHub、GitLab、Bitbucket、PyPI 等聚合起来;截至 2026 年 5 月有 2880 万个源文件。代码当然不只出现在 GitHub,GitLab、Bitbucket 这些较小的实体也在其中。
arXiv 就简述了:从 1991 年起让研究者免费分享论文,最初是物理,现在涵盖数学、CS、统计等;约 300 万篇投稿,每篇有元数据、PDF 和可选的 LaTeX 源码。Percy 说,听到这里你就该开始想了:“在 arXiv 上训练"到底是什么意思? 这是不清楚的——你得把 PDF 转成文本,或者用那堆 LaTeX 文件。arXiv 不是同行评审,但有轻量的审核流程;作者可以选择保留所有权利、或者采用 Creative Commons(比如 CC-BY),所以许可状况其实相当清晰。元数据(标题、摘要)本身就在宽松许可(CC0)之下,你可以不管怎样都用;然后你再去看那些采用 CC 许可的论文,下载下来用。他认为大部分 arXiv 论文是 CC 的。同样地,arXiv 也不需要爬,直接从 Amazon S3 批量下载。
课堂问答(第二轮)
这一轮有两个问题。第一个问:模型生成的数据(synthetic data)在使用上有什么限制? Percy 的短答是:大概是可以用的(probably yes),详细的他后面会讲——而他在 Nemotron-CC 那一节确实展开了。
第二个问题切中要害:既然网上有大量盗版书的站点,你怎么保证这些东西不进入你的爬取结果? Percy 的回答是坦率的——你没法保证。这类问题正是困难所在。Common Crawl 里很可能就含有你不该训练的受版权保护的书籍和内容,这时你能做的就是回过头援引 fair use。他提醒说,记住一切都是有版权的:书和你的网站没有本质区别,两者都受版权保护。可能一本书的作者真去打官司时保护得更好(因为它被正式出版了),但性质上是一样的。
11. 数据集编年史(上):从 BERT 到 GPT-3
接下来 Percy 按时间线走过真正被用来训练的各个数据集,起点是 2019 年前后的 BERT。
BERT(2018):训练数据就是 Wikipedia 加 Books。那个"Books"是什么?有一个叫 Smashwords 的网站(2008 年创立)让任何人自己出版电子书,2024 年有 15 万作者、50 万本书。2015 年有一篇论文把 Smashwords 上免费的书扒下来做成了一个语料(BooksCorpus)——那是"还没人关注这些事的纯真年代”。这份语料在学术社区里被用了很多年,后来因为违反 Smashwords 的服务条款被下架。Percy 借这个例子点明一个原则:免费可得不等于合法可用。BooksCorpus 的具体规模是 7000 本书、9.85 亿词。BERT 还有一个值得记住的设计:它的序列是文档(documents)而不是句子——在此之前所有语言建模研究都聚焦在句子上(对比对象是 1 Billion Word Benchmark,用的是机器翻译来的句子)。
GPT-2(2019):他们想要高质量的网络内容。那时大家已经知道 Common Crawl,但 Common Crawl 的数据太乱。于是他们想出一个聪明的替代指标:去看那些从 karma 大于等于 3 的 Reddit 帖子里链出去的目标页面——“好帖子一定会链接到好网站”。这样抓到了 40 GB 文本、800 万个页面,即 WebText。他们从未发布这份数据,但有一个开放的复现版本 OpenWebTextCorpus(从 Reddit submissions 数据集里抽取全部 URL,用 Facebook 的 fastText 分类器过滤非英语,再去掉近重复),被广泛使用。
CCNet(2019):由当时的 Facebook 开发,目标是用自动化的方式构造大规模高质量预训练数据集,特别关注低资源语言(比如乌尔都语)——所以他们不想要一套只对英语有效的手工流程。它的组件是:去重(基于轻量归一化去掉重复段落)、语言识别(跑 fastText 语言 ID 分类器,只保留目标语言)、质量过滤——这里的想法是保留那些在语言模型下"看起来像 Wikipedia"的文档,他们用了一个在 Wikipedia 上训练的 KenLM 5-gram 模型给新文档打分。注意这与 GPT-2 的"Reddit 外链"是同一类思路的不同实现。结果是:训练 BERT 时,CCNet(CommonCrawl) 反而超过了只用 Wikipedia,因为你能拿到多得多的数据。CCNet 这个名字既指开源工具,也指论文发布的数据集。
C4(2019,Google):这篇论文更出名的是 T5 模型,它推行"把世间所有 NLP 任务都变成 text-to-text"的想法;但其实这篇超长报告的一大贡献是 C4 数据集。当时的观察很明确:Common Crawl 大部分不是有用的自然语言——你要么用小而高质量的数据集,要么用一堆垃圾的 Common Crawl,而任何直接在 Common Crawl 上训练的尝试都只会得到垃圾结果。此前已经出现了 Reddit 思路和"像 Wikipedia"的语言模型思路,C4 用的是第三种思路:干脆定义一堆规则,结果出乎意料地有效。
具体规则包括:保留以标点结尾、且至少有 5 个词的行;删掉少于 3 句话的页面;删掉包含任何"坏词"的页面(用的是 LDNOOBW 那个著名的英文脏词表);删掉含 {、lorem ipsum、terms of use 等内容的页面——其中去掉花括号这一条有趣的地方在于它过滤掉了大量代码,可见当时他们完全没在想代码模型;再用 langdetect 按 0.99 的英语概率阈值过滤非英语。原料是 Common Crawl 2019 年 4 月的单个快照,14 亿 tokens。产出是 806 GB 文本、1560 亿 tokens,比 GPT-2 拿到的 40 GB 大得多。
后来有分析(arXiv 2104.08758 )检查了 C4 里到底有哪些网站:
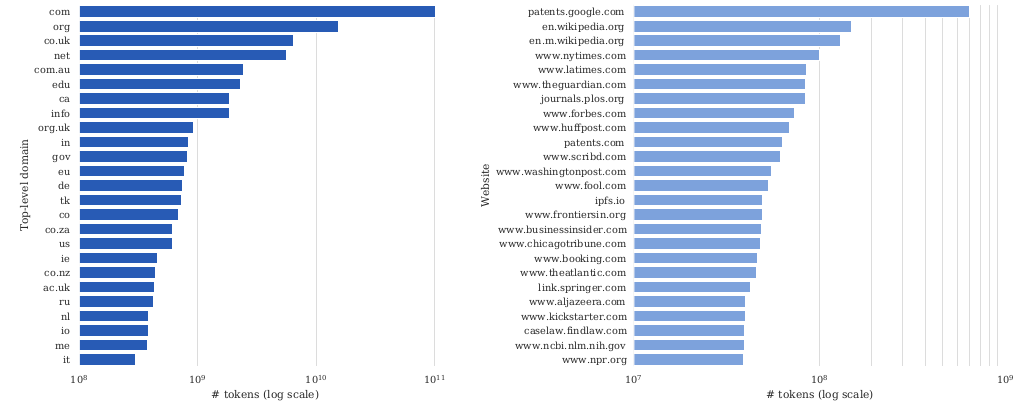
C4 还附赠了一个 WebText-like 数据集:同样按"Reddit 里 karma >= 3 的帖子中的链接"去过滤页面,用了 12 次 dump 才拿到 17 GB 文本。对比 WebText 的 40 GB,Percy 指出这个落差说明Common Crawl 是不完整的、并没有包含全部网页——如果它什么都覆盖到了,你应该能触及 40 GB。用这份数据在当时的多项 NLP 基准(GLUE、SQuAD 等)上取得了提升。
GPT-3(2020):数据集由 Common Crawl(经处理)、WebText2(WebText 用更多链接扩展而来)、Books1 与 Books2(讲义原文标注为"(Mysterious) Internet-based books corpora",即来源成谜的互联网书籍语料)、Wikipedia 构成。注意 Common Crawl 与 WebText 之间有重叠,但 WebText 在某种意义上是一个更有针对性的分布。产出是 570 GB 文本、4000 亿 tokens。Common Crawl 的处理方式是:训练一个质量分类器,去区分 {WebText, Wikipedia, Books1, Books2} 与其余内容;同时做模糊去重(fuzzy deduplication),把 WebText 和基准测试集的重复也一并处理掉。GPT-3 这篇论文之后,“用分类器做质量分类"这条路线被继承了下去。
12. 数据集编年史(中):The Pile、Gopher 与 LLaMA 的坦白
GPT-3 出来之后是一大事件,出现了一批试图在开放侧做同样事情的努力。
The Pile(2020/2021,EleutherAI) 是其中最早的之一,而且是一个草根式(grassroots)的协作项目——一群人在 Discord 里一起鼓捣、共同摸索高质量数据源。最终他们筛出了 22 个高质量领域,规模是 825 GB 文本(约 2750 亿 tokens)。Percy 说这份清单到今天看依然相当有意思、相当多样:
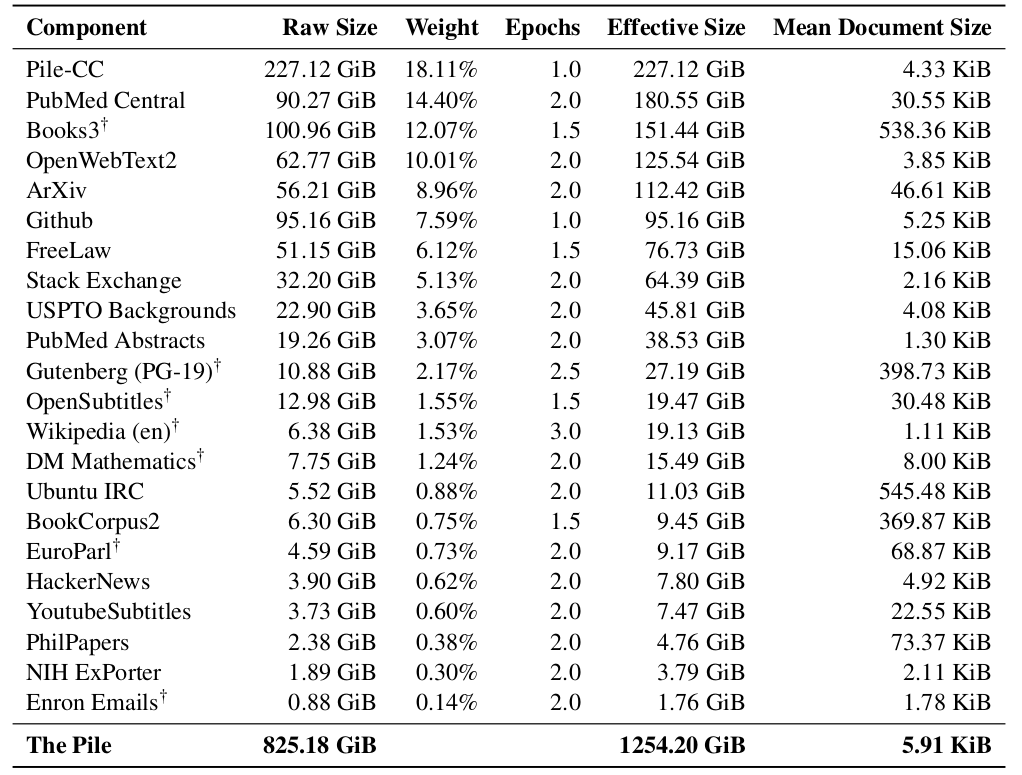
其中几项值得单独记。Pile-CC 用的是 Common Crawl 的 WARC 而非 WET,用 jusText 转成文本(讲义标注:比 WET 好)。PubMed Central 有 500 万篇论文——NIH 资助的工作被要求公开,这构成了这批数据的法律基础。arXiv 用的是 LaTeX。Enron 邮件:Enron 在 2002 年破产,全部邮件在调查中被公开,共 150 个用户的 50 万封邮件,这是少数几份我们能拿到的邮件数据集之一——Percy 评价说作为邮件样本这个分布挺怪的,但有什么就用什么吧。
Project Gutenberg 始于 1971 年(Michael Hart 想增加文学的可及性),2025 年约 7.5 万本书、以英语为主,只收录已获得版权许可的书(多数在公有领域)。由它打包出来的 PG-19 是"2019 年之前的 Gutenberg 书籍”——Percy 说这大概是其中的大部分,因为要进入公有领域你至少得等 75 年。
Books3 则是个有意思的数据集:19.6 万本书,来自一个叫 Bibliotik 的影子图书馆,里面包含 Stephen King、Min Jin Lee、Zadie Smith 等人的书。它出现在 The Pile 里,然后——Percy 在这里停了一下,说他要花点篇幅讲清楚这件事——它被下架了,原因是版权侵权和诉讼。他特别指出,当时是 2020 年,还是没人关注,人们就拿它训模型。
Stack Exchange 大家大概用得很熟(虽然 Percy 说因为 AI 的缘故如今用的人可能少了)。它是用户贡献的问答合集,从 2008 年的 Stack Overflow 起家,扩展到数学、文学等主题;用声望值和徽章来激励参与。这份数据有一条有趣的特性:它的格式是问答,非常接近真实应用。通常人们把预训练数据想成 Wikipedia 文章那样的原始文本,但 web 上有一部分其实看起来就像监督数据,就是你本来想问语言模型的那类东西——Percy 认为这或许能帮模型学到某些问答行为。所以并非一切都是神奇地"涌现"出来的,这类数据本来就存在于网上。此外它有投票数等元数据可用于过滤,同样以 XML dump(已匿名化、含元数据)的形式发布,不用爬。
Gopher 与 MassiveText(2021,DeepMind):模型本身从未发布,并且被 Chinchilla 取代了;但 Percy 说这篇论文对数据的描述非常好,值得一读,除却那些"他们不告诉你数据里有什么"的部分。MassiveText 由 MassiveWeb、C4、Books、News、GitHub、Wikipedia 组成——后面四项的获取方式没有任何说明。MassiveWeb 的过滤步骤是:保留英语、去重、处理 train-test 重叠;质量过滤用人工规则而非分类器(例如"80% 的词至少含一个字母字符"这种规则);用 Google SafeSearch 而不是词表来处理毒性。结果是 10.5 TB 文本——但 Gopher 只训练了其中 300B tokens,也就是 12%,考虑到名字里有"Massive",这个实际使用比例相当讽刺。Percy 由此点出一个贯穿全讲的张力:用规则的人和用分类器的人分成了两派,Gopher 属于规则派,理由是他们想要更多掌控。
LLaMA 1(2022):Percy 说这是一篇相当好的论文,因为它详细交代了自己的数据处理——很可能是最后一批"完全公开讨论数据处理"的非开源模型之一。它的构成是:Common Crawl 经 CCNet 处理,但分类的目标换成了"这个页面是不是 Wikipedia 的引用来源"——思路是 Wikipedia 文章本身可能太风格化了,而 Wikipedia 引用的那些站点应该是好东西;再加 C4(更有多样性,毕竟是规则过滤的)、GitHub(只保留宽松许可、按人工规则过滤)、Wikipedia(2022 年 6–8 月、20 种语言、人工过滤)、Project Gutenberg 与 Books3、arXiv(去掉了注释、内联展开的宏和参考文献)、Stack Exchange(28 个最大站点,答案按得分排序)。总计 1.2 万亿 tokens。
然后 Percy 讲了一个后果链,值得完整记下来。Books3 真的给 LLaMA 带来了大麻烦,因为他们等于向全世界公告"我训练了这份数据集"。而你往回追就会发现:它来自 The Pile,The Pile 里那份又来自一个影子图书馆。这就是为什么现在人们不愿意谈数据了。 他们没有发布这份数据集,但描述足够详细,于是被 Together 复现成了 RedPajama v1。而 RedPajama v1 最初同样包含 Books3,后来才被剔除。Percy 的总结是:早期关于版权的那些决定,会产生相当大的余波(watershed)——一个数据集在 2020 年被随手拼进来,会让 2023 年的复现者、2024 年下游使用者都被牵连。附带一提,Cerebras 的 SlimPajama 是 RedPajama v1 用 MinHashLSH 去重后的 627B 子集。
13. 规则派与分类器派:RefinedWeb、FineWeb、Dolma
RefinedWeb(2023) 想论证一个更激进的立场:网页数据就够了(web data is all you need)。前面讲的 GitHub、arXiv、Stack Exchange 都是专门化来源,RefinedWeb 问的是:如果我只守着 web 会怎样?他们的工程做得不错:用 trafilatura 做 HTML→text 并抽取主体内容(用 WARC 而不是 WET);过滤沿用 Gopher 规则,基本上是"保留看起来像英语的东西";值得注意的是,他们在当时明确表示要回避基于 ML 的过滤,以避免引入偏见——不想找到一个过于狭窄的 web 子集;再做基于 5-gram 的 MinHash 模糊去重。总共有 5 万亿 tokens,发布了其中 6000 亿。
FineWeb(Hugging Face) 起初是 RefinedWeb 的复现,但把它改进了:用了 95 次 Common Crawl dump;做 URL 过滤和语言识别(保留英语概率 p(en) > 0.65 的);过滤叠加 Gopher 规则、C4 规则和更多人工规则;MinHash 模糊去重;对邮箱和公网 IP 做匿名化(PII)。结果是 15 万亿 tokens——Percy 说从这个数字就能看出数据集的规模在快速膨胀。
Dolma(2024,AI2) 是另一个多来源合集:
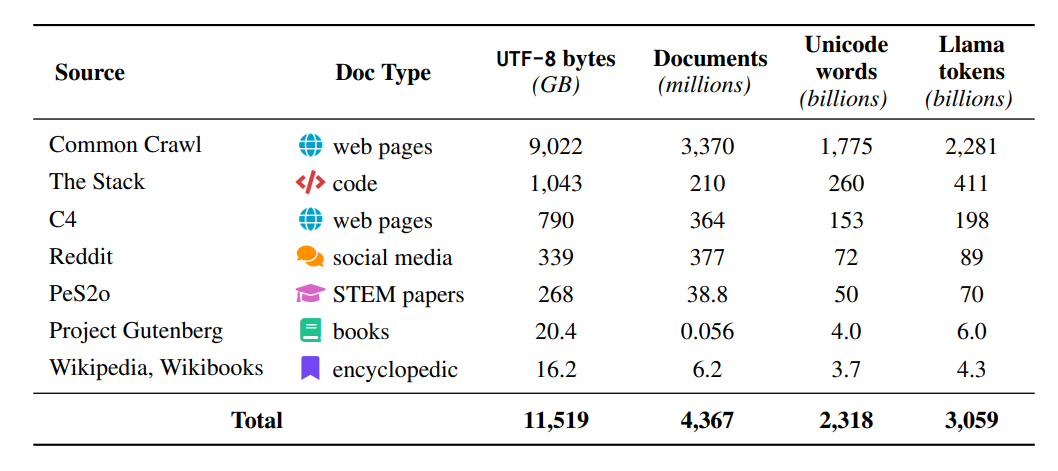
Percy 逐项讲了它的成分。Reddit 数据来自 Pushshift 项目(2005–2023),帖子和评论分开收录——他说那会儿你还能拿到这些数据,在一切被锁上之前。PeS2o 是从 Semantic Scholar(AI2 自己的学术论文爬取)派生的 4000 万篇论文。此外还有 C4、Project Gutenberg、Wikipedia/Wikibooks。
它的 Common Crawl 处理流程很能体现 Dolma 的立场:语言识别用 fastText 分类器(这是基于模型的),但质量过滤坚持用 Gopher 和 C4 规则、回避基于模型的过滤;毒性过滤同时用规则和 Jigsaw 分类器;去重用 Bloom filter。结果是 3 万亿 tokens。
到这里,Percy 做了一次阶段性归纳:我们看过了一堆五花八门的过滤方法,但它们在高层次上看起来非常相似。你拿一份网页爬取,然后决定:我要用规则过滤,还是用模型过滤。如果用模型,你就得先决定"什么看起来是好数据",训练一个分类器,给所有文档打分,然后选择。而这其中存在一个取舍:你可以把整个 Common Crawl 都留下来——能得到 240 万亿 tokens——但那大概会非常低质;你也可以只要一万亿 tokens。某个甜蜜点在这两者之间。
14. 模型过滤的胜利与合成数据的入场:DCLM 与 Nemotron-CC
DCLM 大约是这个"基于模型的质量过滤"真正成为主流的节点。DataComp 最初的动机是定义一套标准流程,让人们能在一个统一的框架下尝试不同的数据处理方法并比较结果;但 Percy 说,人们实际主要是在用它发布的那份数据集去训模型、做别的事。
他们处理 Common Crawl 得到 DCLM-pool(用 resiliparse 抽取),这份数据是完全未过滤的——240 万亿 tokens,Percy 说这大概超过任何人真正训练会用到的 token 数。但其中大量内容质量很低,所以他们有一条流水线把它层层过滤:
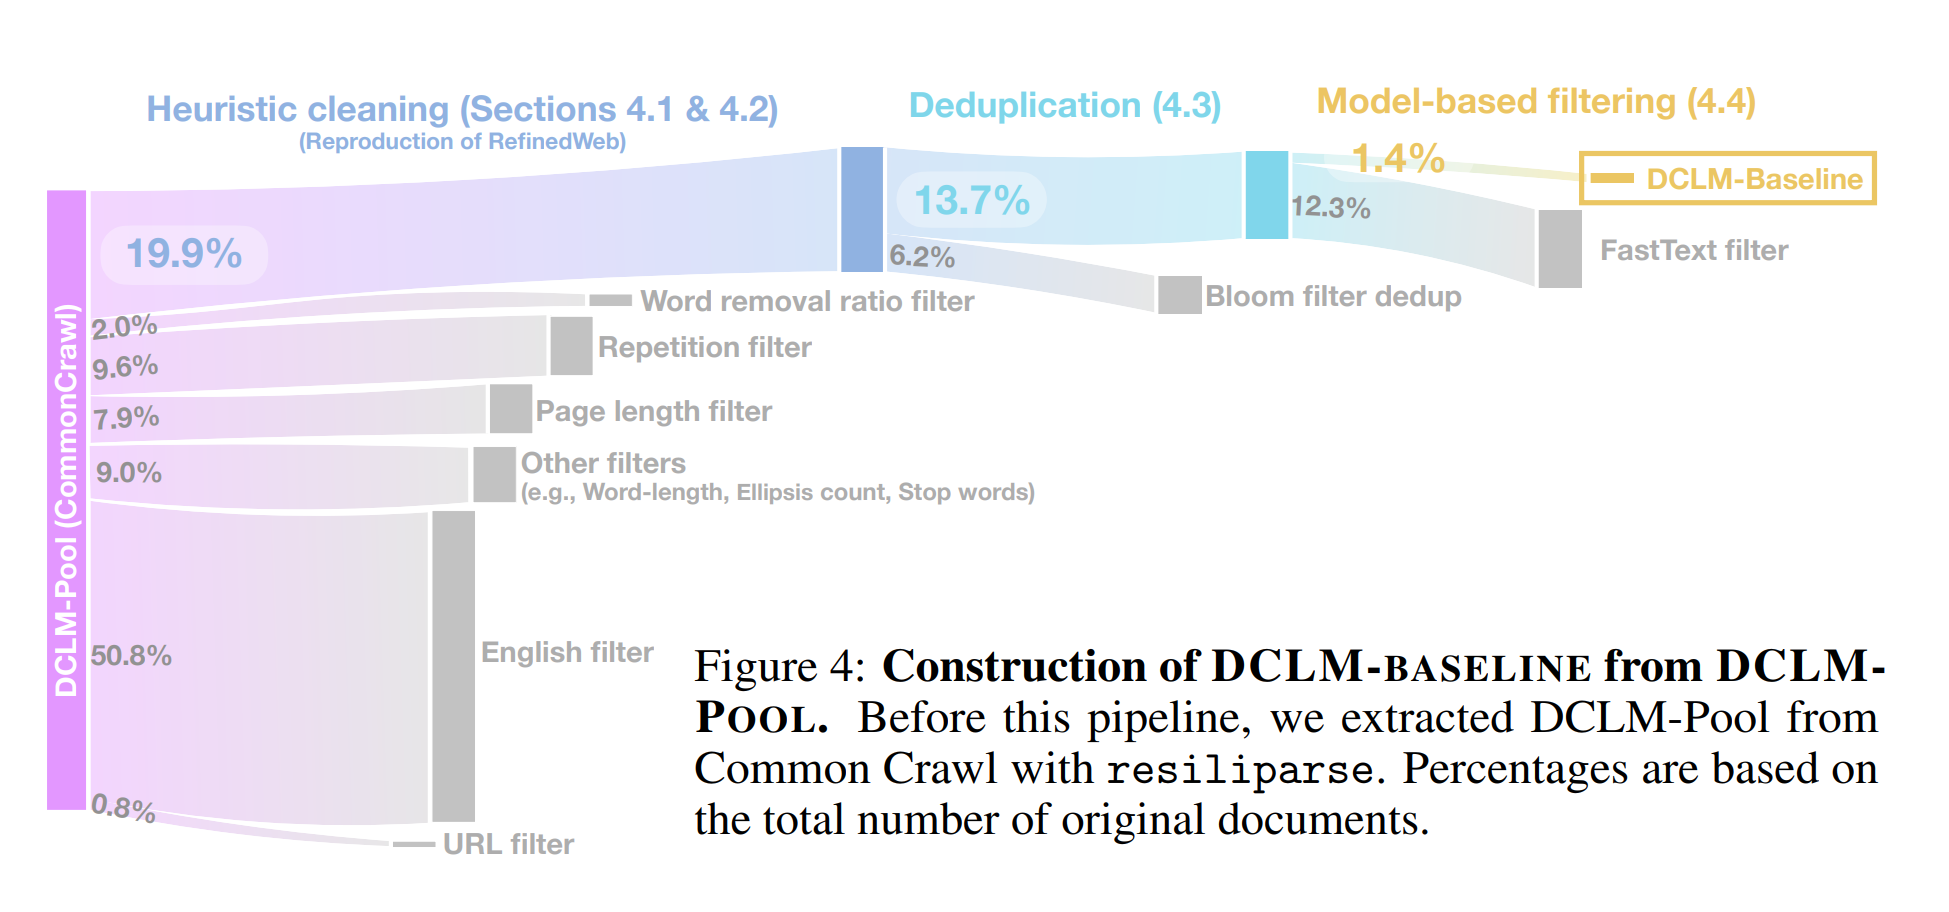
这张图信息量很大:英语过滤一步就去掉了 50.8%(说明 DCLM-pool 里非英语内容占了一半),而最后的 fastText 模型过滤只占 12.3 个百分点,但它带来的是"质"的改变。最终 DCLM-Baseline 是原始 pool 的 1.4%。
模型过滤器的训练方式是本节的焦点,因为它在某种程度上"奇怪地有效"。正例 20 万条来自两个来源:OpenHermes-2.5(基本上是用 GPT-4 生成的指令数据)和 ELI5(r/explainlikeimfive 这个 subreddit 上各种"给我讲明白"式的提问与回答)。负例 20 万条来自 RefinedWeb——回忆一下,那只是"一个过滤得非常宽松的 web 版本",基本上就是 web 本身,它有 3.8 万亿 tokens。用这些数据训一个 fastText 分类器(Percy 让大家把它理解成就是一个线性分类器),拿它去跑遍整个 DCLM-pool。结果是这个"魔法般"的质量分类器打败了他们试过的其他一堆方法:
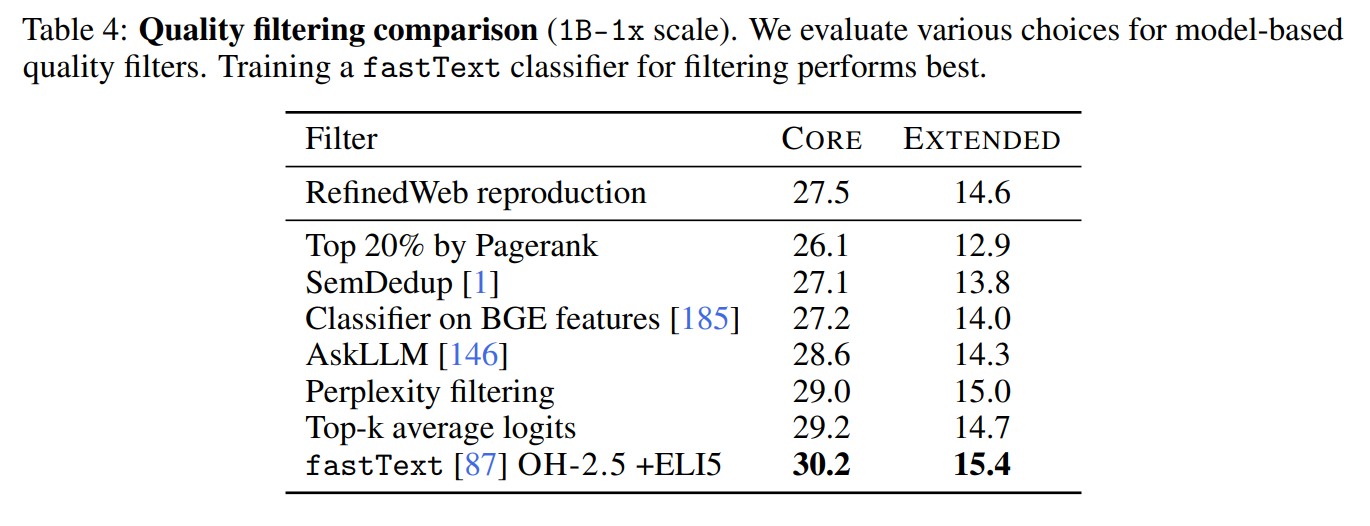
Percy 说 DCLM 在一段时间里成了开放社区做质量过滤的金标准。
Nemotron-CC(NVIDIA) 则是对 DCLM 路线的一个反击:DCLM 过滤得太激进了,它把绝大部分数据都删掉了。你最后只剩 3.8 万亿 tokens。可是我们需要更多 token,怎么办?他们的答案是做一套更精巧的组合。分类器集成(classifier ensembling):一条路是提示 Nemotron-340B-instruct 去给 FineWeb 文档按"教育价值"打分,再蒸馏成一个更快的模型;另一条路就是直接用 DCLM 的分类器。合成数据重写(synthetic data rephrasing):对那些被分类器判为低质量的文档,用语言模型把它们改写得更像 Wikipedia;对那些高质量文档,则用语言模型生成各种任务——比如给定一篇 Wikipedia 文章,生成问答对,或者让模型"请总结这份文档"“从中抽取关键信息”。Percy 说这大概是最早几份真正拥抱合成数据做预训练的数据集之一。
顺带一个工程细节:他们的 HTML→text 用了 jusText 而不是 trafilatura,理由很朴素——jusText 返回的 token 更多。最终结果是 6.3 万亿 tokens(其中高质量子集 1.1T),比 DCLM 大得多。而且他们证明了这套数据更好:
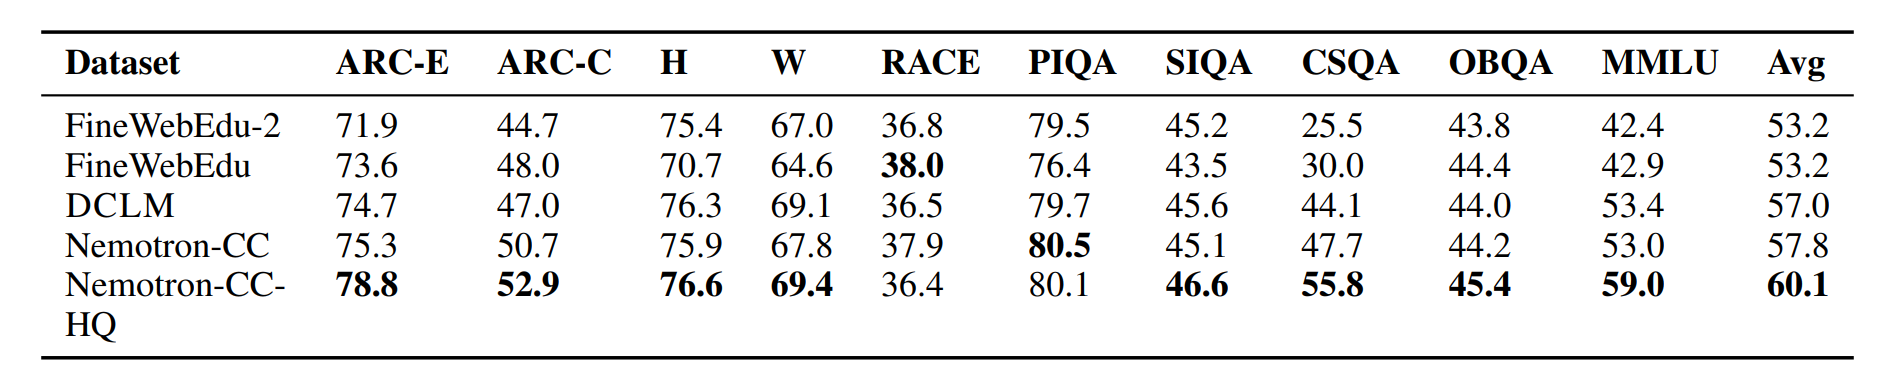
Percy 给了一个参照系:即便如此,6.3 万亿在网络规模面前依然算小——Llama 3 训练在 15 万亿 tokens 上,Qwen3 训练在 36 万亿上。他同时提醒一个看论文时的陷阱:这些数字里有多少是唯一 token 并不清楚,语言模型论文数 token 时常常把重复的也算进去——如果你跑两个 epoch,token 数就翻倍了。看这些数字时必须小心。
15. 代码数据:The Stack 与 The Stack v2
讲完网页数据,Percy 转向代码数据,并说这一块在 2022 年就已经很清楚会非常重要。
The Stack v1 的做法是:从 GitHub Archive(2015–2022) 取仓库名单,git clone 了 1.37 亿个仓库,共 510 亿个文件(其中 50 亿是唯一的),用 go-license-detector 只保留宽松许可(MIT、Apache)的,再用 minhash 和 Jaccard 相似度去掉近重复,最终得到 3.1 TB 代码。(顺带一提,口碑转写在这里把 “137 million repositories” 漏成了 “137 repos”,讲义原文的 137M 才是对的。)
The Stack v2(2024) 是一次大幅扩张。它纳入了 GitHub Archive 里的 issue、评论、PR,仓库则来自 Software Heritage,还通过爬取网站获得了文档(PyPI、npm、devdocs.io 等),并加入既有数据集(GSM8K、代码竞赛、Stack Overflow、arXiv、Wikipedia、OpenWebMath)。处理上要解决一堆脏活:仓库里有你不想要的二进制文件要删、有恶意软件要清、PR 里大量是 bot 产生的要过滤、还要去重、做 PII 脱敏、对 PR 做下采样以保持代表性并控制数据集规模。
其中有一个 Percy 说"我觉得很妙"的设计:世界上编程语言极不均衡,Python 和 C 的语料很多,而像 Nim 这种低资源语言(他说他之前甚至没听说过)语料很少。他们的做法是把这些代码编译成 LLVM 这一低层中间表示,然后把低资源语言源码和它的中间表示并排放置——这样语言模型就能学到"有大量数据的共享低层表示"到"数据稀少的那个语言"之间的映射。这正是"低资源语言也吃到了高资源语言的迁移"的一个干净例子。
PR 的处理还有一个非平凡的问题:PR 及其元数据本质上不是线性序列,所以必须想办法把它线性化成 token 序列。其中一个关键决策是提供多少上下文:一个事件可能只是"我改了一行代码",但为了让模型学到这件事,你大概需要给出周围几行的上下文,或者整个文件里围绕这个 diff 的部分。这些线性化的设计决策直接决定了模型最终看到的是什么。
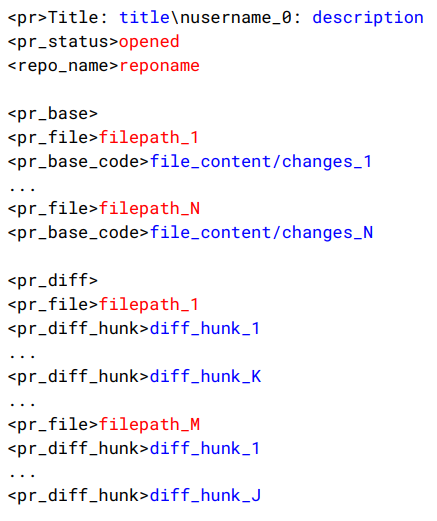
<pr> 标题与描述、<pr_status>opened、<repo_name>,然后是 <pr_base> 段列出各文件的基线内容 <pr_file> / <pr_base_code>,最后是 <pr_diff> 段列出 <pr_file> 下的各个 <pr_diff_hunk>
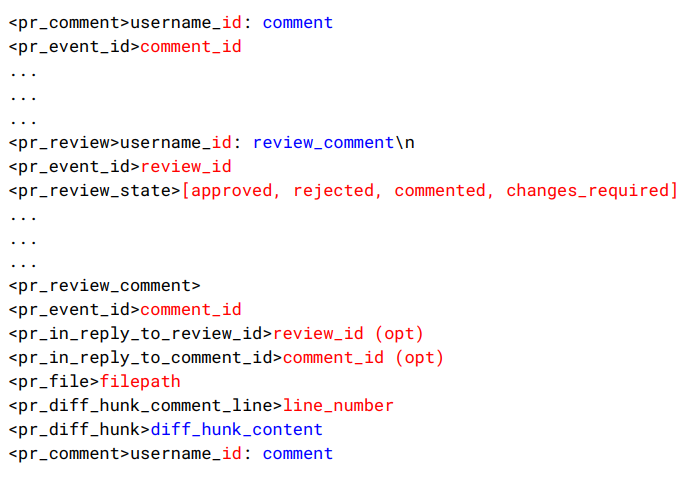
<pr_comment>(用户名与评论内容)、<pr_event_id>、<pr_review>(评审总评)、<pr_review_state>(取值 approved / rejected / commented / changes_required)、以及行内评审评论 <pr_review_comment> 下的 <pr_in_reply_to_review_id>、<pr_in_reply_to_comment_id>、<pr_file>、<pr_diff_hunk_comment_line>、<pr_diff_hunk>、<pr_comment>
Percy 说,最终喂给模型的 token 就是这种 XML 式的结构化数据。所以模型学到的不只是怎么生成代码,还包括围绕代码的那套软件开发流程——谁在什么时候评论了什么、这次评审的状态是什么。
16. Common Pile:只用宽松许可数据能走多远
最后一块是 Common Pile。Percy 先把前提重述一遍:互联网上几乎所有数据都受版权保护;其中一部分是宽松许可的;还有一部分甚至在公有领域;而 fair use 这条退路并不稳固。所以如果你极度厌恶风险,你的判断标准就会是:只要我不知道它行不行,那就是不行。Common Pile 正是采取这个态度做出来的项目。
它要回答的问题是:只用宽松许可的数据,你能训出一个好模型吗?或者说,你能走多远? 于是他们去搜罗互联网上所有可能有训练价值、又确实采用宽松许可的数据。成分包括 Stack V2 的代码、大量政府文书(这类东西意外地很多是宽松许可的)、wiki、部分新闻站点、学术论文、在线论坛、公有领域作品、教育资源等等。最终有 8 TB——对于"只用宽松许可"这个约束来说,这个量其实相当可观。
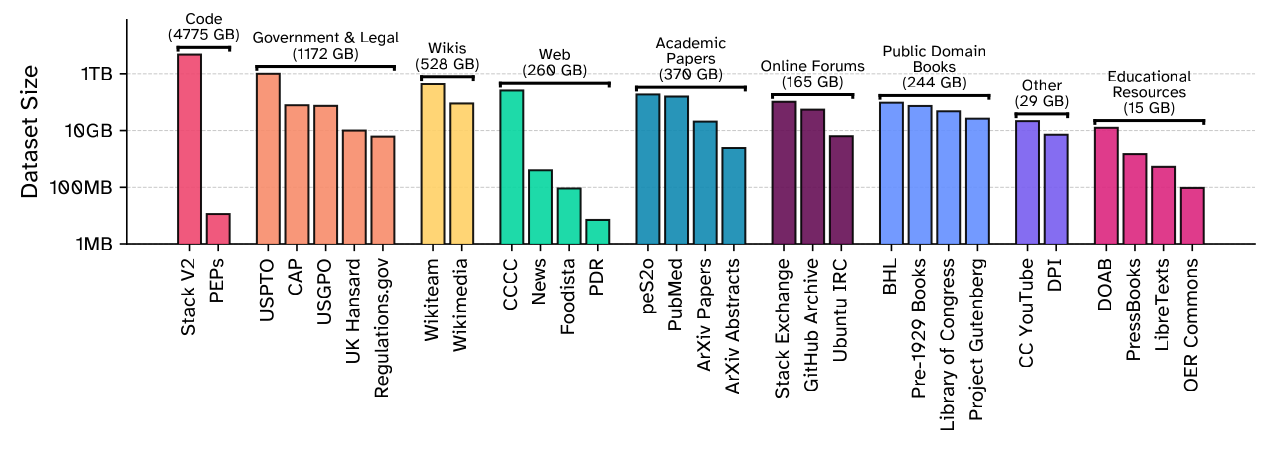
Percy 强调,做这件事比听起来难得多。不是"看一下许可、噢 Apache 或 CC,好,收下"这么简单,里面有不少微妙之处。
第一个是许可洗白(license laundering):人们对许可很马虎,可能拿一份受版权保护的作品,随手贴一个 CC BY 上去。任何人在互联网上都能写这个标签,你很难分辨它是不是真的。
第二个是合集许可(collection licenses)不等于个体作品许可。这里有一个很常见的误解:比如 Dolma 本身是宽松许可(ODC-By)的,但合集的许可不会延伸到其中的个体作品。所以你不能在 Hugging Face 上看到一个数据集标着宽松许可就放心——很多这类数据集你往下深挖,会发现在个体层面根本不是宽松许可的。
第三个决定是放弃任何合成数据,理由是在未授权数据上训练出来的语言模型,其产出算不算干净是说不清的。Percy 在这里做了一个很坦率的自我批评:技术上讲这些模型是 MIT 许可的开放权重,你可以随便用;但这些语言模型自己多半也是在未授权数据上训出来的——如果你真的诚实一点,这有点像数据洗白(data laundering)。
那么效果如何?他们把这套数据和一批模型对比:
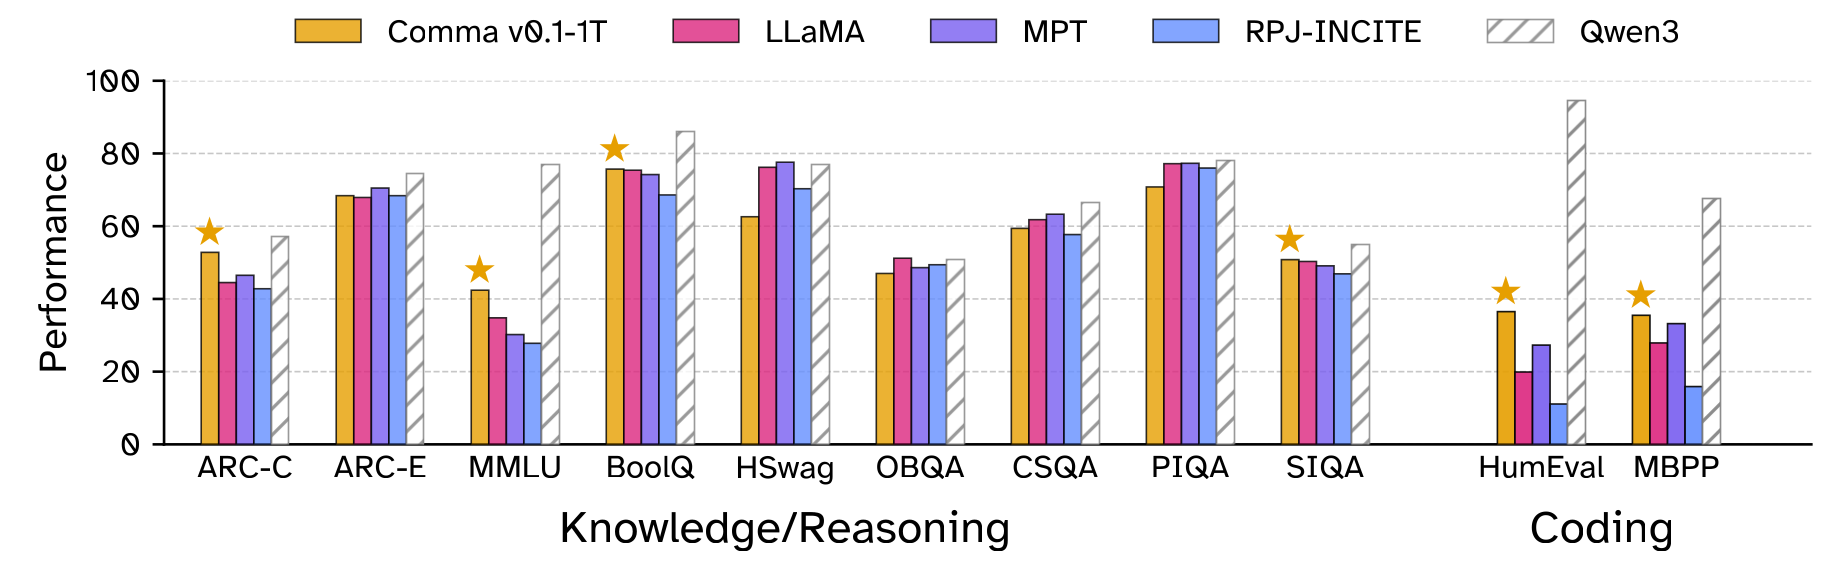
Percy 的读法是:这个结果不算差。它肯定不如 Qwen 系列,但确实超过了那些非常老的模型(2023 年前后的 Llama 1、MPT 之类)。他的结论是:你可以做得还算体面,但如果 token 量上不去,仍然很难有竞争力。不过他补了一句:这不会是这件事的最终答案,如果你更努力地挖掘,应该还能从公开发布的宽松许可内容里再榨出更多。
17. 总结
Percy 的收尾强调了一件事:希望现在你对"数据是一个非常丰富的主题"有了感受。数据不是从天上掉下来的,也不是去 Hugging Face 上下一个数据集就完了。数据一定有个来源。 而且数据所处的语境既是技术的,也是社会的——在最上游,互联网是一堆活着的服务;必须有人去做"生产原始数据"这件事,无论是网站主动提供 dump,还是有人去造爬虫。然后必须有人做决策:如何把它处理成可用的形式——过滤、变换、去重,而这些全都影响最终语言模型的质量。
他把最重的一票投给了过滤:怎么从 200 万亿 tokens 走到不到 3 万亿 tokens? 这是一个巨大的削减,值得投入大量注意力。数据是区分不同语言模型的关键成分——大家的架构大体是同一类 Transformer,但数据取决于你怎么处理,能拉开相当大的差距。
他也承认这个领域的软肋:围绕数据的法律和伦理问题非常多,远超一节课能覆盖的;而且这个流程非常混乱。不同于这门课其他部分那种更有"第一性原理"味道的内容,数据处理目前很大程度上是靠感觉(vibes)搭起来的——你定义一个分类器、你定一条规则、你设一个阈值。这既是问题,也意味着改进的空间很大。Percy 直接把作业四抛了出来:做作业的时候,想想有没有更好的做法,这可能就是一个研究方向。
下一讲他会继续讲数据,重点转向后训练数据,以及更多关于过滤的内容。
18. 拓展阅读 / 参考资料
关键论文(按时间线)
| 论文 | 时间 | 要点 | 链接 |
|---|---|---|---|
| Aligning Books and Movies (BooksCorpus) | 2015 | 从 Smashwords 扒下免费自出版书籍构成的书语料,后因违反 ToS 被下架 | arXiv |
| BERT | 2018 | 首次用"文档而非句子"作序列;数据就是 Wikipedia + BooksCorpus | arXiv |
| GPT-2 / WebText | 2019 | 以"Reddit karma >= 3 帖子的外链"作为质量代理,40GB / 800 万页 | OpenAI PDF |
| OpenWebTextCorpus | 2019 | WebText 的开放复现,用 fastText 过滤非英语并去近重复 | 项目页 |
| CCNet | 2019 | 用 Wikipedia 上训练的 KenLM 5-gram 给文档打分;CCNet(CommonCrawl) 训练效果超过纯 Wikipedia | arXiv |
| T5 / C4 | 2019 | 规则过滤路线:标点、5 词、删花括号(顺带过滤代码)、langdetect,产出 806GB / 1560 亿 tokens | arXiv |
| C4 分析 (Dodge et al.) | 2021 | 审计 C4 的域名构成与内容问题 | arXiv |
| GPT-3 | 2020 | 500+GB / 4000 亿 tokens;首次用质量分类器 + 模糊去重处理 Common Crawl;Books1/Books2 来源成谜 | arXiv |
| The Pile | 2020 | 22 个领域的草根拼盘,825GB / 2750 亿 tokens;含 Books3 与 Enron 邮件 | arXiv |
| Gopher / MassiveText | 2021 | 10.5TB 里只用了 12%(300B tokens);坚持人工规则而非分类器 | arXiv |
| LLaMA 1 | 2023 | 1.2T tokens;因公开承认用 Books3 而引发后续风波;被 RedPajama v1 复现 | arXiv |
| RefinedWeb | 2023 | 主张"web 数据就够了";trafilatura + Gopher 规则 + MinHash 去重;5T 中发布 600B | arXiv |
| Dolma | 2024 | 多来源合集 3T tokens;语言识别用 fastText、质量过滤回避模型 | arXiv |
| DCLM / DataComp-LM | 2024 | 240T 的 DCLM-pool 经流水线压缩到 1.4%;fastText 质量分类器(OpenHermes+ELI5 为正例、RefinedWeb 为负例)成为金标准 | arXiv |
| Nemotron-CC | 2024 | 反 DCLM 的激进过滤;LLM 判教育价值 + 合成数据重写;6.3T tokens | arXiv |
| The Stack | 2022 | 1.37 亿仓库 / 510 亿文件,仅留宽松许可,得 3.1TB 代码 | arXiv |
| The Stack v2 | 2024 | 纳入 PR/issue/文档,用 LLVM IR 给低资源语言做迁移,PR 线性化为 XML 式序列 | arXiv |
| Consent in Crisis | 2024 | 量化 robots.txt 与 ToS 限制随时间的增长,指出"可合法爬取的互联网"在快速缩小 | arXiv |
| Poisoning Web-Scale Training Datasets is Practical | 2023 | 利用 Wikipedia 定期 dump 的节奏,在被回滚前把投毒内容写进 dump | arXiv |
| Concealed Data Poisoning Attacks on NLP Models | 2020 | 让模型对任意触发短语(如 iPhone)赋予负面情感 | arXiv |
| OLMo 2 | 2025 | 全流程透明的开放模型,本讲用它解剖预训练/中训练的数据配比 | arXiv |
| Tulu 3 | 2024 | 后训练阶段的数据与流程参照 | arXiv |
| Common Pile v0.1 | 2025 | 只用公有领域与宽松许可数据构成的 8TB 语料,训出的 Comma v0.1-1T 不差但难以竞争 | arXiv |
| The Llama 3 Herd of Models | 2024 | 本讲开头引用的"数据章节只有一段话"的原始出处 | arXiv |
视频中引用的外部资源
- CS336 课程主页
— 课表与讲义索引;本讲是可执行讲义
lecture_13.py - lecture_13.py 讲义源码 — 本讲全部数字的精确来源(口述中的约数在代码里是确值)
- Common Crawl — 非营利全网爬取,2007 年至今;2026 年 4 月爬取公告 (21.9 亿页 / 372.2TB)
- Common Crawl 迁移到 Apache Nutch — 教材里讲的爬虫架构在工业界的实现
- NYTimes 的 robots.txt — 讲义用来演示"哪些 bot 被点名禁止"
- Consent in Crisis 项目页 — 含交互式的限制统计看板
- trafilatura · resiliparse — HTML→text 的两大工具,DCLM 消融证明它们优于 WET
- GitHub Archive — GitHub 事件流的每小时快照
- Software Heritage — 非营利的源代码归档,Stack v2 的仓库来源
- arXiv 批量下载(S3) — 讲义反复强调的原则:不要爬,去批量下载
- Wikipedia 定期 dump — 同理,官方提供打包下载
- Wikimedia 关于 Wikipedia 的统计 — 6700 万条目 / 361 个语言版本的来源
- Stack Exchange 全部数据 dump — 匿名化 XML,含投票等元数据
- Project Gutenberg · PG-19 — 只收录已获版权许可的书籍
- Books3 被下架的 Hugging Face 页面 — 讲义里"数据集会消失"的活证据
- Weird 上关于 Books3 之争的报道 — Books3 版权争议的来龙去脉
- OpenHermes-2.5 · ELI5 · RefinedWeb — DCLM 质量分类器的正负例来源,讲义都附了可浏览的样例
- FineWeb · RedPajama v1 · SlimPajama 说明 — 主流开源语料的下载入口
- Google 与 Reddit 的授权协议 · OpenAI 与 Shutterstock · OpenAI 与 Stack Exchange — 付费取得许可的三个实例
- Google 搜索如何组织信息 — “搜索索引至少 100 PB"的出处
- 美国版权局收费标准 — 注册费 65 美元的出处
- SDNY 对 Meta 案的判决报道 — “训练属于 fair use"这一判决的新闻报道
- Enron 邮件数据集 — The Pile 中那个"分布很怪"的邮件语料
关联主题
- 爬虫 Web crawler :本讲第 3、9 节的工程基础,选择/礼貌/重访三种策略是核心
- robots.txt :注意它不是法律机制而是行业惯例——讲义特意强调过这一点
- 影子图书馆 Shadow library :LibGen / Sci-Hub / Anna’s Archive 的谱系与法律状态
- 知识共享 Creative Commons :Lessig 与 Eldred 在 2001 年为填平"公有领域与现行版权之间的 75 年鸿沟"而设计
- 合理使用 Fair use :四要素在中文世界的对应概念是"合理使用”,注意中美制度差异
- 版权 Copyright :理解"表达而非思想"这条分界线,是判断训练行为性质的前提
- 公有领域 Public domain :75 年期限与 Common Pile 那 244GB 公有领域书籍的来源
- Anne 法令 Statute of Anne :1709 年,版权制度"为激励创作而设"的最初表述
- 1976 年版权法 :把保护门槛从"发表"改为"固定”、取消注册要求的那次修订
- MinHash :模糊去重的技术核心,RefinedWeb / FineWeb / SlimPajama 都用它
- Bloom filter :Dolma 用的去重结构,与 MinHash 是两代不同思路
- fastText :CCNet 的语言识别、DCLM 的质量分类器都是它——讲义说"就把它当线性分类器"
- WARC 文件格式 :与 WET 的区别是本讲一个反复出现的技术决策点
- LLVM :Stack v2 用它给低资源编程语言做迁移学习的锚点
- 训练数据投毒 Data poisoning :Wikipedia dump 节奏被利用的那类攻击的一般形式
- Apache Nutch :Common Crawl 使用的开源爬虫框架
- 个人可识别信息 PII :FineWeb 匿名化邮箱与公网 IP、Stack v2 做 PII 脱敏的动机
- 长尾问题 Long tail :Percy 用来解释"为什么数据永远是人类努力的瓶颈"的概念工具
术语表
| 术语 | 含义 | 参考 |
|---|---|---|
| Pre-training / Mid-training / Post-training | 三段式训练阶段;数据从"大量低质"走向"少量高质"。OLMo 2 的实例是 3.90T → 832.6B → 数 B 级 | OLMo 2 |
| Base model | 预训练加中训练之后的模型;口诀是"instruct/chat model 之前的那个"。趋势是越来越不发布 | Wikipedia |
| Live servers | 互联网的本质形态:一堆可以被连接的活动服务器。所以"训练整个互联网"在类型上就不成立 | Wikipedia: Web server |
| Crawler | 爬虫:从种子集出发发现并下载网页的程序。策略分选择、礼貌、重访三类 | Wikipedia |
| Deep web | 深网:不能靠"跟着超链接走"触及的内容,需要交互或认证才能访问 | Wikipedia |
| Walled garden | 围墙花园:Facebook/X/LinkedIn/NYTimes 这类内容锁在认证与付费之后的平台 | Wikipedia |
| robots.txt | 站点根目录下声明爬取许可的文件。讲义强调它是惯例不是法律,不遵守只是"不当好公民" | Wikipedia |
| ToS (Terms of Service) | 服务条款:访问即同意的合同,常写明禁止 bot 下载。它构成独立于版权的一层限制 | Wikipedia |
| Shadow library | 影子图书馆:绕过版权与付费墙的免费资源站,如 LibGen(约 400 万本书)、Sci-Hub(约 8800 万篇论文) | Wikipedia |
| Public domain | 公有领域:版权到期(75 年)后作品的状态,任何人可自由使用 | 中文 Wikipedia |
| Creative Commons (CC) | 让受版权作品表现得像在公有领域的许可体系;Wikipedia / OCW / Khan Academy 都用它 | 中文 Wikipedia |
| Fair use | 美国版权法第 107 条的合理使用抗辩,由目的、原作性质、使用比例、市场影响四要素权衡 | 中文 Wikipedia |
| Transformative use | 转化性使用:不是原样复制而是产生新目的/新市场,是 fair use 第一条的核心 | Wikipedia |
| Verbatim memorization | 逐字记忆:能复现训练原文。讲义强调它只是侵权的一种方式,版权还关乎情节、角色与语义 | arXiv 2202.07646 |
| Parody | 戏仿:看起来像衍生品但在拿原作开玩笑,更容易被认定 fair use | Wikipedia |
| License laundering | 许可洗白:把受版权作品重新发布在宽松许可之下,标签人人可写、难以辨别真伪 | Wikipedia |
| Common Crawl | 2007 年起的非营利全网爬取项目,约每月 30-50 亿页;单次 dump 约 372TB | 官网 |
| WARC / WET | WARC 是原始 HTTP 响应,WET 是转换后的纯文本(有损)。DCLM 消融证明用好工具自己转优于用 WET | Wikipedia |
| Deduplication | 去重:从段落级(CCNet)到模糊去重(MinHash / Bloom filter),是每条流水线的必备环节 | Wikipedia |
| Quality classifier | 质量分类器:先定义"什么像好数据",再训一个分类器给全部文档打分。DCLM 的 fastText 版本是标杆 | DCLM |
| fastText | Facebook 的轻量文本分类器。本讲里它同时充当语言识别器与质量分类器 | Wikipedia |
| Rule-based vs model-based filtering | 两大过滤流派。规则派(C4、Gopher、RefinedWeb、Dolma)理由是可解释、避免偏见;模型派(GPT-3、DCLM、Nemotron)理由是效果更好 | DCLM |
| DCLM-pool / DCLM-baseline | 240T 的未过滤池,与过滤到 1.4% 之后的成品 | DCLM |
| Synthetic data rephrasing | 合成数据重写:Nemotron-CC 用 LM 把低质文档改写得"更像 Wikipedia",并在高质文档上生成问答等任务 | Nemotron-CC |
| PII redaction | 个人可识别信息脱敏:FineWeb 做邮箱与公网 IP 的匿名化,Stack v2 也对 PR 做 PII 脱敏 | Wikipedia |
| Software Heritage | 2016 年成立的非营利源代码归档,聚合 GitHub/GitLab/Bitbucket/PyPI 的仓库(不含元数据) | 官网 |
| GitHub Archive | GitHub 事件流的每小时快照,提供 issue、PR、评论等元数据 | 官网 |
| ODC-By | 开放数据公共许可(署名版),Dolma 合集采用它——但不延伸至其中的个体作品 | Open Data Commons |
| Data laundering | Percy 对"用未授权数据训出的开放权重模型产出合成数据"这一循环的自我批评式命名 | Common Pile |
我的感想
(留空 — 看完后补充自己的理解、批判、联想)
待深入 / 疑问
- (记录不理解的地方、想进一步学习的方向)