视频: https://youtu.be/cKSwj_qZ8Jg | 频道: Stanford Online | 发布时间: 2026-04-15 时长: 1h26m21s | 播放量: 29,226 (记录时) | 分类: llm 主讲: Tatsunori Hashimoto(与 Percy Liang 合开 CS336 课程)
视频简介: 这是 Stanford CS336《Language Modeling from Scratch》2026 春季课程第四讲,主题是超越基础 Transformer 的两大"高级"架构改造。上半场讲注意力替代方案:从乘法结合律出发推导线性注意力,沿着"加门控"的路线走到 Mamba 2 和 Gated DeltaNet,再讲 DeepSeek V3.2 的稀疏注意力 DSA——这些技术让上下文成本从二次降到线性或近线性,并已在 MiniMax M1、Nemotron 3、Qwen 3.5、GLM 5 等生产级模型中大规模验证。下半场讲 mixture of experts(MoE):为什么"参数变多但计算量不变"是免费的胜利、路由器怎么设计、非可微的 top-k 选择为什么靠一堆负载均衡启发式就能训得动,最后以 DeepSeek V1 到 V3 的演化收尾。Tatsu 的核心信息是:这两个方向都已从研究玩具变成了业界共识,而 top-k 选择 + 辅助损失这对组合正在成为未来架构设计的通用原语。
1. 开场 / 引子
Tatsu 开场先交代了一点课程事务(这一讲的 slides 上传晚了,现在已经在课程网站和 GitHub 上),然后把这节课在整个课程中的位置摆清楚:上一讲讲的是基础 Transformer,以及如何微调它的各个部件得到一个现代语言模型;这一讲要讲的是他认为"复杂得多、也高级得多"的两项发展。第一项是注意力替代方案(attention alternatives)——通过架构层面的改造支持长得多的上下文,其中大部分方法能让计算量对序列长度线性依赖而非二次;第二项是 mixture of experts(MoE,专家混合)——前者改的是 attention block,后者改的是 MLP 部分,MoE 让模型在同样的计算开销下拥有多得多的参数,显著提升硬件利用率。
先说动机。所有人都在冲长上下文:你想往上下文里塞更多东西,让模型有更多知识,或者支撑一个要操作大量材料的 agent。把各家模型的上下文窗口按发布时间画出来(纵轴是对数坐标),能清楚看到顶级 LLM 厂商在竞赛式地扩张窗口,以支撑这些更复杂的工作负载。
但代价在另一张图里:随着序列长度增加,网络中 feed-forward 部分与 attention 部分的计算开销之比在不断变化。FFN 的开销起点很大,但只随序列长度线性增长;attention 是所有位置两两交互的 all-to-all 连接,二次增长,很快反超。过去在"大模型 + 短序列"的时代,FFN 是主导成本;序列一拉长,attention 日益成为问题的核心。
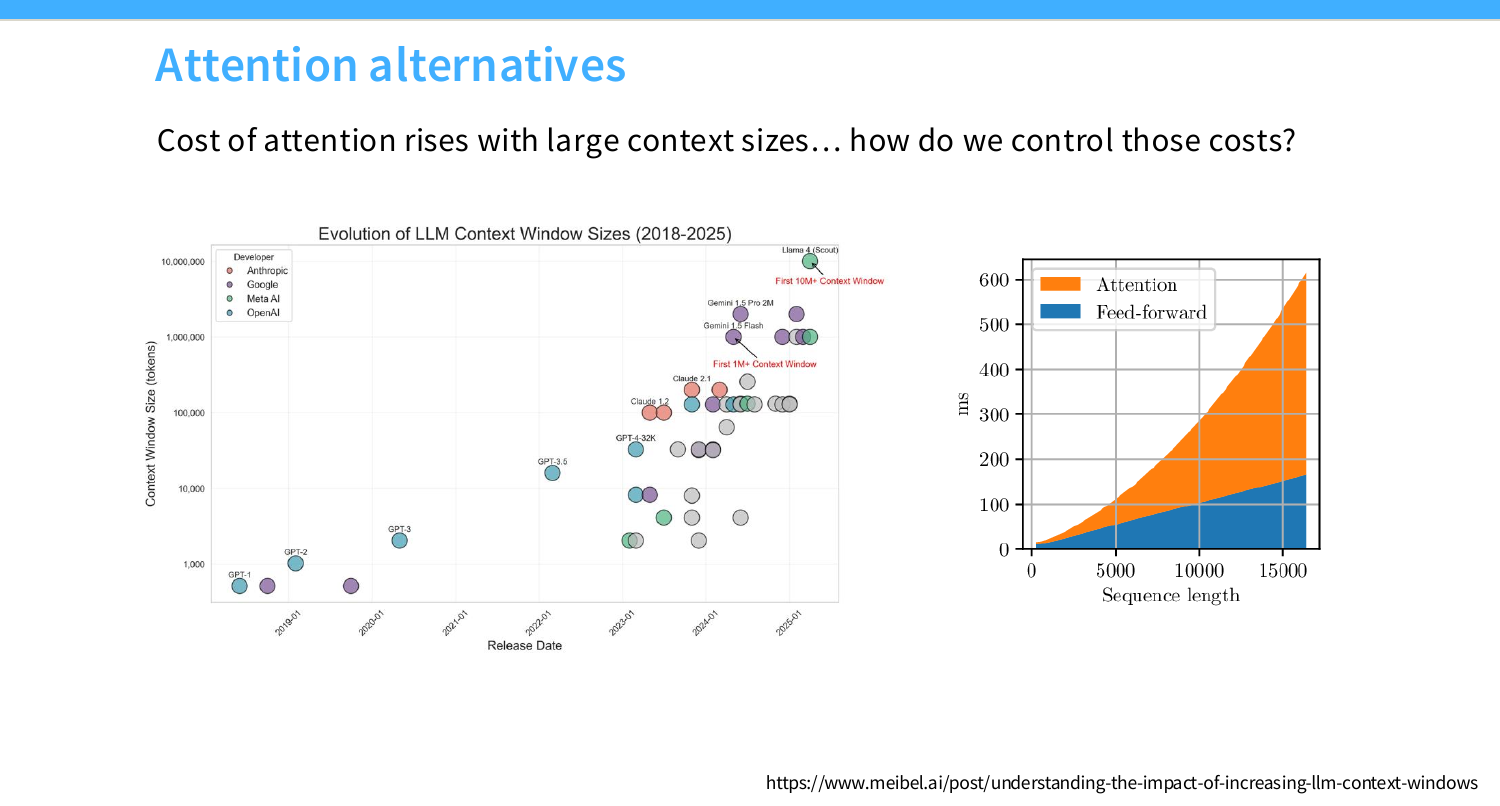
讲义右图把"反超"这件事标得很具体:序列长度约 5000 时 attention 与 FFN 的耗时大致持平,到 16K 时总耗时约 615 ms,其中 FFN 只占约 165 ms,attention 吃掉了剩下约 450 ms——三分之二以上的时间花在了那个二次项上。
对付这个问题的"基本工具箱"有两件。第一件是混合架构:把局部 attention(local attention,上一讲讲过的滑动窗口一类)和全局 attention 按各种方式混起来——如果每八层才做一次全局 attention、其余层都是很局部的 attention,成本就被大幅控制住了。第二件是系统工程。Tatsu 在这里特意敲打受经典理论训练的人:一个被严重低估的事实是常数因子真的、真的很重要。受经典理论化计算机科学训练的人容易觉得"重要的是大 O,线性还是二次",但对 attention 成本影响最大的事件之一是 FlashAttention——它本质上只是一个常数因子级的系统优化,把 attention 运算重排成对内存传输友好的形式,最小化 memory transfer 开销,却带来了"真正戏剧性"的改进。具体数字:基础 PyTorch 在较短序列长度上大约跑 30-40 TFLOPS,FlashAttention 直接带来两倍级别的提升;更妙的是,在某些序列长度下基础实现连显存都装不下了,而 FlashAttention 因为不再物化整个注意力矩阵,还能继续跑(虽然慢一些)。它没有解决任何二次复杂度问题——但常数因子非常、非常强大。(FlashAttention 的细节会在系统讲和系统作业里展开。)
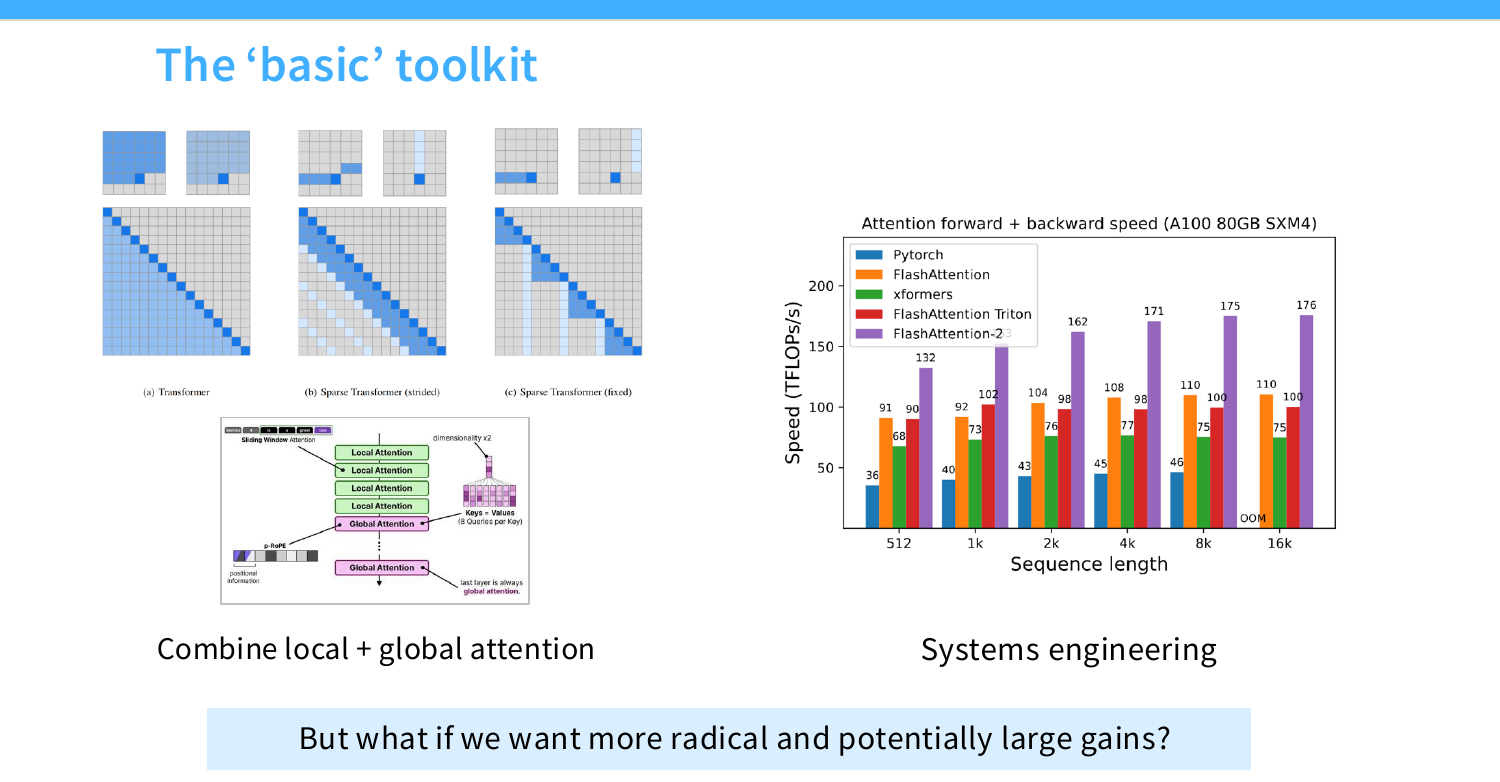
讲义右图把口述里一带而过的数字全标了出来(A100 80GB SXM4,前向+反向,单位 TFLOP/s,横轴为 512 / 1k / 2k / 4k / 8k / 16k):基础 PyTorch 实现是 36 / 40 / 43 / 45 / 46 / OOM——到 16k 直接爆显存;FlashAttention 是 91 / 92 / 104 / 108 / 110 / 110,正是 Tatsu 说的两倍到两倍半;xformers 68-77,FlashAttention Triton 90-102;而 FlashAttention-2 一路做到 132(512)到 176(16k),相对基础实现接近四倍。最能说明问题的是 16k 那一列:PyTorch 的柱子直接被标成 OOM,FlashAttention 系列却还稳稳跑在 110 和 176 上——同一个数学运算,只因为换了一种对内存友好的排布方式。
然而,如果目标是 500 万、1000 万 token,这些技巧可能就不够了,需要更激进、收益更大的方案。这就引出上半场的核心问题:能不能让注意力对序列长度线性依赖?那会长什么样?
Tatsu 补充了一个背景:多年来很多人试过很多东西,有不少 false starts;但最近两年左右,一批线性时间注意力的配方逐渐成形,并且在大规模生产环境中被 battle-test 过了——这是他第一次把线性注意力放进这门课的原因:现在可以确信这些东西在规模上、在生产里真的能行。
2. 上半场:线性注意力谱系
2.1 一个核心思想:乘法结合律
Tatsu 说,要理解所有这些行之有效的方法,起点只需要一个核心想法,后面全是在它之上的层层加工。这个想法是:矩阵乘法的结合律(associativity of multiplication)。
先用紧凑记号写出标准 attention。Q、K、V 各带矩阵维度($N \times d_k$、$N \times d_k$、$N \times d_v$,$N$ 是序列长度),运算是:
$$ \text{Attn}(Q, K, V) = \rho(Q K^\top) V $$$QK^\top$ 让全部 $N$ 个位置通过矩阵乘法两两交互,$\rho$ 是逐行 softmax 归一化,再乘 $V$ 得到输出。这一步的代价是 $O(N^2 d_k)$——问题就出在 $N^2$:上下文长度可以是百万级的。
现在做一个大胆的动作:暂时忘掉 softmax,把 $\rho$ 直接丢掉。没有了 softmax,整个式子就是三个矩阵连乘,结合律允许我们移动括号:
$$ (Q K^\top) V \quad \Longrightarrow \quad Q (K^\top V) $$只是移动了一下括号,但二次的部分被换掉了:先算 $K^\top V$,这是个 $d_k \times d_v$ 的小矩阵,总代价变成 $O(N d_k d_v)$。$d_k$、$d_v$ 原则上可以很大,但实际上就是几千、上万的量级——没有人的 hidden dimension 是一百万——所以相比 $N^2$ 项,这是好得多的依赖关系。这就是线性注意力(linear attention)。第一课要点:结合律可以改变对序列长度的依赖。
第二个观察让这个重排变得更有意思,也直接催生了后面几页要讲的一大批研究:重排后的 $Q(K^\top V)$ 看起来就是一个 RNN。把稠密形式改写成从左到右扫过上下文的增量形式:
$$ S_t = S_{t-1} + v_t k_t^\top, \qquad y_t = S_t q_t $$$S$ 是一个状态(state):把每一步的 $k_t v_t$ 外积增量式地"乘并累加"进去,输出时用 $q_t$ 去查询它。上面的稠密运算和这个 RNN 形式是等价的。RNN 有什么好处?推理时状态 $S$ 尺寸固定,一路往前传即可——推理特性极好;坏处是训练难以并行。而线性注意力的美妙之处在于两种形态随便用:训练用稠密矩阵乘形式(并行、GPU 友好),推理用串行 RNN 形式(状态固定、没有随上下文膨胀的 KV cache)——两全其美(best of both worlds)。
| 形式 | 用途 | 性质 |
|---|---|---|
| 稠密矩阵乘形式 | 训练 | 可并行,GPU 友好 |
| RNN 递归形式 | 推理 | 状态固定大小,无 KV cache 增长 |
课堂上马上有学生追问:并行形式和递归形式不是应该近似等价、性能略降吗?Tatsu 澄清了有损的一步到底在哪:真正 lossy 的是最开始"把 softmax $\rho$ 丢掉"那一步——完整 softmax attention 变成线性注意力是有损的;此后从线性注意力的稠密形式到 RNN 递归形式,等价是精确的。后面要讲的 Gated DeltaNet 等各种 recurrence 都属于"丢掉 softmax 之后"的世界。
另一个学生问了输出方程里的 $D v_t$ 项是什么。Tatsu 解释:你可能希望输出里也直接包含当前时间步的 value——当前 token 的 value 对下游可能直接有用——所以让 $v_t$ 像残差连接一样直通到 attention 输出,$D$ 是一个调制门,控制直通的量。
2.2 实战检验一:MiniMax M1 的 7:1 混合
朴素线性注意力真的能用吗?MiniMax M1 是一个规模相当大、性能相当强的中国开源模型,采用 7:1 混合——每七层线性注意力配一层完整 softmax attention。性能整体强劲,与 OpenAI o3、DeepSeek R1 等强模型相比具有竞争力;由于绝大多数层是线性注意力,对上下文长度的依赖大部分是线性的(不完全线性,因为还有那些 softmax 层,但增长温和得多)。这证明即使是这个非常简单易懂的基础版线性注意力,也能在规模上被有效使用——只要保留一些完整的二次连接。
Tatsu 在这里立了一块重要的界碑:至今没有人在大规模上证明过纯线性时间注意力可行。接下来讲的所有方法,全部是混合架构。
2.3 Mamba 2:给递归加一个遗忘门
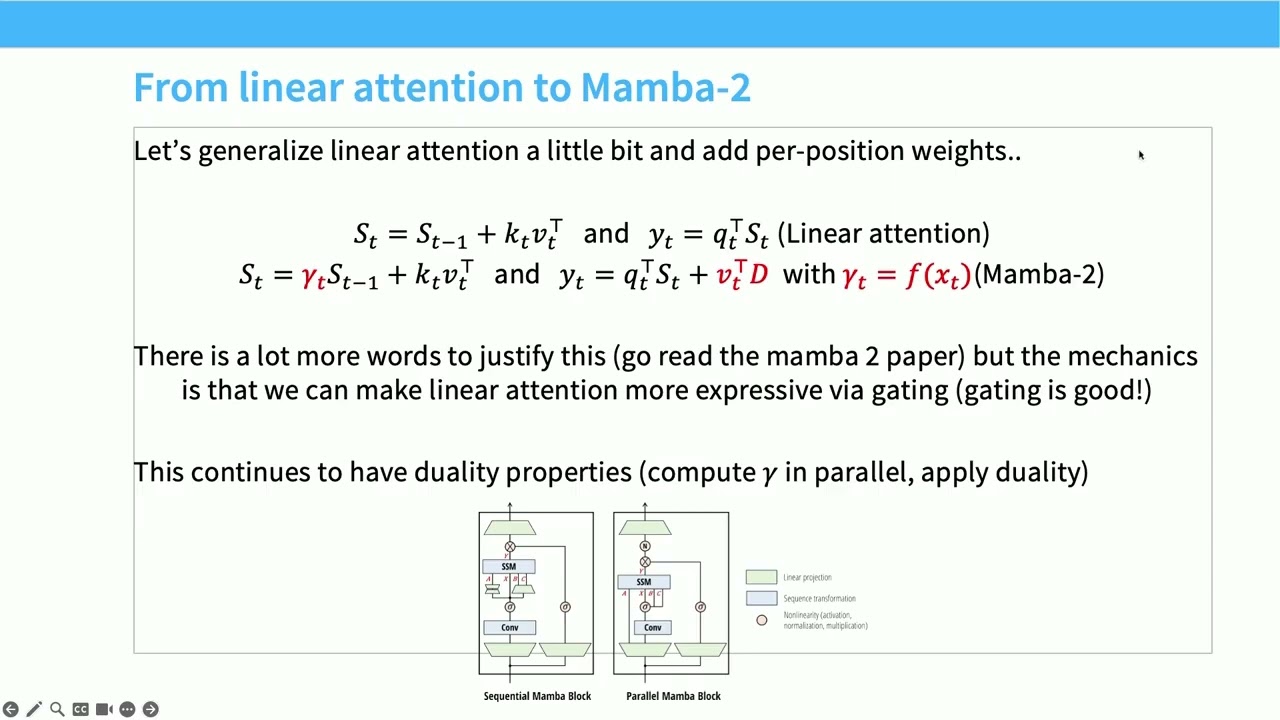
有了 RNN 视角,下一步的改造方向自然浮现。你可能嫌线性注意力"太朴素太简单,我想要更严肃、更复杂的神经网络"。看着线性注意力的 RNN 形式,一个小小的加工就能得到更有表达力的更新——这就是 Mamba 2。
Mamba、Mamba 2(现在还有 Mamba 3)是 Albert Gu、Tri Dao 等人的状态空间模型(state space models,SSM)家族,最初从状态空间理论推导而来。但 Tatsu 强调:看它实际的运算机制,Mamba 2 可以被理解为线性注意力的一个非常简单的加工。思路是:线性注意力的主要问题在于状态永远无条件往前传。LSTM 时代的老经验告诉我们,知道什么时候传递信息、什么时候不传(遗忘、清零)非常重要。受此启发,加一个门 $\gamma_t$:
$$ S_t = \gamma_t \, S_{t-1} + v_t k_t^\top $$$\gamma_t$ 调节保留多少历史状态进入未来。关键的设计约束是:$\gamma_t$ 不是 stateful 的——它只依赖当前输入 $x_t$,完全不依赖状态。状态相关的项只有那些 $S$;$\gamma$ 与状态无关,所以计算很简单,而且对偶性保住了:Mamba 2 项既可以算成一个大的稠密矩阵乘(训练),也可以在推理时用递归形式(推理提速)。
(Mamba 2 完整式子里还有一个 $D v_t$ 修正项,本质是给 $y_t$ 更新加了一个残差层。Tatsu 特意说明他把它写进来只是为了"给出真正的 Mamba 2 更新式"而非删减版,它不是状态更新的核心,可以先忽略。)
由此他总结出一条贯穿本节的经验法则:只要 RNN 里各项的门控只依赖输入、不依赖状态,就能保持"并行训练形式 / 串行推理形式"的美妙对偶。后面的方法都在这条红线内活动。
实战检验:NVIDIA Nemotron 3(上一讲简单提过)用 Mamba 2 作为轻量层,隔一段插一层大的 softmax attention,用各种交替方式管理"推理成本 vs 表达力"的权衡。Nemotron 3 性能与 Qwen 3 thinking、GPT-OSS 相当,且由于大量 Mamba 2 层,在相当大的上下文长度下吞吐很好。Tatsu 的措辞很克制:“至少这些是小型 frontier 模型——不是真正的大 frontier 模型,但是开源的小 frontier 模型——你能看到它确实 work。”
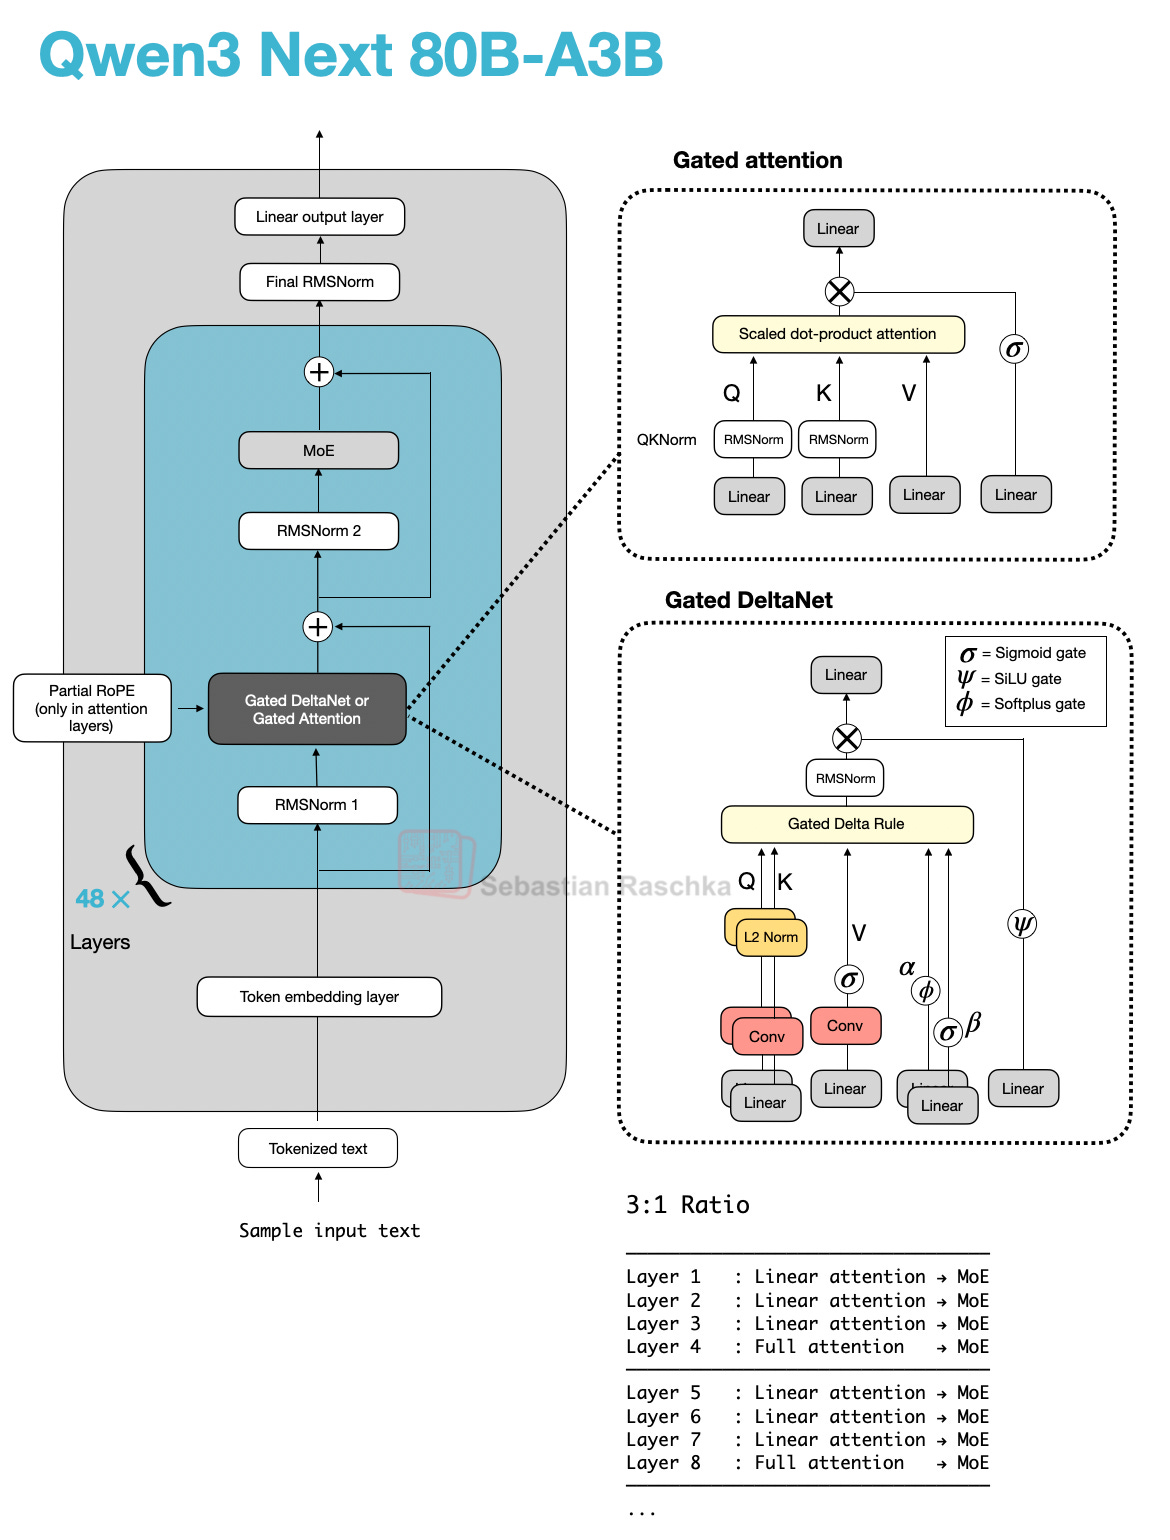
2.4 Gated DeltaNet:再加一个门,外加"写入前先擦除"
继续推:能不能把这个 recurrence 做得越来越复杂?只要守住"门控只依赖输入"的红线就行。Gated DeltaNet 大概是目前使用最广的状态空间类模型——在相当多论文里被测试过,并且在 Qwen 3.5 里有一次非常漂亮的大规模 scale-up。
对照 Mamba 2 讲它的两处改动:
第一处:第二个门 $\beta_t$。 Mamba 2 是拿 $\gamma_t$ 门控线性递归;Gated DeltaNet 再加一个 $\beta_t$,Tatsu 称之为 “no input operation” 门:$\beta_t = 0$ 意味着"完全不要把当前信息写进状态"。熟悉 LSTM 的人会立刻觉得眼熟——遗忘门控制是否忘掉历史,输入门控制是否写入当前时间步——两者运作原理非常相似,尽管推导出身完全不同。
第二处(来自 DeltaNet 本身,而非 Gated 部分):更新方向。 引入 $\beta_t$ 时本可以简单地用 $1 - \beta_t$ 之类的凸组合,但 DeltaNet 做的是投影:
$$ S_t = S_{t-1} \, \gamma_t \left( I - \beta_t k_t k_t^\top \right) + \beta_t \, v_t k_t^\top $$直觉是:我正要用当前的 key $k_t$ 往状态里写入信息;写入时不仅要放入新信息,还要擦除以前沿这个 key 写进去的旧内容。蓝色那一项 $(I - \beta_t k_t k_t^\top)$ 本质上是一个投影算子(projector),把状态中 $k_t$ 方向上的分量投影掉。Tatsu 提醒这不完全严格(没有做单位归一化),但直觉大致如此——写入即覆盖,先清再写。
还有一个耐人寻味的注脚:这个投影式更新在多个完全不同的研究传统中被各自独立地重新发明过——求解某类元学习最小二乘问题时会自然出现它;fast weight programming 和 test-time training 领域的研究者从截然不同的设计原则出发,最终得到了一模一样的解。殊途同归,往往是"这东西是对的"的信号。
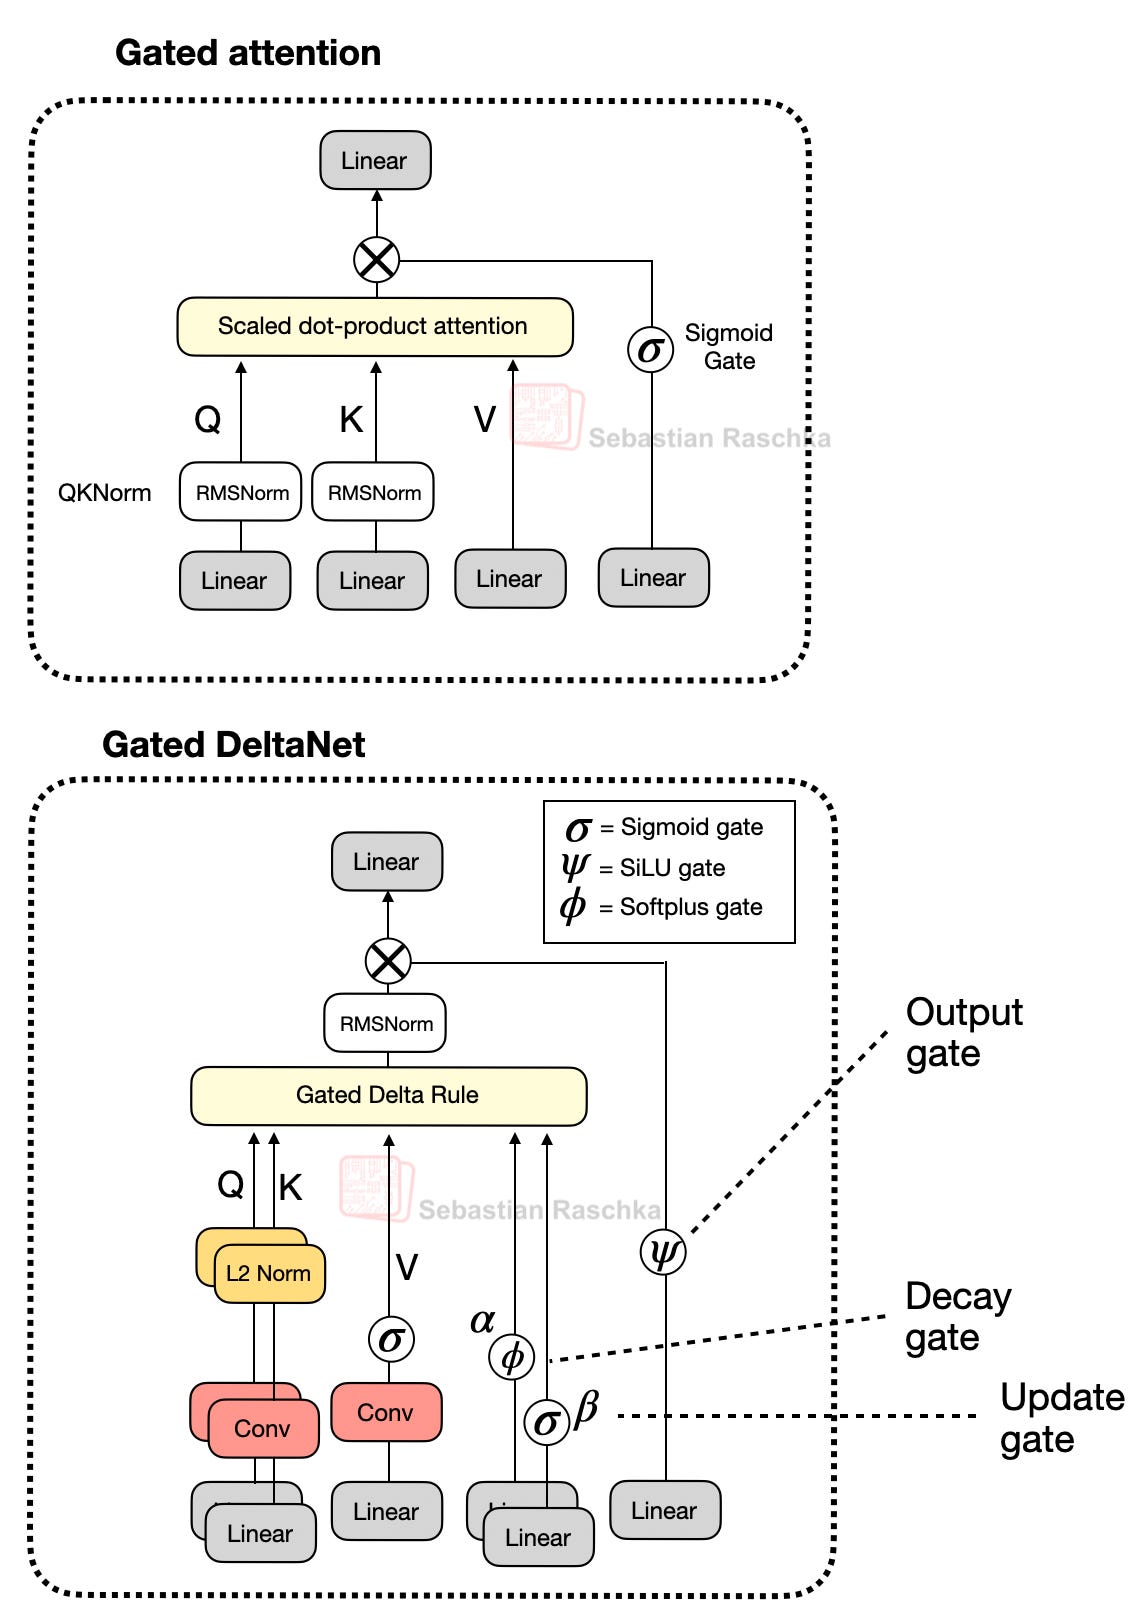
实战检验:Qwen 3.5 及其前身 Qwen3-Next——当今最好的开源模型之列——用的正是这套架构:3:1 的 Gated DeltaNet 与 attention 混合。推理特性非常强:随着上下文越拉越长,Qwen-Next 的解码吞吐相对 Qwen 3 大幅领先;与各家闭源模型和上一代模型的性能对比显示,混合架构几乎不伤性能。
2.5 混合比例的代价曲线
混合到什么比例才不伤性能?Tatsu 坦言这方面优质的受控研究不多,他引用了大概唯一的一个:ByteDance Seed 与 UC Santa Cruz 合作的系统性对比(对多种架构——Mamba 2、Gated DeltaNet 及其他——横扫不同的混合层数比例)。结果"有点乱",但他指出了值得看的东西:
- 图中的虚线是完整 attention 的性能基准;横轴从左到右是非完整 attention 层(“RNN 层”)占比的增加;
- 对最好的那批架构(图中黄、橙、蓝色,即 Gated DeltaNet 及各种变体),低混合比例下基本没有性能损失;
- 超过某个临界点后,长上下文性能开始出现明显退化;
- 走到最右端的纯 RNN 极端,所有架构都出现非常显著的性能退化。
各类评测里故事一致。Tatsu 提醒一个解读陷阱:single-key retrieval(单键检索)这类任务上各家长上下文架构都显式优化过,不太能区分好坏;但看 QA 性能,同样的故事清楚浮现——混合比例越高,性能相当稳定地持续下降,最终落到纯 RNN 的低点。
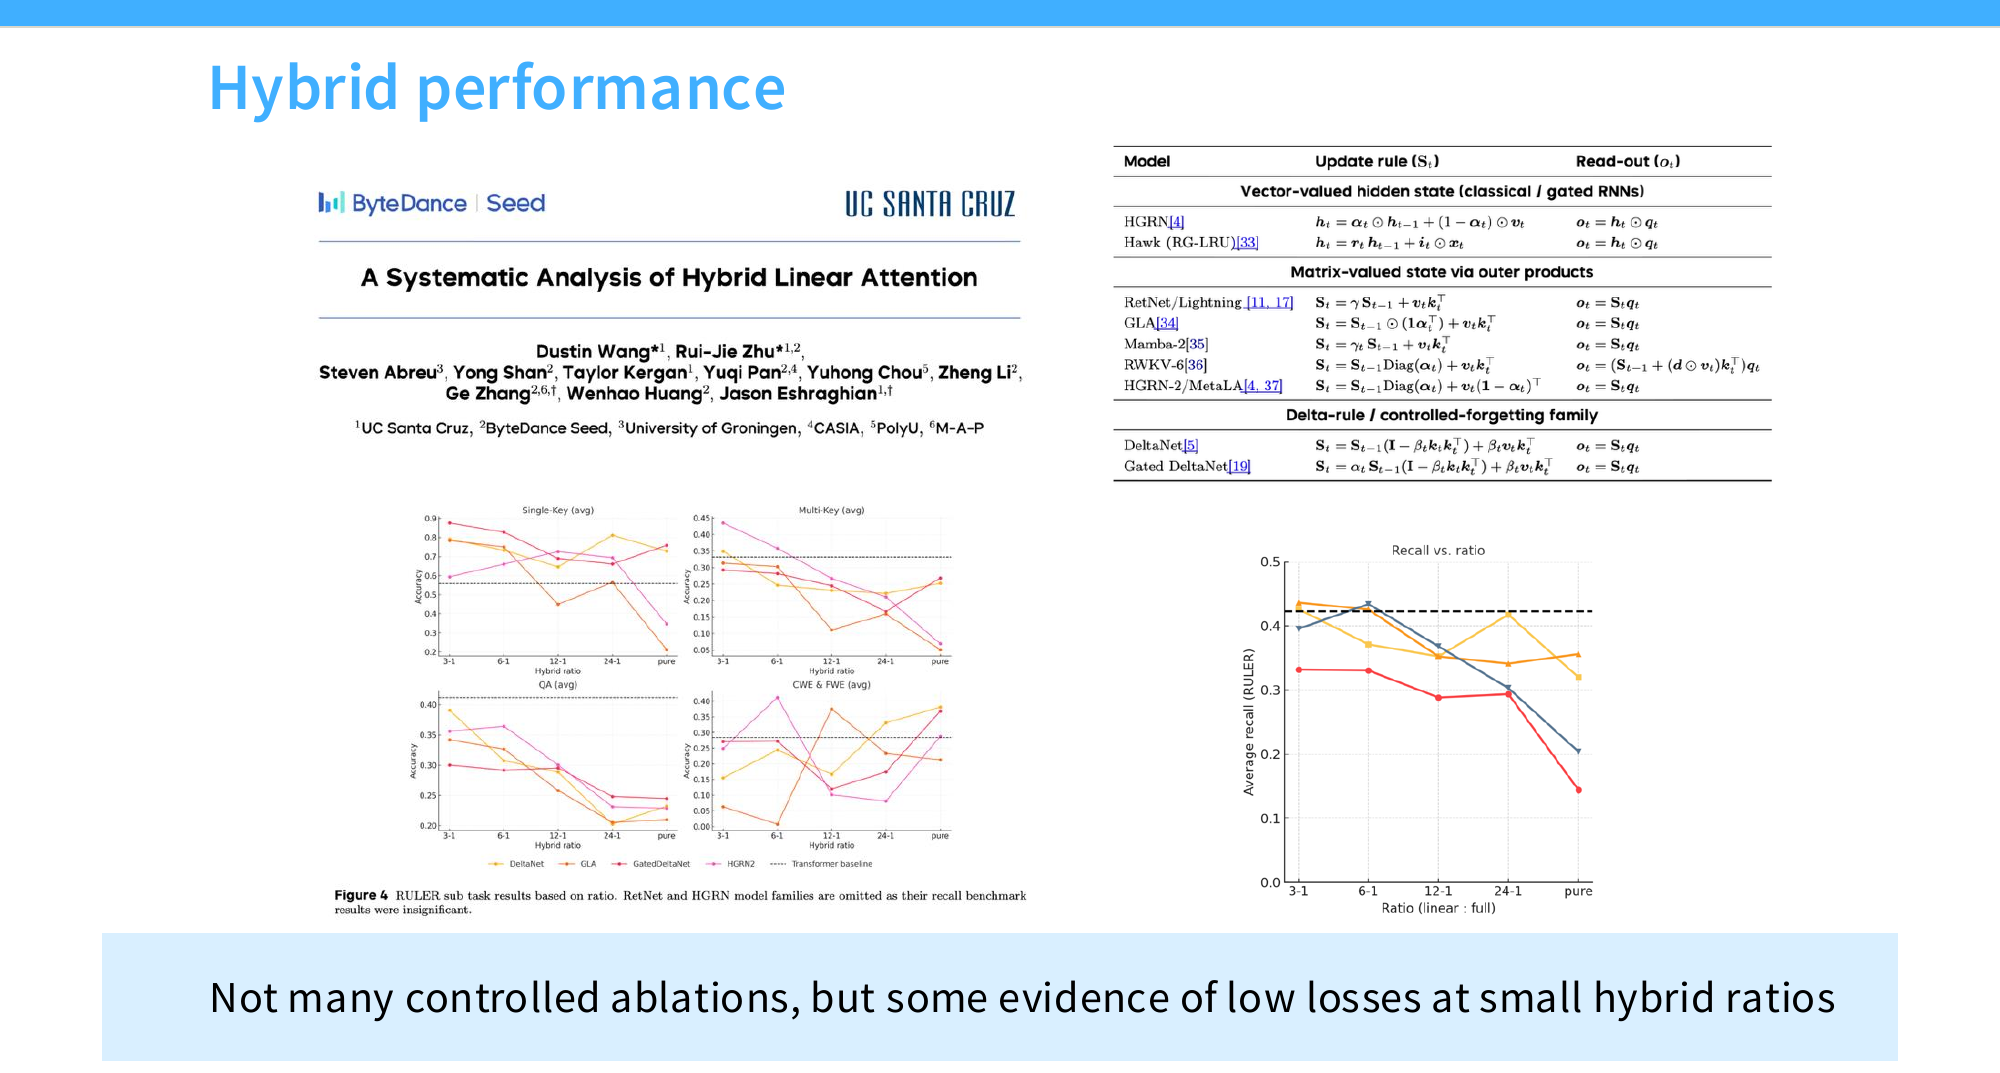
这解释了为什么生产模型清一色选择 3:1 到 7:1 这类混合,而不是全线性。讲义这一页还顺带补了两条正文没有的信息。第一,横轴的五个刻度是 3:1、6:1、12:1、24:1 和纯线性——生产模型选的 3:1(Qwen 3.5)和 7:1(MiniMax M1)恰好落在最左边那一两档、也就是几乎不掉点的区间;而平均 RULER recall 从基线的约 0.42 一路掉到纯线性端的 0.14-0.35,跌幅最大的正是不带 delta rule 的那几条曲线。第二,右上那张更新式对照表把本节讲到的所有方法放进了同一个坐标系,分成三族:向量状态(HGRN、Hawk/RG-LRU 这类经典门控 RNN,状态 $h_t$ 是向量)、外积得到的矩阵状态(RetNet/Lightning、GLA、Mamba-2、RWKV-6、HGRN-2/MetaLA,状态 $S_t$ 由 $v_t k_t^\top$ 累积)、以及 delta rule / 可控遗忘族(DeltaNet、Gated DeltaNet)——第三族与第二族的全部区别,就是那个 $(I - \beta_t k_t k_t^\top)$ 投影项。
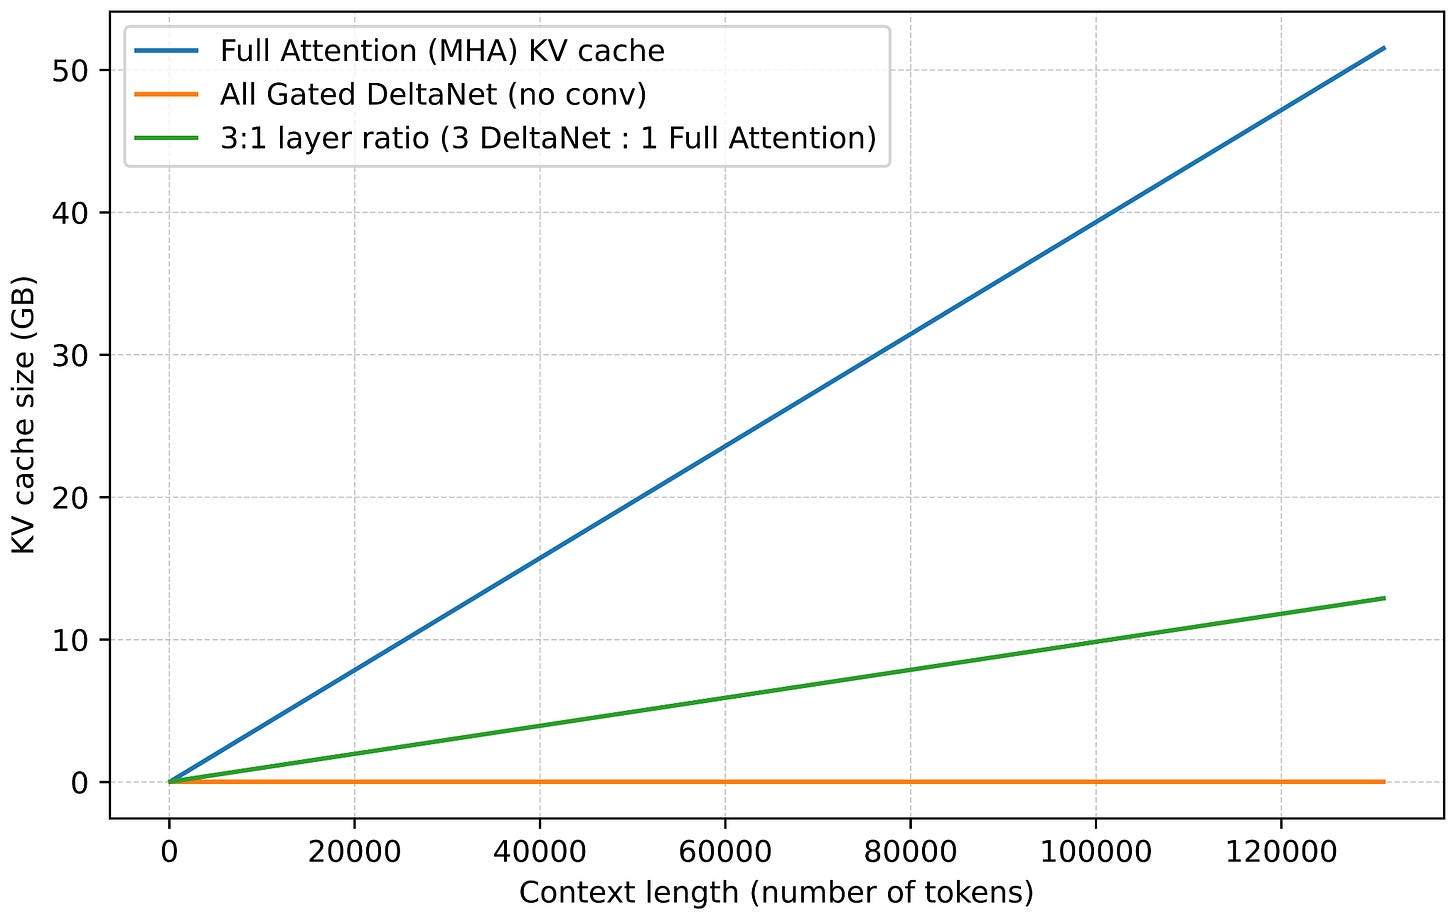
线性注意力部分收尾时 Tatsu 给了一个观察:真正被大规模验证过的方法,几乎都有这种简洁的、线性注意力风格的递归形式(有少数例外);这一整个领域在很大程度上收敛到了非常 LSTM 风格的对象。
3. 另一条路:DeepSeek 的稀疏注意力 DSA
3.1 机制:先索引,再选择,再做完整 attention
线性注意力有很漂亮的复杂度理论气质;但还有一个完全不同的效率化路线也很重要。DeepSeek 在 V3.2 中提出了 DSA——Tatsu 顺口开了个玩笑:DSA 是 DeepSeek Sparse Attention 而不是 “do sparse attention”,然后说 “instead of computing attention… oh, that was not intentional pun”(无意的双关)。
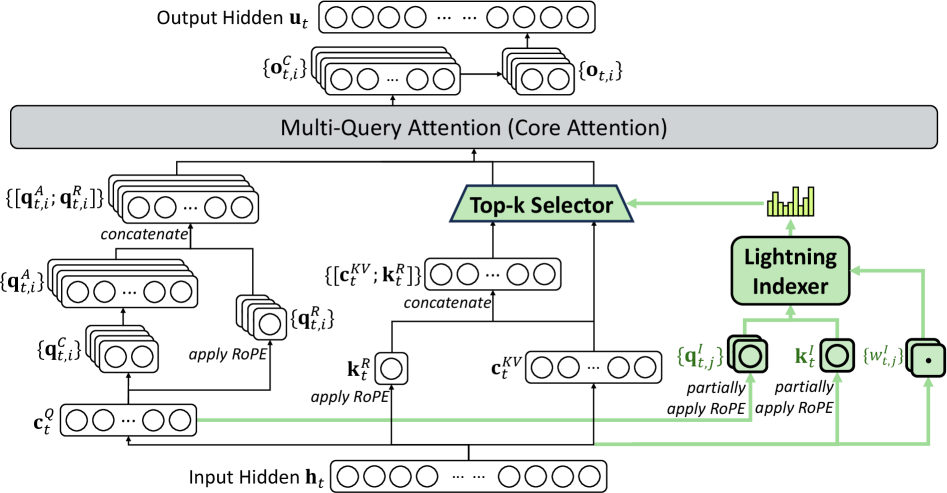
思路:不对所有 token 做 attention。第一步,一个轻量的 lightning indexer(闪电索引器)扫一遍很长的上下文,从中挑出一个远小于全序列的子集;第二步,在这个小子集上做完整的 softmax attention。
前向机制并不复杂:拿正常的 Q、K,送进 indexer——indexer 取 QK 内积、过 ReLU、再用从前文 token 推导出的权重 $w$ 加权,得到每个位置的激活分数;然后做 top-k,把分数最高的若干位置纳入 attention 计算;最后照常做 attention 输出 key-value。因为选择极度稀疏,只要 indexer 足够轻量,下面那步昂贵的完整 attention 就只作用在很小的子集上。
3.2 惊人的工程决策:indexer 是事后"栓上去"的
DSA 和 GLM 的工作共同展示了一件事:不需要从头带着 indexer 训练——带着这个 indexer 做预训练"可能相当烦人、非常复杂"。做法是:先正常训练一个 Transformer;到长上下文扩展阶段(long context extension)才把 lightning indexer 装进去,在一个独立于预训练的扩展阶段里训练模型去适应它。这样做的额外计算成本本身相当轻。
课堂问答把这个流程钉得更清楚。有学生问这是不是 continued pre-training 的一部分——Tatsu:对,所有模型都不会从头训长上下文(出于算力等原因),标准流程是短上下文预训练 → 长上下文扩展 → 后训练。既然第二阶段反正要做,为什么不把长上下文的成本优化也在同一阶段"栓上去"(bolt on)?他坦言这事能成挺出人意料的——“你居然能事后栓上这么一个看起来很吓人的、不可微的 top-k 对象”——然后埋了个伏笔:“看完下半场你也许就不会那么怕 top-k 选择了。“另一个学生问 top-k 的 K 与短上下文长度是否相当——是的,K 会选在接近短上下文性能的量级,并且无论输入多长,K 都是有界的。
3.3 实战检验:DeepSeek V3.2 与 GLM 5
DeepSeek V3.2 本身相当强:与同期 frontier 模型(Claude 4.5 Sonnet、Gemini 3)持平。论文里有一张很漂亮的图:prefill(对输入的 attention)和 decode(实际生成)的成本曲线,相对没用稀疏注意力的上一代 DeepSeek 都显著更优——只对很小的子集做 attention,成本自然大降。
一个很好的正交验证是 GLM 5(Tatsu 评价:目前最好的开源模型之一,“period”)。GLM 5 也采用了 DSA,且论文里有相当不错的消融:对比"DSA + warm-up”、“直接 DSA”、“完全不用 DSA”,主要结论是完整的 DSA 训练相对全 attention 几乎无损——即使在那些 RNN 风格架构很难搞定的长上下文检索任务上。
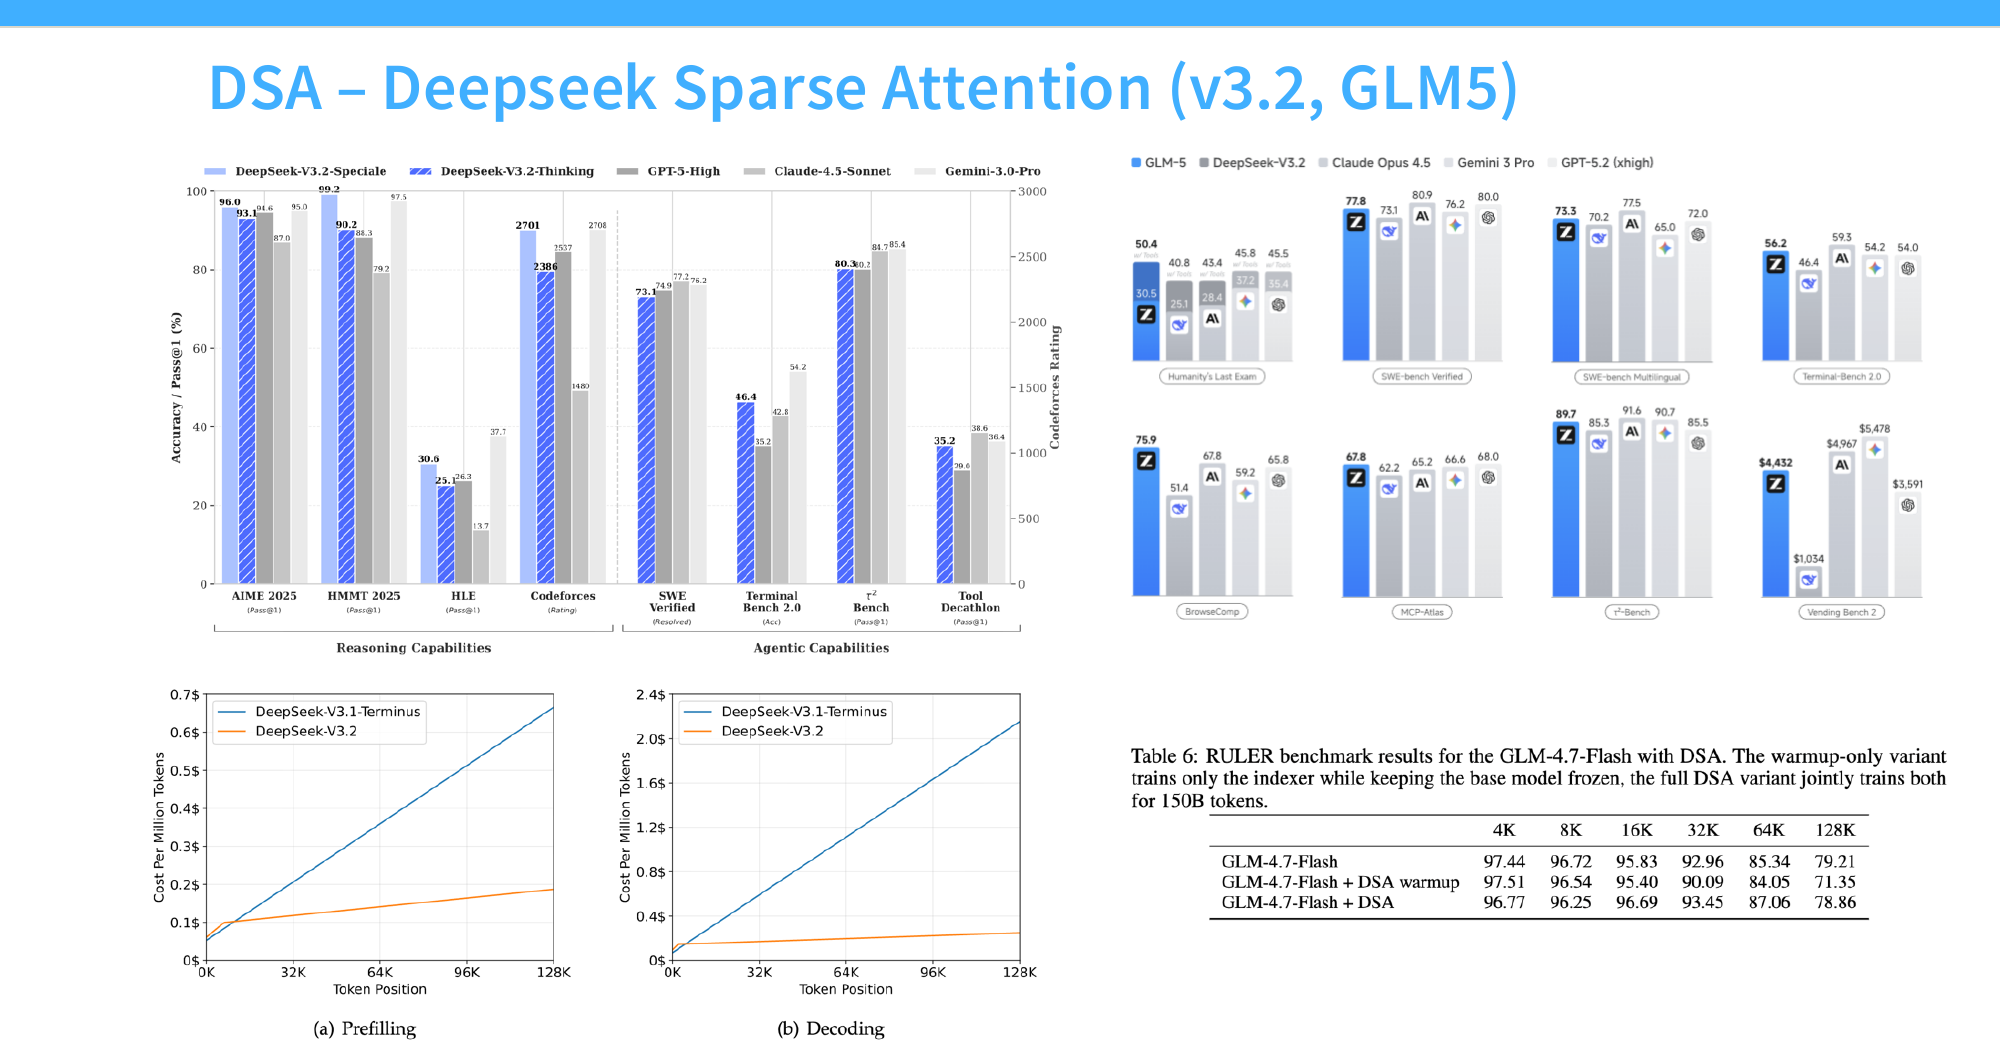
讲义把上面这两张"很漂亮的图"的数字都摊开了。先看成本曲线(左下):在 128K token 位置上,上一代 DeepSeek-V3.1-Terminus 的 prefill 成本约 $0.67 / 百万 token**,V3.2 只要约 **$0.19;decode 的差距更夸张,V3.1-Terminus 约 $2.15** 而 V3.2 约 **$0.25,接近一个数量级。值得注意的是两条曲线在 8K 附近才交叉——短上下文时 V3.2 反而略贵(indexer 的常数开销要先摊掉),上下文够长才赚得回来。基准侧,DeepSeek-V3.2 拿到 AIME 2025 96.0、HMMT 2025 99.2、Codeforces 2701、SWE Verified 73.1,确实与同期 frontier 模型同台。
GLM 的消融(右下 Table 6)则是最硬的证据。三行分别是原始 GLM-4.7-Flash、只训 indexer 而冻住底座的 warm-up 变体、以及 indexer 与底座联合训练 150B token 的完整 DSA,六个上下文长度上的 RULER 分数:
| 变体 | 4K | 8K | 16K | 32K | 64K | 128K |
|---|---|---|---|---|---|---|
| GLM-4.7-Flash(全注意力) | 97.44 | 96.72 | 95.83 | 92.96 | 85.34 | 79.21 |
| + DSA warm-up(仅训 indexer) | 97.51 | 96.54 | 95.40 | 90.09 | 84.05 | 71.35 |
| + DSA(联合训练 150B token) | 96.77 | 96.25 | 96.69 | 93.45 | 87.06 | 78.86 |
“几乎无损"的量化含义就在这张表里:完整 DSA 在 16K / 32K / 64K 上甚至超过了全注意力基线(96.69 vs 95.83、93.45 vs 92.96、87.06 vs 85.34),128K 上也只差 0.35 分。而只做 warm-up、不联合训练的那一行在 128K 上掉到 71.35,比基线低了近 8 分——indexer 必须和底座一起训,光把它栓上去冻住不动是不够的。
3.4 课堂问答集:复杂度、精度与未来
DSA 部分的问答环节信息量很大,值得逐条记下:
Q: indexer 的时间复杂度? A: 二次。要知道选谁,就得看所有位置——QK 内积是实打实的 brute force,这里没有什么巧妙的状态转移。Q: 那后面那步也是二次的,效率从哪来? A: “这几乎是个系统性的技巧。” indexer 可以做得非常轻量:更低精度、把 Q/K 再投影到更低维度专供索引用、把 $w$ 做得很小——常数因子极好;第二步虽然是二次的,但作用在 top-k 选出的短得多的序列上,K 可控。“又是那句话:别太纠结二次还是不二次,有时候常数因子才是真正重要的。”
Q: 去掉 softmax 会有训练稳定性问题吗? A: 没有见过文档记录的此类问题。“要说的话,softmax 通常才是各种问题的来源”——去掉它反而可能改善架构的稳定性。
Q: FP4 attention 可行吗? A: indexer 的设计部分正是被这类想法驱动的。FP4 attention 肯定可能,但 softmax 里小的上溢/下溢会真正造成麻烦。所以”用低精度做选择,再用全精度做计算"(value 向量可以更精细地加权求和)是讲得通的路线;目前还没有很好的办法在 FP4 或更低精度上做完整 attention。
Q: 未来的注意力机制长什么样? A: Tatsu 自嘲给了个 cop-out 答案:大概率是"把所有这些技巧都扔进去”——就像架构本身就是靠吸收所有成功配方而变复杂的。另外还有更高一层:用 post-training 让模型自己管理上下文(compaction、检索等),这些本质上是架构之上的附加层,未来的大量工作会是这些层的整合。线性注意力那边已经高度收敛到 LSTM 式/线性注意力式的架构,短期内不会大变。
Q: 与 Transformer 相比,状态空间模型的缺点到底是什么?训练更复杂吗?(“总得有缺点,否则所有人都……")A: 缺点是表达能力。softmax attention 的 all-to-all 连接极其强大,而且很好训练。过去 attention 相对 LSTM 的最大优势是硬件效率(可并行训练);SSM 之所以能翻红,是因为线性注意力揭示的对偶性让"RNN 形式 ↔ 稠密矩阵乘形式"可以互换,计算效率这一格已经被勾掉了。但还剩一个权衡:有限大小的状态要背着整个上下文往前走,相对"什么都留着"必然丢信息。Q: 状态大小和上下文的关系? A: 要把状态大小和上下文长度放在一起想:如果状态和上下文一样大,那当然什么都不丢,但你就在付巨大的代价。没有免费午餐的点在于:想要很小的状态,就很难把大上下文的信息全压进去。 也许有一天能没有权衡,但目前权衡就体现在这里。
4. 下半场:Mixture of Experts
4.1 什么是 MoE:一个更高效的 MLP
Tatsu 给 MoE 的定位很谦逊:概念上它不改变游戏规则。一种理解方式是:MoE 就是有人递给你一个更高效的 MLP,仅此而已。但他给出两个必须学它的理由:其一,现在所有人都在发 MoE、所有人都在 ship MoE——想深入理解语言模型,就必须懂它;其二,MoE 有一些非常有趣的机械构件,一旦看过 MoE 的原语(top-k 选择、辅助损失),你会在很多别的地方认出它们,并意识到"原来神经网络还能这么玩”。
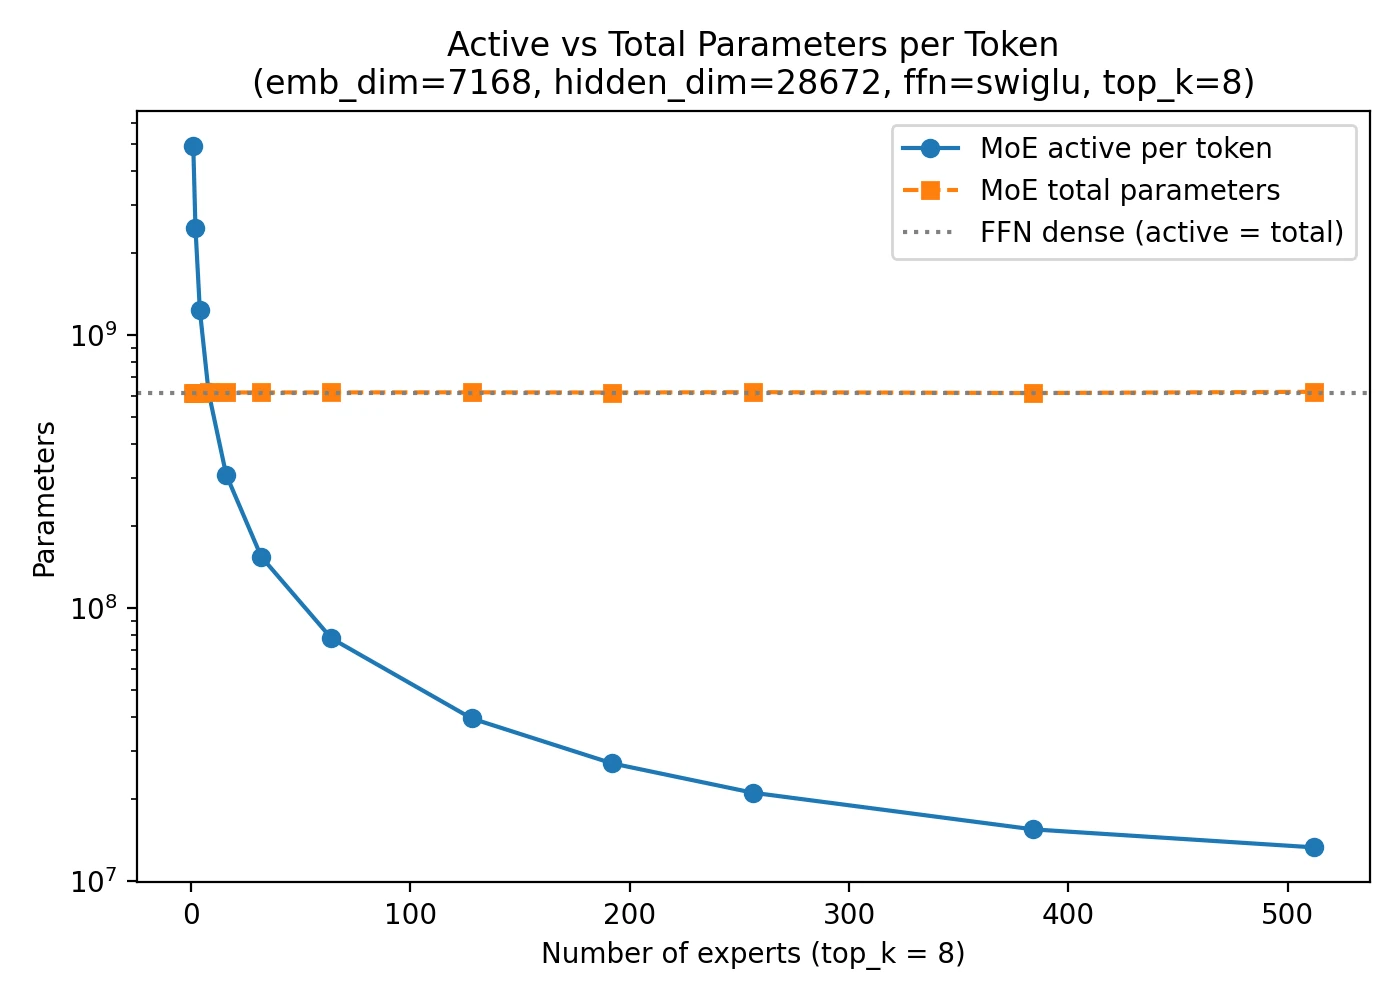
MoE 是什么?左边是常规 Transformer:attention、归一化,然后一个 feed-forward——大量稠密信息处理发生的地方。现在把这个大 FFN 切成多个小 FFN——或者干脆不切小,就复制四个和原来一样大的 FFN——然后假设有个魔法系统告诉你每个输入该用哪个 FFN。这样一来:FFN 参数变成了 4 倍,但任何一次前向/反向传播只付一份 FFN 的计算代价。这就是该有的心智模型:在不影响 FLOPs 的前提下增加参数。读最早的 MoE 论文会发现它们的出发点就是这种"参数中心视角":“假设你就是想要更多参数,因为你相信参数多是好事——好,那如果不想付相应代价,你就需要右边这个东西。”
为什么这么流行? 因为经验事实是:保持总计算量不变、只增加稀疏参数,模型就是会变好——这也算支持"参数多确实普遍是好事,哪怕一次只激活一部分"这一观点的证据。Google 的 Switch Transformer(Fedus et al. 2022)的图:激活参数不变、专家数增加,语言建模测试 loss 单调下降、下降、再下降;右图从训练角度看,同样的训练算力下专家越多性能越好——训练和推理两头都是免费的胜利。同样的现象被反复看到:AI2 的 OLMoE(开源 MoE 分析与训练论文)里,无论看训练 loss、验证 loss 还是下游基准,MoE 都比对应 dense 模型好——大约两倍速达到同等水平。
Proof is in the pudding:看实际发布的模型,以激活参数衡量(这正是推理 FLOPs 关心的),MoE 全面强于 dense 模型——其实按训练和服务的全部成本(all-in cost)算也是。DeepSeek V2 和更早的 DeepSeek MoE 出来时,相对当时大家训练的一众 dense 模型是一次真正的转折:激活参数少得多,MMLU 却不输甚至更好。
还有一个系统级理由:MoE 提供了又一根并行化的轴。LLM 太大,单设备无论训练还是推理都装不下,所以你需要尽可能多的方式来切分模型。MoE 的专家天然就是一块块的 chunk,可以放到不同设备上,再把激活路由过去——这叫 expert parallelism(专家并行),三讲之后的并行化课程会展开。数据并行受 batch size 上限约束,模型并行受自然切点数量约束;多一根可优化的轴,在大规模训练/服务里非常值钱。
产业格局:西方的大型开源 MoE 有 Llama 4 和 OpenAI 的 GPT-OSS,都是一线水准,但"西方的开源模型发布基本上停滞了";MoE 研究和训练的主要行动都发生在中国——Qwen、DeepSeek,还有 MiniCPM 等,做了最早一批训练和普及 MoE 的工作。早期的 Qwen 1.5 MoE 用 2.7B 激活参数打过当时的许多 7B 模型;DeepSeek 和 Qwen 的这些早期 proof of work 说服了整个开源社区:“这条路是对的。”
那为什么流行得这么慢? Google 2022 年就在研究和力推 MoE,但直到 2024 年之后才真正铺开;做 LLM 研究的人也大多还在用 dense 模型。原因是 MoE 带来大量复杂性:基础设施非常复杂;专家难以高效并行(利用率难打满);参数太多、单设备放不下;训练途中"MoE 真的会在你面前爆炸"(几页之后见分晓)。现在有了不错的经验法则,但它仍然不是好伺候的对象。
Tatsu 用一页顺带提到:也有人对 attention block 做 MoE 化,有若干论文,但远不常见——比起替换 FFN/MLP 层,attention 专家难驯服得多。所有大模型做的都是左边那种(FFN 替换),没有人把 attention head 切成专家。
课堂问答(本节):
- Q: 专家并行不会有通信瓶颈吗? A: 会。你要付"把激活运过去"的通信成本。后面会展示一个降低它的技巧,但本质上是权衡:换来更多聚合 FLOPs、更低内存占用,代价是通信。是否净赚高度依赖网络拓扑等因素。
- Q: 训练的时候呢? A: “这是最重要的部分”——训练时也是稀疏的,这正是 MoE 难的根源(提前剧透了几页后的关键思想):如果训练时激活全部专家,事情就简单了——你能看到哪个专家对这个输入好,自然学得会路由。难就难在训练时只有 1 个或 K 个专家激活,其余专家发生了什么你不知道,却必须学会路由。“这问题有很浓的 RL / bandit 味道。但我们不用 RL 也不用 bandit 来解——我们用启发式和深度学习魔法的力量。”
- Q: 专家切换的粒度? A: token 级。每个 token 选自己的专家。而且路由器超级天真——就是输入和权重的单次矩阵乘。不会有"这是个医学问题"这种理解,顶多是"这个 token 看起来像日语,送 7 号专家"。
- Q: 并行化有没有上限? A: 有。设备越切越多,通信成本爆炸。作业里会让你处理这个:给定网络拓扑设计切分方案(或反过来)。
Tatsu 还专门给 DeepSeek 说了一段好话:这节课的最初版本就是"带读一篇 DeepSeek 论文"。DeepSeek 长期做扎实的架构和 LLM 科学工作,是最早系统性论证 MoE 为什么好的团队之一,早期 DeepSeek MoE 论文里有大量优秀的消融——用 dense 层会怎样?hash 路由呢?switch 路由呢?——对架构设计感兴趣的人应该去读。V3、V3.2、GLM 等一路把 MoE 做成了强模型;可预见的未来(至少几年内),大模型就是 MoE 的天下。
4.2 设计轴一:路由函数
怎么设计一个 MoE?Tatsu 给出三根变化轴:路由函数、专家的尺寸/数量配比、训练方法。所有情况下我们都不想激活全部专家,所以总要选某种 top-k。
谁选谁? 三种可能:token choice(每个 token 挑自己喜欢的专家)、expert choice(每个专家挑自己喜欢的 token)、或一个复杂的全局路由器统筹优化分配。几乎所有 MoE 用的都是 token choice top-k。OLMoE 的对照实验:token choice 的验证 loss 更低、下游基准分更高。expert choice 也有成功案例、也能正常训练,但 token choice 一直好驯服得多,是今天所有模型的标准。(Tatsu 补刀:Llama 4 系列里好像有一个是 expert choice——“我印象里是某个未发布的 Llama 4 模型,这算不上强背书。")
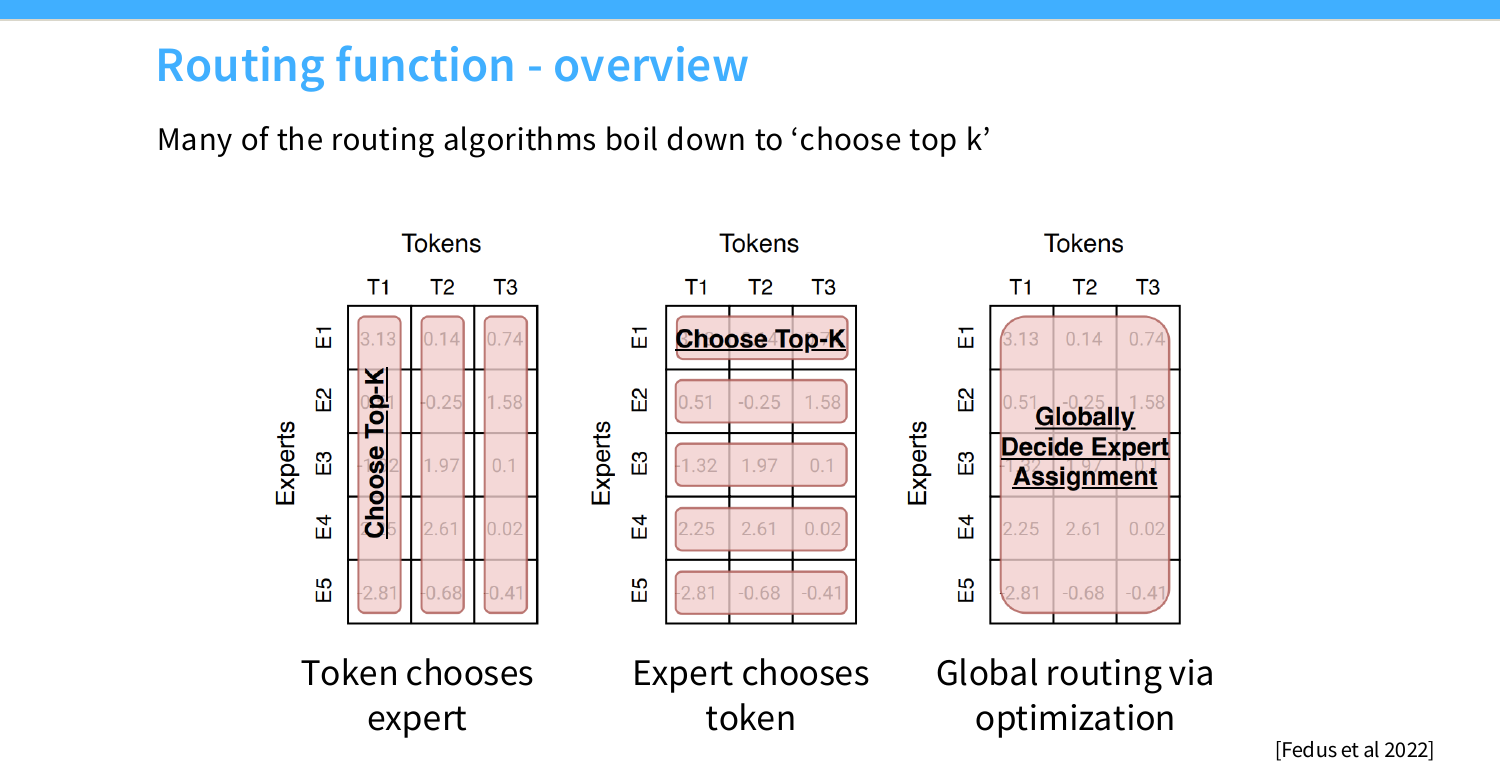
路由函数的家族,按现实中的地位排序:
- 学习式内积路由(绝对主流):每个专家有一个向量方向,与输入做内积,内积空间里最近的入选。经典 Switch Transformer 和 GShard(两篇早期 Google 论文)就是它;Grok、Mistral、DBRX、DeepSeek 等全在用。K 的取值各家不同,但本质都是取内积。(讲义 p29 把具体取值列了出来:Switch Transformer k=1,GShard、Grok、Mixtral k=2,Qwen、DBRX k=4,DeepSeek k=7。)
- 哈希路由(神秘的 baseline):不学习,直接把输入 $x$ 哈希到某个 FFN。让 Tatsu 一直觉得神秘的是:这居然也行,有时还有增益——不如 top-k,但作为论文里的常见 baseline 一直活着。出于诸多现实原因不用于部署。
- RL 学路由:把路由器当策略,用强化学习去学。“如果你是经典学习理论出身的人,这应该是最自然的想法:我在 N 选 K,观察不到未选的——这是 bandit 问题,我该用 bandit/RL 算法。” 最早期的工作(Bengio 2013)确实这么干。但它不是常见做法:RL 带来的算法开销和随机性太大,而人们已经摸出一套启发式配方,能让最简单的 top-k 路由直接 work——没有理由再上更复杂的东西。
- 线性分配问题(理论最优雅):全局计算"token i 分给专家 j 有多好"的两两分数,然后精确求解最优分配。Tatsu 说"作为一个喜欢讲道理的东西的人,我爱这个想法”;有工作证明它在某些场景有效,但从未在大规模上出现——相对其他方案太贵了。
top-k 路由的机制非常简单——而且如果你刚才在 DSA 那页认真听了,会发现这和 DSA 长得一模一样(读过 H-Net 等论文也会认出它,这是个值得会认的 pattern):输入 $u$ 过一个轻量投影得到分数 $s$(专家向量与输入的内积过 softmax),选 top-K 作为门 $g$,输出是残差项加上门控加权的各专家 FFN 输出。你唯一需要"学"的新东西就是门怎么来的——每个专家一个权重向量、和输入做内积,就这么轻量。
DeepSeek 的两个广为流传的改进(出自 DeepSeekMoE,现已成为事实标准):
- 细粒度专家(fine-grained experts):把原始大专家切成更小的块,同样参数预算下专家更多、路由组合更丰富;
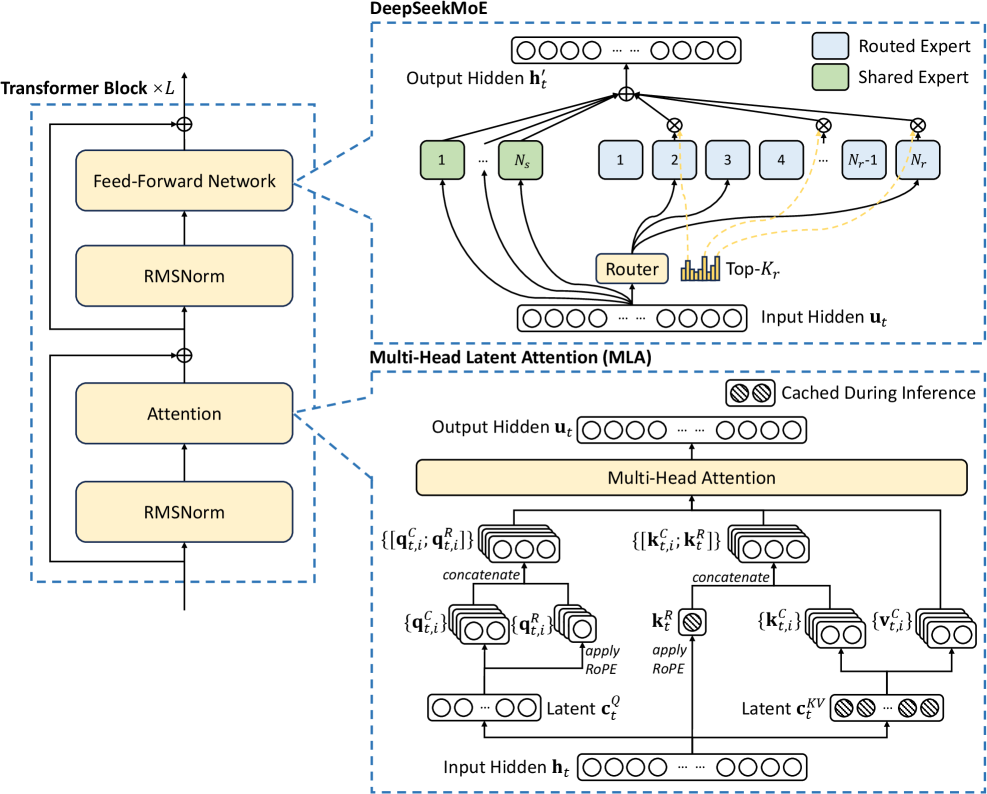
- 共享专家(shared experts):直觉是"有些非常通用的处理,你希望对所有 token 都做"——不是所有专家都该条件激活。于是把切细后的专家留出一部分设为绕过路由器、永远在线的共享专家,输出直接并回。这样原本每个路由专家里被重复学习的"公共建模"被集中卸载到共享专家里,让其余专家更彻底地特化。
DeepSeek 论文里的消融很漂亮:对比"0 个共享专家 + 16 个大路由专家"(这正是 Google 老 GShard 的设计)与"细粒度切分 + 1 个共享专家",两个干预都带来显著收益;共享专家在某些评测上改进特别大——TriviaQA、Natural Questions 上那条蓝到黄的差距就是共享专家的贡献。想要交叉验证可以看 OLMoE:这是西方做得最认真的受控 MoE 研究,结论是细粒度多专家有用,但共享专家帮助不大——两家在共享专家上存在真实分歧。不过从采用格局看:最早的三个 MoE 都出自 Google;Mistral、DBRX、Grok 是西方早期尝试;DeepSeek V1 同时提出细粒度 + 共享设计后,所有人都跟进了——Tatsu 类比说,这就像 dense Transformer 界的 Llama 设计成为标准一样,DeepSeek MoE / DeepSeek V3 就是 MoE 界的标准设计。看 Qwen 3.5、GLM 等现代模型,共享专家和细粒度专家仍在广泛使用,是非常 battle-tested 的设计。
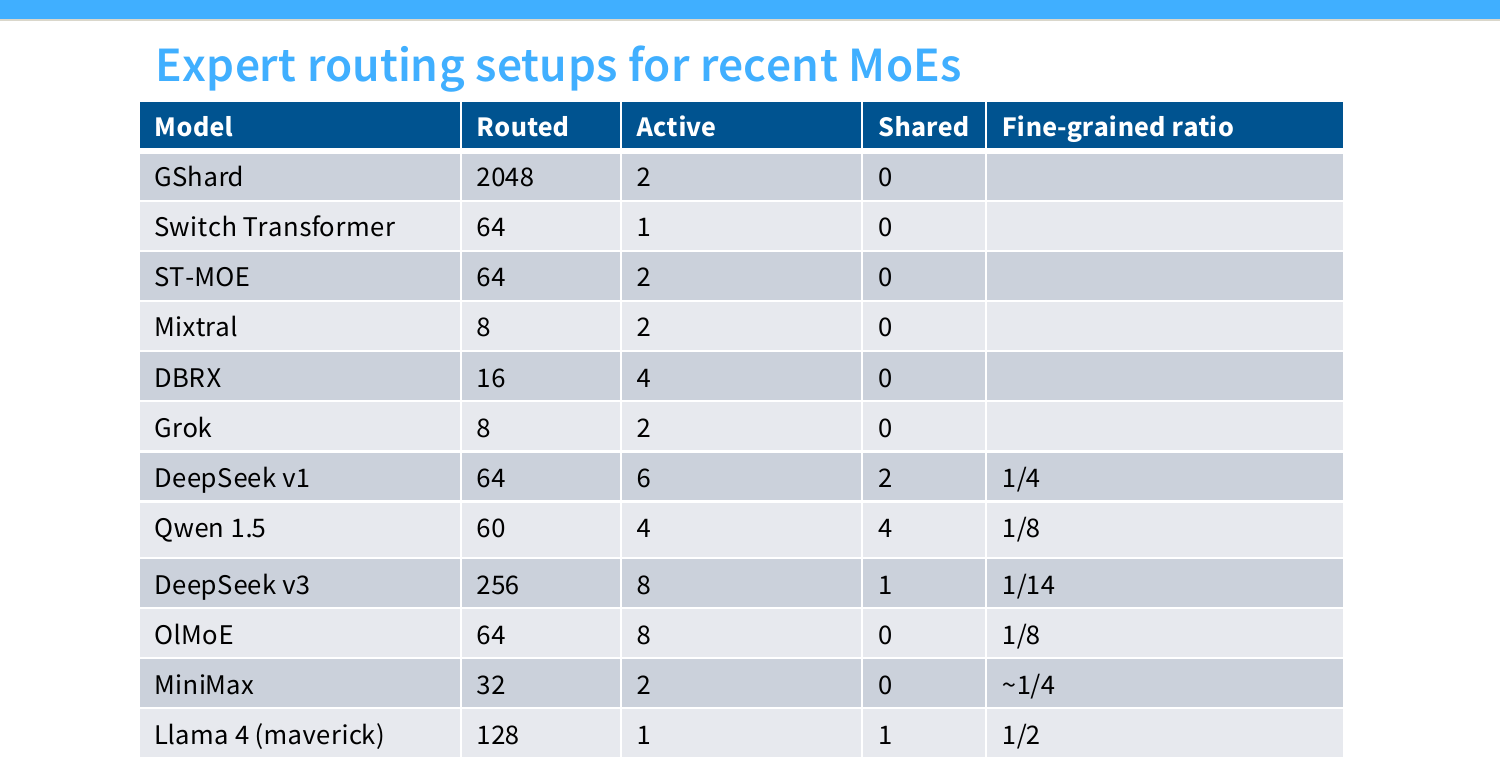
这张讲义自制的表把上面所有设计轴压成了一页数字,正文里没有的配置细节都在这里:
| 模型 | 路由专家数 | 激活数 | 共享专家 | 细粒度比 |
|---|---|---|---|---|
| GShard | 2048 | 2 | 0 | — |
| Switch Transformer | 64 | 1 | 0 | — |
| ST-MoE | 64 | 2 | 0 | — |
| Mixtral | 8 | 2 | 0 | — |
| DBRX | 16 | 4 | 0 | — |
| Grok | 8 | 2 | 0 | — |
| DeepSeek v1 | 64 | 6 | 2 | 1/4 |
| Qwen 1.5 | 60 | 4 | 4 | 1/8 |
| DeepSeek v3 | 256 | 8 | 1 | 1/14 |
| OLMoE | 64 | 8 | 0 | 1/8 |
| MiniMax | 32 | 2 | 0 | ~1/4 |
| Llama 4 (Maverick) | 128 | 1 | 1 | 1/2 |
三条趋势一目了然。共享专家的有无正好把新旧两代切开:GShard 到 Grok 这批西方早期 MoE 一个共享专家都没有,DeepSeek v1 之后(含 Qwen 1.5、Llama 4 Maverick)才普遍出现;OLMoE 那行的 0 共享专家也和上面提到的分歧对得上——它是有意不采用共享专家的。细粒度比一路走细:DeepSeek v1 是 1/4,Qwen 1.5 和 OLMoE 是 1/8,到 DeepSeek v3 已经切到 1/14。而激活数始终是个位数(1 到 8),无论总专家数是 8 还是 2048——这就是"参数变多、FLOPs 不变"最直白的体现。
课堂问答:共享专家怎么并行化?——没有并行化节省可言:所有激活都必须过它。但可以把共享专家复制到各设备上,用内存换通信。
4.3 设计轴三:怎么训练一个不可微的东西
这是 MoE 最"深度学习玄学"的部分。Tatsu 自述初学 MoE 时觉得"这东西不可能训得好",但事实是一堆技巧组合起来"出于某种原因就是又好又稳"。
问题结构再明确一遍:训练时必须稀疏(否则付全部专家的 FLOPs,专家又那么多);但稀疏带来两个大问题——门控决策不可微,且看不到反事实(没被选中的专家如果被选会怎样,永远不知道)。三类解法:(1) RL 优化门控策略;(2) 随机扰动(explore-exploit 风格);(3) 一整套"处理稀疏门控 + 平衡专家流量"的奇怪启发式。“猜猜实践中用哪个?我一直在暗示了——是第三个。”
先讲两个没被采纳的,知道它们为什么输很有价值:
RL 路由:Clark 等人的研究试过用 RL 学路由(图中绿线是 REINFORCE 基线之一)。能 work,但由于梯度方差和复杂度,并不是最优解——连同一篇论文里提出的其他方法都能轻松打败 REINFORCE 梯度。
随机扰动:与 RL 思想接近、但开始滑向"写下目标函数试一试"的启发式世界。出自 Noam Shazeer 等人最早的 MoE 论文:训练时不做硬选择,而是在路由内积 $H$ 上注入与输入规模相关的噪声,然后照常 top-k + softmax。作用:两个专家势均力敌时,随机 tiebreak 选一个——反向传播时有用的专家会被强化、权重升高,扰动提供了一点探索空间,也让专家更鲁棒;softmax 让你学会给 K 个专家排序(加权组合而非硬选择)。Fedus et al. 2022(Switch Transformer)用的是类似的均匀乘性扰动,动机是"硬化"专家、增强鲁棒性。但后来的 Google 论文把这些都删了——后续消融显示,不做任何随机化探索技巧,反而对稳定性和最终 MoE 的整体质量都有帮助。结论:这些随机探索项并不必要。
于是来到实际做法——一系列启发式,核心是对付一个致命的正反馈。如果无视探索/利用问题直接正常梯度下降会怎样?被路由选中的 top-K 专家中最强的那个获得更多信号,反向传播说"这个专家好,加大它的权重",权重更强意味着更常被选中……rich gets richer,赢家通吃,最后少数专家跑赢一切、包揽所有 token。这个 **expert collapse(专家坍缩)/ expert starvation(专家饥饿)**现象非常真实,是启发式训练 MoE 必须解决的核心问题。
解法:往总建模损失里加一个负载均衡辅助损失(load balancing auxiliary loss)。以 Switch Transformer 的版本为例:
$$ \mathcal{L}_{\text{balance}} = \alpha \, N \sum_{i=1}^{N} f_i \, P_i $$$f_i$ 是实际派发给专家 $i$ 的 token 比例(硬统计),$P_i$ 是路由器分配给专家 $i$ 的总概率质量(软统计,$f$ 的可微版本)。Tatsu 承认这不是能从第一性原理推出来的东西,第一眼看不懂很正常。他给的理解钥匙是求导:对 $P_i$ 求导,导数正是 $f_i$——即这是一个梯度空间里的罚项:一个专家拿到的 token 比例越高,它的概率质量受到的负梯度就越大。整个损失的作用就是按流行度成比例地打压热门专家。“公式本身可能一开始不清楚,但一旦想清楚梯度的作用,它要干什么就很明白了。”
有了这些组件,就可以原样重构 DeepSeek V1/V2 的 MoE 系统:正常的语言建模损失,直接把梯度从选中的专家里穿过去(无视不可微性和探索问题),加上与 Switch Transformer 相同的 per-expert 均衡损失。但 DeepSeek 的系统嗅觉更进一步:他们还按设备做均衡。专家分布在多台机器上(这台四个专家、那台四个专家),你希望两台机器都满负荷运转——所以再加一个设备级均衡损失,函数形式一模一样,只是把"专家的比例"换成"每台设备的比例",纯粹为了利用率。到了 DeepSeek V3,他们改用每专家 bias 项 + 在线学习式调整来均衡专家,甩掉了一部分辅助损失(Tatsu 称之为"比较丑的那些")——但最终还是得加一些辅助损失来防止极端失衡。目前没有任何方案能完全摆脱它们。
能不能干脆不管负载均衡? 后果是灾难性的。OLMoE 做了直接把负载均衡损失移除的消融:有均衡损失是顶上那条粉线,曲线正常漂亮;移除之后 loss 显著变差。更能说明问题的是专家利用率图:没有负载均衡时,几乎所有 token 都涌向两个专家(图里的黄色和粉色专家),其余专家整个训练过程无所事事——等于白白扔掉了一大堆参数;有均衡损失时,尽管机制是启发式的,所有专家在 token 上均匀分担。
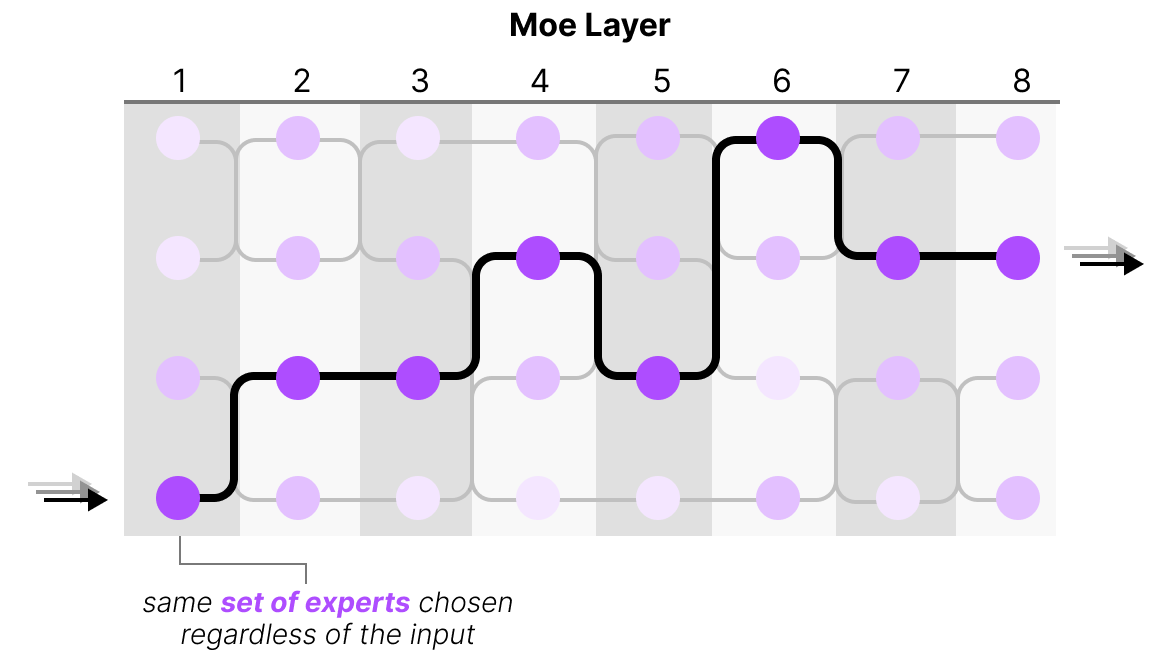
Tatsu 复盘时再次表达惊讶:一个含不可微 top-k 的复杂对象,你要做的全部就是加一个均衡损失把专家摊匀,剩下的当作梯度能直接流过去——模型就训练得很好。他的解释:两股动力学恰好对消——“有用的专家被正反馈强化"这个循环,被"把所有专家摊匀"的力量刚好平衡住。最后再点一次题:同样的技巧就用在 DSA 里(top-k 选 token),也用在 H-Net 里(尝试去掉 tokenizer 的工作)——“top-k 选择 + 用负载均衡等辅助损失兜住不可微性"会是未来架构设计的常备原料,你会越来越常见到它。
课堂问答:
- Q: 专家真的是"专家"吗?各管一个领域? A: 有论文可视化过哪些 token 激活哪些专家。因为路由器太简单,专家不可能是"聪明的专家”——没有医学专家、法律专家。你会看到某些 token 被固定路由:标点符号去一个专家、其他符号去一个专家、非英语字符集去另一个专家。但绝不是"这是华尔街日报专家"那种东西——没有语义(no semantics)。
- Q: 为什么专家级损失之外还要设备级损失? A: 原则上专家级均衡若被完美强制执行、且专家均匀分布在设备上,设备自然也均衡。但你不想把专家级损失的权重拉到产生完全均匀的程度——那会伤害训练动力学;而设备均衡重要到值得为它单独加一点额外损失。
4.4 系统侧:稀疏矩阵乘、通信技巧与 token dropping 轶事
MoE 与硬件的协同设计。标准并行化手段(数据并行:把数据切到多台机器;模型并行:把模型切开;两者组合)各有极限——batch size 到顶了数据并行就到顶了,模型的自然切点用完了模型并行也就到头了。专家并行提供了额外的轴。实现层面:一台 GPU 上放多个专家时,天真的做法是"很多次小矩阵乘”,这很不好——你想要能复用 cache 的大矩阵乘。正确做法是利用结构化稀疏:block diagonal(块对角)是最基本的形式,硬件原生支持更复杂的结构化稀疏乘法,让"专家 × 输入"以非常干净、非常快的方式完成。MoE 的计算模式几乎天然对应硬件里易于高效支持的结构化矩阵乘——这是一种正在发生的硬件-架构协同设计。
通信优化(Nemotron 3 的新技巧)。专家并行必须把激活运到专家所在设备,通信开销可观。思路:共享专家不需要通信,可以保持大维度;而要跨设备发送的路由专家激活,希望它是更小的低维向量——所以先把残差流降维投影,再发起 collective communication,通信量大幅下降,又不必承担全局缩小隐藏维度的代价。用投影技巧精细控制"通信 vs 并行化"的权衡。
一则已成历史的轶事:token dropping 与随机性。天真的 MoE 基础设施下,除非专家在输入分布上完美均衡,否则总有些专家特别热门。假设 0 号专家人气爆棚,它的 token 队列越堆越长,最终系统说"队列太长了,我得开始丢 token"。早期一代 MoE 推理基础设施的做法是静默丢弃:直接返回一个零向量,装作什么都没发生。这导致非常诡异的随机性:别的用户的请求如果撞上了你在用的专家,可能把你挤出专家队列,你就拿到更差的结果。如今的 dropless 架构(MegaBlocks 等常用开源 MoE 框架)已经根治了这个问题。
4.5 稳定性与微调
稳定性。上一讲的教训:指数不好,除法不好,所以 softmax 是稳定性危险区。而 MoE 干了什么?在路由里又引入了一个 softmax。Google 早期 MoE 设计团队(Barrett Zoph 等)专门写过一整篇 MoE 稳定性论文,这是他们注意到的问题之一。常见解法你会经常见到:只对 expert router 用 float32 计算这类敏感部件;以及加 Z-loss(上一讲讲过的、抑制 softmax logits 幅度的辅助损失——它其实在早期就被广泛用于 MoE 路由器的稳定性)。OLMoE 对加/不加 router z-loss 做了消融:不加的训练 loss 曲线全是尖刺,加了明显平滑——“从这些非常 spiky 的曲线看,router 上的 z-loss 相当有帮助”。
微调。你最近要是用过语言模型大概有体感:MoE 微调起来挺烦人。参数太多,直接微调专家会严重过拟合:dense 模型微调下游任务(例子是 GLUE 里的某个任务)时 train/val 很接近;sparse 模型的 train/val 差距极大。对策有三层:(1) 只微调非 MoE 的 feed-forward;(2) 只微调 attention——这是 Tatsu 最近在 MoE 相关工作里最常见到的干预,Zoph 等人当年也是这么主张的;(3) “苦涩教训"版:上大数据——比如用 140 万条样本而不是你手头那点数据,数据够多时干脆在微调阶段把 MoE 整个重训一遍,泛化差距就没那么大了。
4.6 Upcycling:从 dense 模型"升级回收"出一个 MoE
最后一个 MoE 专属技巧:upcycling(升级回收)。Tatsu 说这个做法最近一年明显退潮——“今年我一个 upcycled 模型都没见到”——但想法很酷,早年也确实产出过一些好模型,所以值得一讲。
想法:想要 MoE?也许可以拿一个已经训好的 dense 模型来实例化它——把所有东西都复制过来,MLP 复制成 N 份专家,路由器随机初始化,然后接着训练。由于输入被随机路由到不同 MLP 的随机性,专家会开始自发分化特化,最终得到一个真正的 MoE。最早提出 upcycling 的论文显示:upcycle 一个 dense 模型,比继续训练同一个 dense 模型得到的语言建模精度好得多。
大规模验证:MiniCPM(Tatsu 点名喜欢,因为他们做大量认真的受控消融)把 2.4B 的 MiniCPM upcycle 成 13.4B 的 MoE,拿到一堆几乎免费的收益;Qwen 从 1.8B 的 Qwen 初始化,upcycle 出 Qwen 1.5-MoE-A2.7B——最早的大规模 upcycling 成功案例之一,当时的高性能模型。
为什么退潮?因为现在没人先训 dense 再转换了——反正要训,hero run 直接从头训 MoE 就好。但它仍属于 MoE 的完整动作空间,应该知道。
4.7 收官:DeepSeek V1 → V2 → V3 的演化
最后 Tatsu 带大家把 DeepSeek 三代模型走了一遍——“从 DeepSeek 模型的演化里能学到很多”,再次推荐直接读 DeepSeek 系列论文(写得好、细节值得挖)。
| 版本 | 规模与专家配置(讲义 p54-56) | MoE 设计 | 新增内容 |
|---|---|---|---|
| DeepSeek MoE (V1) | 16B 总参数 / 2.8B 激活;共享 2 + 细粒度 64(每个是原尺寸的 1/4) | 共享 + 细粒度专家、标准 top-k 路由、辅助均衡损失 | 现代 MoE 的原型——“MoE 的柏拉图理想型” |
| DeepSeek V2 | 236B 总参数 / 21B 激活;共享 2 + 细粒度 160(1/10 尺寸),6 个路由激活 | 同上规模化:2 个共享专家、多得多的细粒度专家 | 设备级路由均衡 + 通信均衡组件(同时均衡进和出两个方向的通信)+ top-M 设备路由——本质都是"用辅助损失优化系统”。Tatsu:成功的 LLM 训练不只是深度学习,还要真正尊重你的系统,V2 是这个哲学的体现 |
| DeepSeek V3 | 671B 总参数 / 37B 激活;共享 1 + 路由 256,8 个激活 | 保留共享 + 细粒度设计 | aux-loss-free 的 bias 均衡(在线调整)+ 序列级辅助损失;改用 sigmoid + softmax 的专家加权(topK + topM);其余大体沿袭 |
这三行的参数量和专家配置来自讲义 p54-p56(口述只提了设计变化、没念数字)。放在一起看,三代之间总参数涨了 42 倍(16B → 671B),激活参数只涨了 13 倍(2.8B → 37B)——激活占比从 17.5% 一路压到 5.5%,稀疏度的提升本身就是 DeepSeek 三代演化的主线之一。
既然讲到这了,顺带把 V3 剩下的两个组件也过了一遍(“我很欣赏他们思考系统的方式”):
MLA(multi-head latent attention):不从隐层直接生成 Q、K、V,而是先产出一个低维 latent 向量 $c$,再从 $c$ 展开出 Q、K、V。好处:KV cache 不再存 K 和 V,只需存低维的 $c$——这正是"latent"之名的由来,显存大省。唯一的复杂之处是它与 RoPE 在 KV cache 上冲突,需要小心处理维度旋转——技巧是留出不走 latent 的维度专门编码位置(细节课上不展开)。
MTP(multi-token prediction):不是预测一个未来 token,而是一次预测多个。统计上有论证(也许让模型更会预测未来);系统上有一个漂亮的说法——你等于内置了一个 speculative decoding(推测解码)器,可以用来给解码提速(Percy 讲推理时会展开)。Tatsu 认为这是个很酷的想法,但坦言它没怎么流行开。
总结:MoE 是一个非常聪明的想法——利用稀疏性,让你拥有"没付钱"的参数:不付全部参数的计算成本,却拿到参数量的好处。你可能一开始觉得路由问题很难,但事实是非常简单的东西在大规模上就是 work。MoE 已成定局(here to stay),所以你应该理解它是什么、怎么运作。
5. 方法论反思
这一讲两个半场其实反复敲打同一批元教训:
- 常数因子与渐近复杂度同样重要。这个主题出现了三次:FlashAttention 不改二次复杂度却改变了游戏;DSA 的 indexer 明明是二次的,靠"便宜的二次 + 有界的完整计算"打败了理论更漂亮的方案;MoE 的块稀疏矩阵乘赢在与硬件计算模式的契合。“别被 linear vs quadratic 绑架"是 Tatsu 对理论出身学生的反复提醒。
- 启发式配方战胜优雅理论。路由问题"正确"的建模是 bandit/RL(Bengio 2013 就这么做了),线性分配是"讲道理"的最优解,Shazeer 的噪声扰动是体面的 explore-exploit——但赢家是"top-k + 均衡损失 + 假装可微直接反传"这套 dirty tricks,因为它简单、稳定、够用,而且后来的消融证明那些体面的随机化机制甚至是有害的。
- top-k 选择 + 辅助损失正在原语化。同一个模式出现在 MoE 路由、DSA token 选择、H-Net 去 tokenizer 中。Tatsu 预测这对组合会是未来架构设计的常规构件——“你不必那么害怕 top-k 这种不可微的东西”。
- 表达能力与效率的权衡没有免费午餐。线性注意力的固定状态压缩不了任意长的上下文(所以所有生产系统都是混合架构,纯 RNN 端点全线退化);MoE 的稀疏激活换来了微调过拟合和基础设施复杂度。工程的艺术在于把损失控制在评测几乎测不出来的区间里。
- 架构创新与训练流程的解耦。DSA 在长上下文扩展阶段 bolt-on、MoE 靠 upcycling 从 dense 起步(虽已退潮)——重大架构改动未必要从预训练第一步就背上,这本身是一种降低试错成本的元策略。
6. 拓展阅读 / 参考资料
关键论文(按主题与时间线)
| 论文 | 时间 | 要点 | 链接 |
|---|---|---|---|
| Outrageously Large Neural Networks (Shazeer et al.) | 2017 | 现代 MoE 开山作,噪声 top-k 门控 | arXiv |
| Transformers are RNNs (Katharopoulos et al.) | 2020 | 线性注意力与 RNN 对偶性的奠基论文 | arXiv |
| GShard (Lepikhin et al.) | 2020 | Google 早期大规模 MoE 与专家并行 | arXiv |
| Switch Transformer (Fedus et al.) | 2021 | top-1 路由、负载均衡损失 $f_i P_i$ 的出处 | arXiv |
| Unified Scaling Laws for Routed Models (Clark et al.) | 2022 | 对比 RL/哈希/学习式路由的受控研究 | arXiv |
| ST-MoE (Zoph et al.) | 2022 | MoE 训练稳定性、router z-loss | arXiv |
| FlashAttention (Dao et al.) | 2022 | IO-aware 精确注意力,常数因子的胜利 | arXiv |
| Sparse Upcycling (Komatsuzaki et al.) | 2022 | dense checkpoint 升级为 MoE | arXiv |
| MegaBlocks (Gale et al.) | 2022 | dropless MoE、块稀疏矩阵乘 | arXiv |
| DeepSeekMoE (Dai et al.) | 2024-01 | 细粒度专家 + 共享专家设计的出处 | arXiv |
| DeepSeek-V2 | 2024-05 | MLA + 设备级均衡损失 | arXiv |
| Mamba-2: Transformers are SSMs (Dao & Gu) | 2024-05 | SSM 与线性注意力的结构化状态空间对偶 | arXiv |
| DeltaNet 并行化 (Yang et al.) | 2024-06 | delta rule 更新的序列并行训练 | arXiv |
| OLMoE (Muennighoff et al.) | 2024-09 | 全开源 MoE 受控消融(负载均衡/z-loss/共享专家) | arXiv |
| Gated DeltaNet (Yang, Kautz, Hatamizadeh) | 2024-12 | Mamba2 门控 + delta rule 结合 | arXiv |
| DeepSeek-V3 | 2024-12 | aux-loss-free 均衡、MLA、MTP 集大成 | arXiv |
| MiniMax-M1 | 2025-06 | 7:1 线性注意力混合的大规模验证 | arXiv |
| A Systematic Analysis of Hybrid Linear Attention (ByteDance Seed / UCSC) | 2025-07 | 72 个模型横扫六种线性注意力乘五档混合比例 | arXiv |
| DeepSeek-V3.2 | 2025-12 | DSA:lightning indexer + top-k 稀疏注意力 | arXiv |
| NVIDIA Nemotron 3 | 2025-12 | MoE + Mamba2 混合、通信前降维投影 | arXiv |
视频中引用的外部资源
- CS336 课程主页 — 课程日程、讲义 slides、作业
- 本讲官方讲义 lecture_04.pdf(60 页)
— 本笔记 6 张 slide 配图的出处,含 Tatsu 自制的"近期 MoE 专家配置"对照大表(p35)、DSA 实战数据汇总页(p13)和混合比例消融页(p11);Tatsu 主讲的各讲(3/4/5/8/9/11/15/16)均为 PDF,Percy 主讲的各讲则是可执行的
lecture_XX.py - Sebastian Raschka: Beyond Standard LLMs — 本笔记多张配图来源,系统梳理线性注意力混合架构(Qwen3-Next、Kimi Linear、Gated DeltaNet)
- Raschka: Gated DeltaNet from scratch — Gated DeltaNet 的从零实现与讲解
- MegaBlocks — dropless MoE 训练框架,块稀疏矩阵乘实现
关联主题
- FlashAttention 与 IO-aware 算法 : 本课系统讲(lecture 5 起)会深入,理解"FLOPs 不等于 runtime"的关键案例
- 状态空间模型 / Mamba : 从控制论的状态空间理论到深度学习序列模型的完整脉络
- 长短期记忆网络 LSTM : 门控思想的源头,Mamba 2 / Gated DeltaNet 的门在原理上是它的回声
- 多臂老虎机问题 : MoE 路由"只观察被选中专家"的问题结构,理解为什么理论上这是个 bandit 问题
- 推测解码 speculative decoding : MTP 内置加速器的原理,Percy 在推理系统讲会展开
- Test-time training / fast weight programming : 与 delta rule 更新殊途同归的研究传统,理解"同一个解被多个领域重新发明”
术语表
| 术语 | 含义 | 参考 |
|---|---|---|
| Linear Attention | 去掉 softmax 后利用结合律将注意力代价降为序列长度线性的机制 | arXiv |
| SSM (State Space Model) | 状态空间模型,用固定大小状态递归处理序列,Mamba 系列的理论出身 | Wikipedia |
| Gated DeltaNet | 带遗忘门与写入门、用 delta rule"先擦后写"更新状态的线性注意力变体 | arXiv |
| Delta Rule | 更新状态前先投影掉当前 key 方向的旧内容,即"写入即覆盖" | arXiv |
| DSA (DeepSeek Sparse Attention) | 轻量 indexer 打分 + top-k 选 token + 在子集上做完整注意力 | arXiv |
| Lightning Indexer | DSA 中给全部历史 token 打相关性分数的轻量组件,二次但常数极小 | arXiv |
| Prefill / Decode | 推理的两个阶段:对输入做注意力 vs 逐 token 生成 | arXiv |
| MoE (Mixture of Experts) | 将 FFN 复制为多个专家、路由器为每个 token 稀疏激活其中 k 个的架构 | Wikipedia |
| Token Choice / Expert Choice | 路由方向之争:token 挑专家(主流)vs 专家挑 token | arXiv |
| Shared Expert | 绕过路由器、对所有 token 常开的专家,集中学习公共处理 | arXiv |
| Fine-grained Experts | 把大专家切成更多小专家以丰富路由组合 | arXiv |
| Expert Collapse | 赢家通吃导致所有 token 涌向少数专家、其余专家死亡的训练病态 | arXiv |
| Load Balancing Loss | 惩罚热门专家的辅助损失 $\alpha N \sum_i f_i P_i$,梯度上按 token 比例打压概率质量 | arXiv |
| Router Z-loss | 抑制路由 softmax logits 幅度的稳定性辅助损失 | arXiv |
| Expert Parallelism | 把不同专家放到不同设备、把激活路由过去的并行化维度 | arXiv |
| Token Dropping | 专家队列溢出时静默丢弃 token 的早期实现缺陷,dropless 架构已解决 | MegaBlocks |
| Upcycling | 复制 dense 模型的 MLP 初始化 MoE 继续训练 | arXiv |
| MLA (Multi-head Latent Attention) | 先压缩成低维 latent 再展开 QKV,KV cache 只存 latent | arXiv |
| MTP (Multi-token Prediction) | 一次预测多个未来 token,内置 speculative decoding | arXiv |
| FlashAttention | IO-aware 的注意力重排实现,不改复杂度但大幅降低内存传输开销 | arXiv |
我的感想
(留空 — 看完后补充自己的理解、批判、联想)
待深入 / 疑问
- (记录不理解的地方、想进一步学习的方向)